

Observability-Übersicht
Opfield ersetzt den selbst gehosteten Monitoring-Stack. Node- und Container-Metriken, Container- und Routen-Logs, strukturierte Anwendungslogs, Alarmregeln, Benachrichtigungen und öffentliche Statusseiten sind integriert. Es gibt kein Prometheus, Grafana, Loki oder Alertmanager bereitzustellen, kein Dashboard zu bauen und kein separates Statuspage oder Uptime Kuma synchron zu halten: Jede Metrik, jedes Log und jede Statuskomponente ist bereits der Ressource zugeordnet, zu der sie gehört.
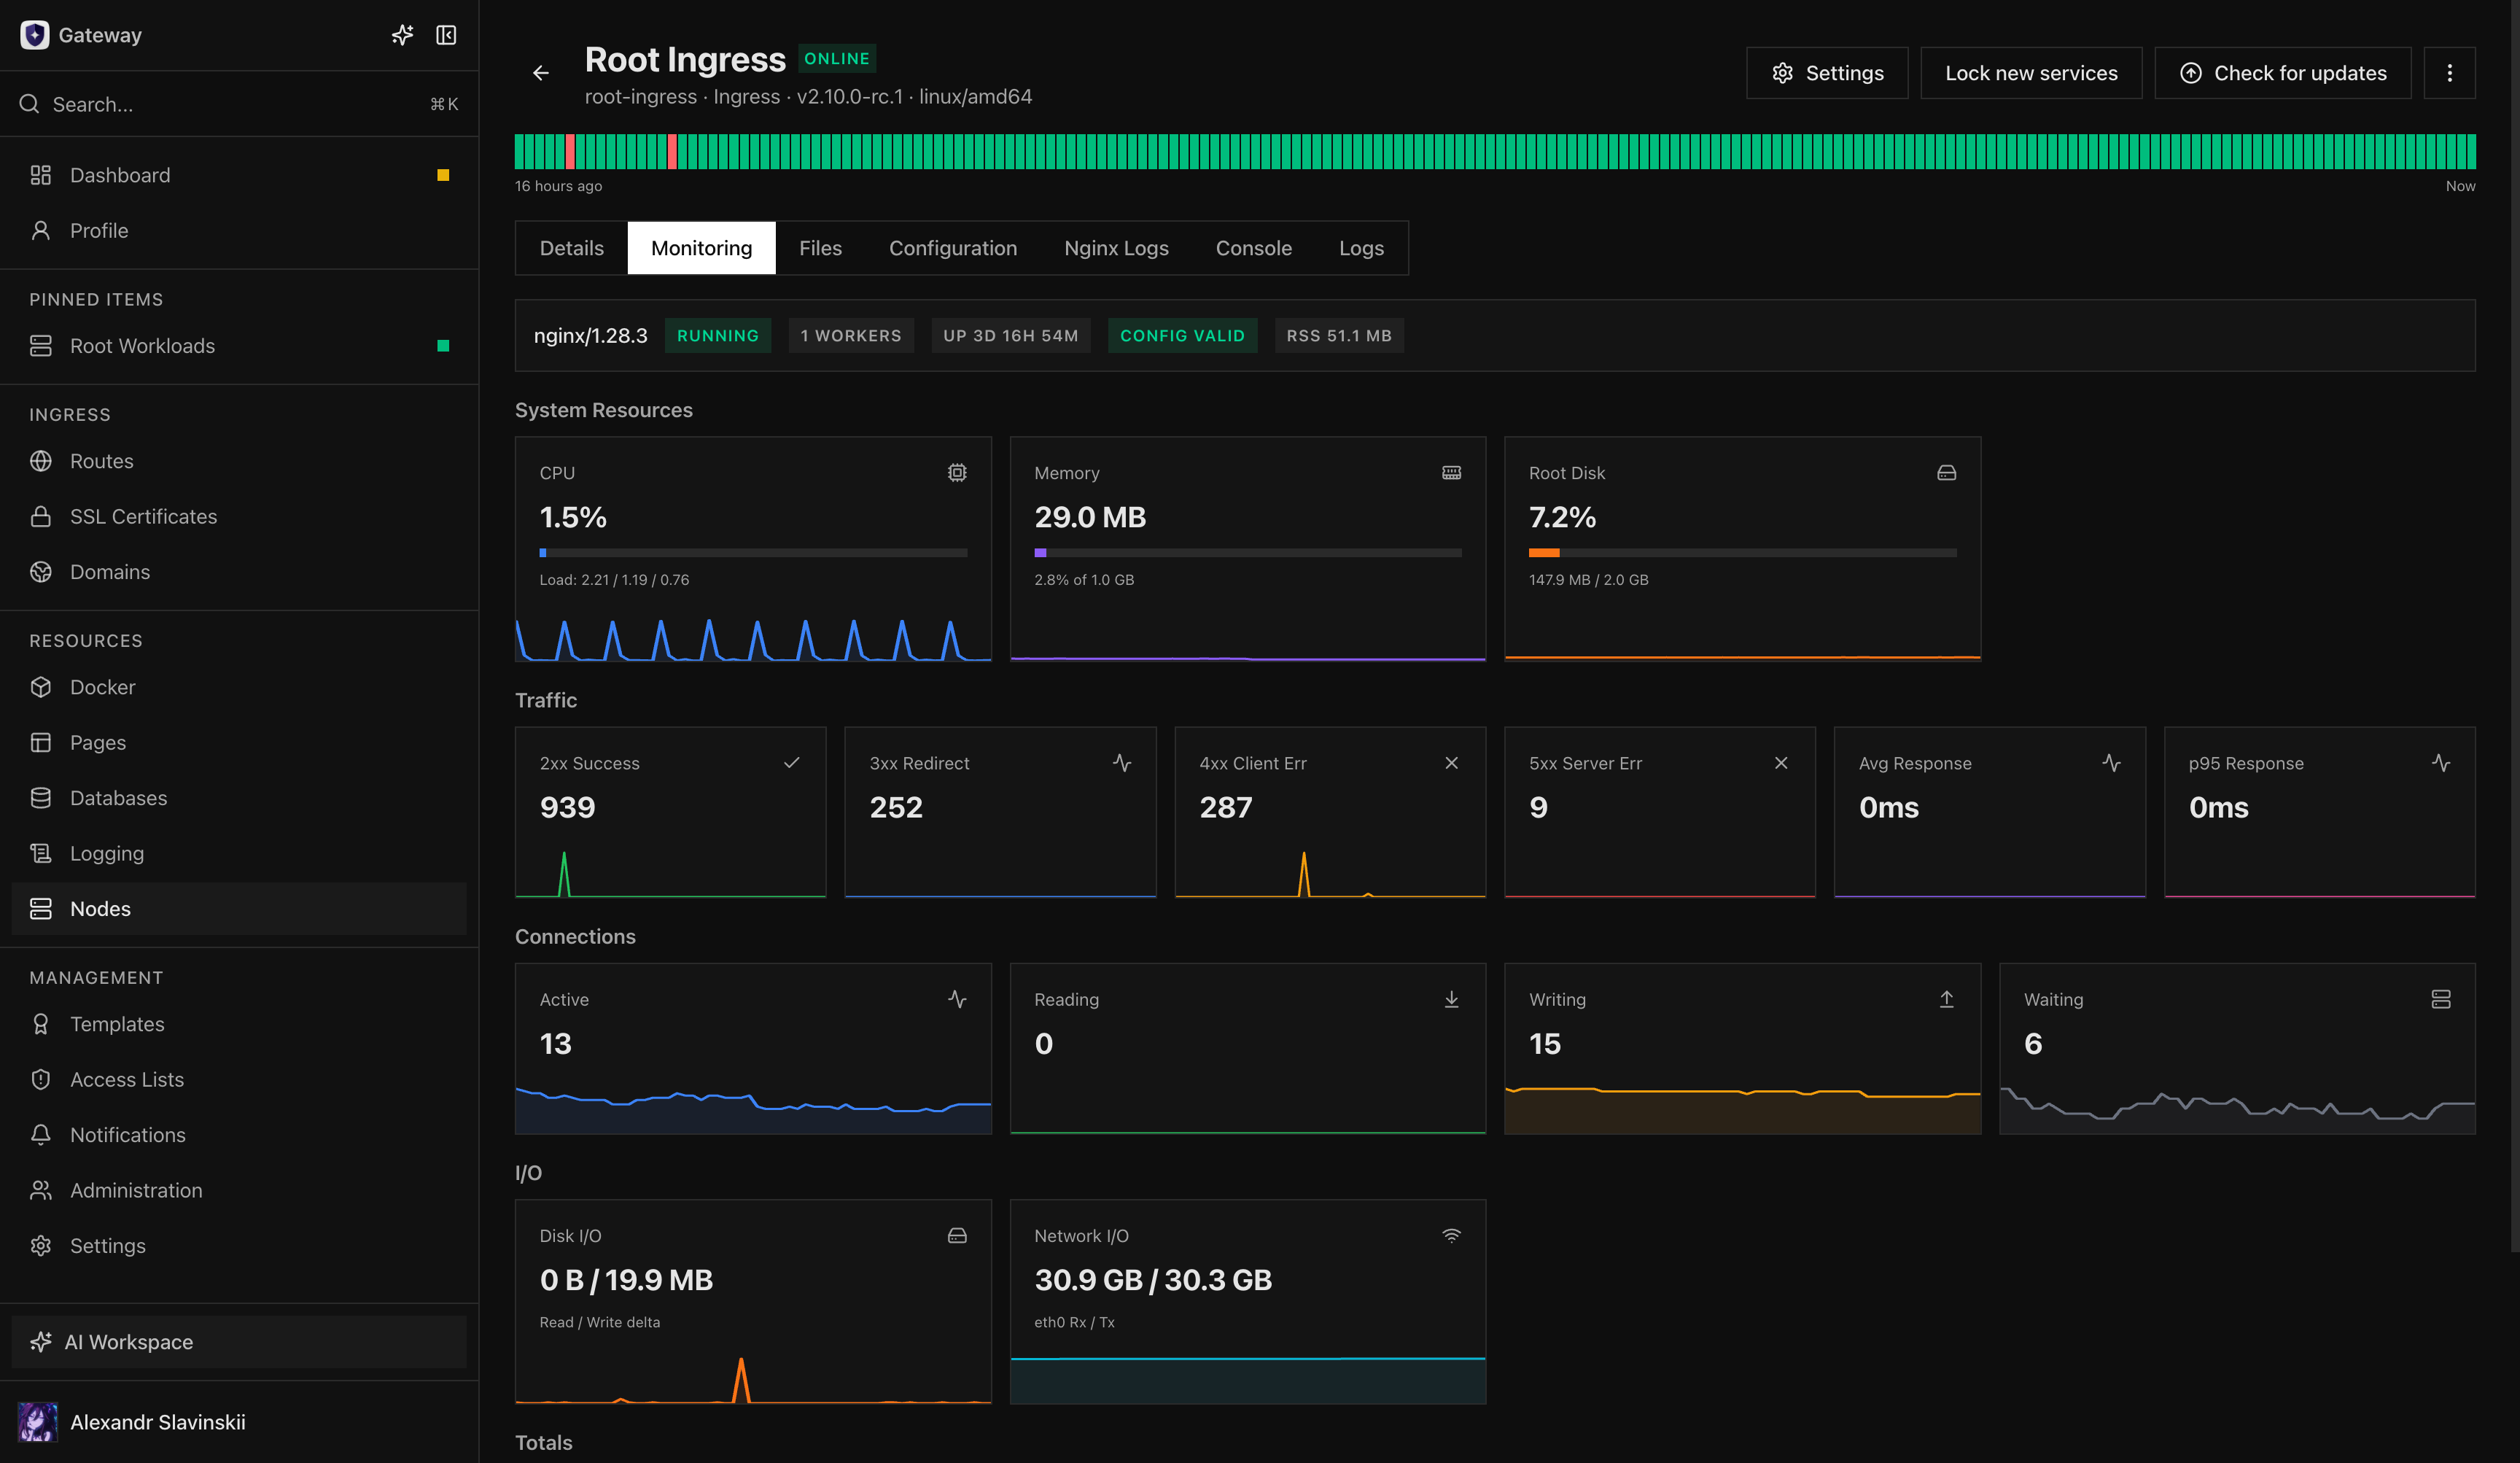
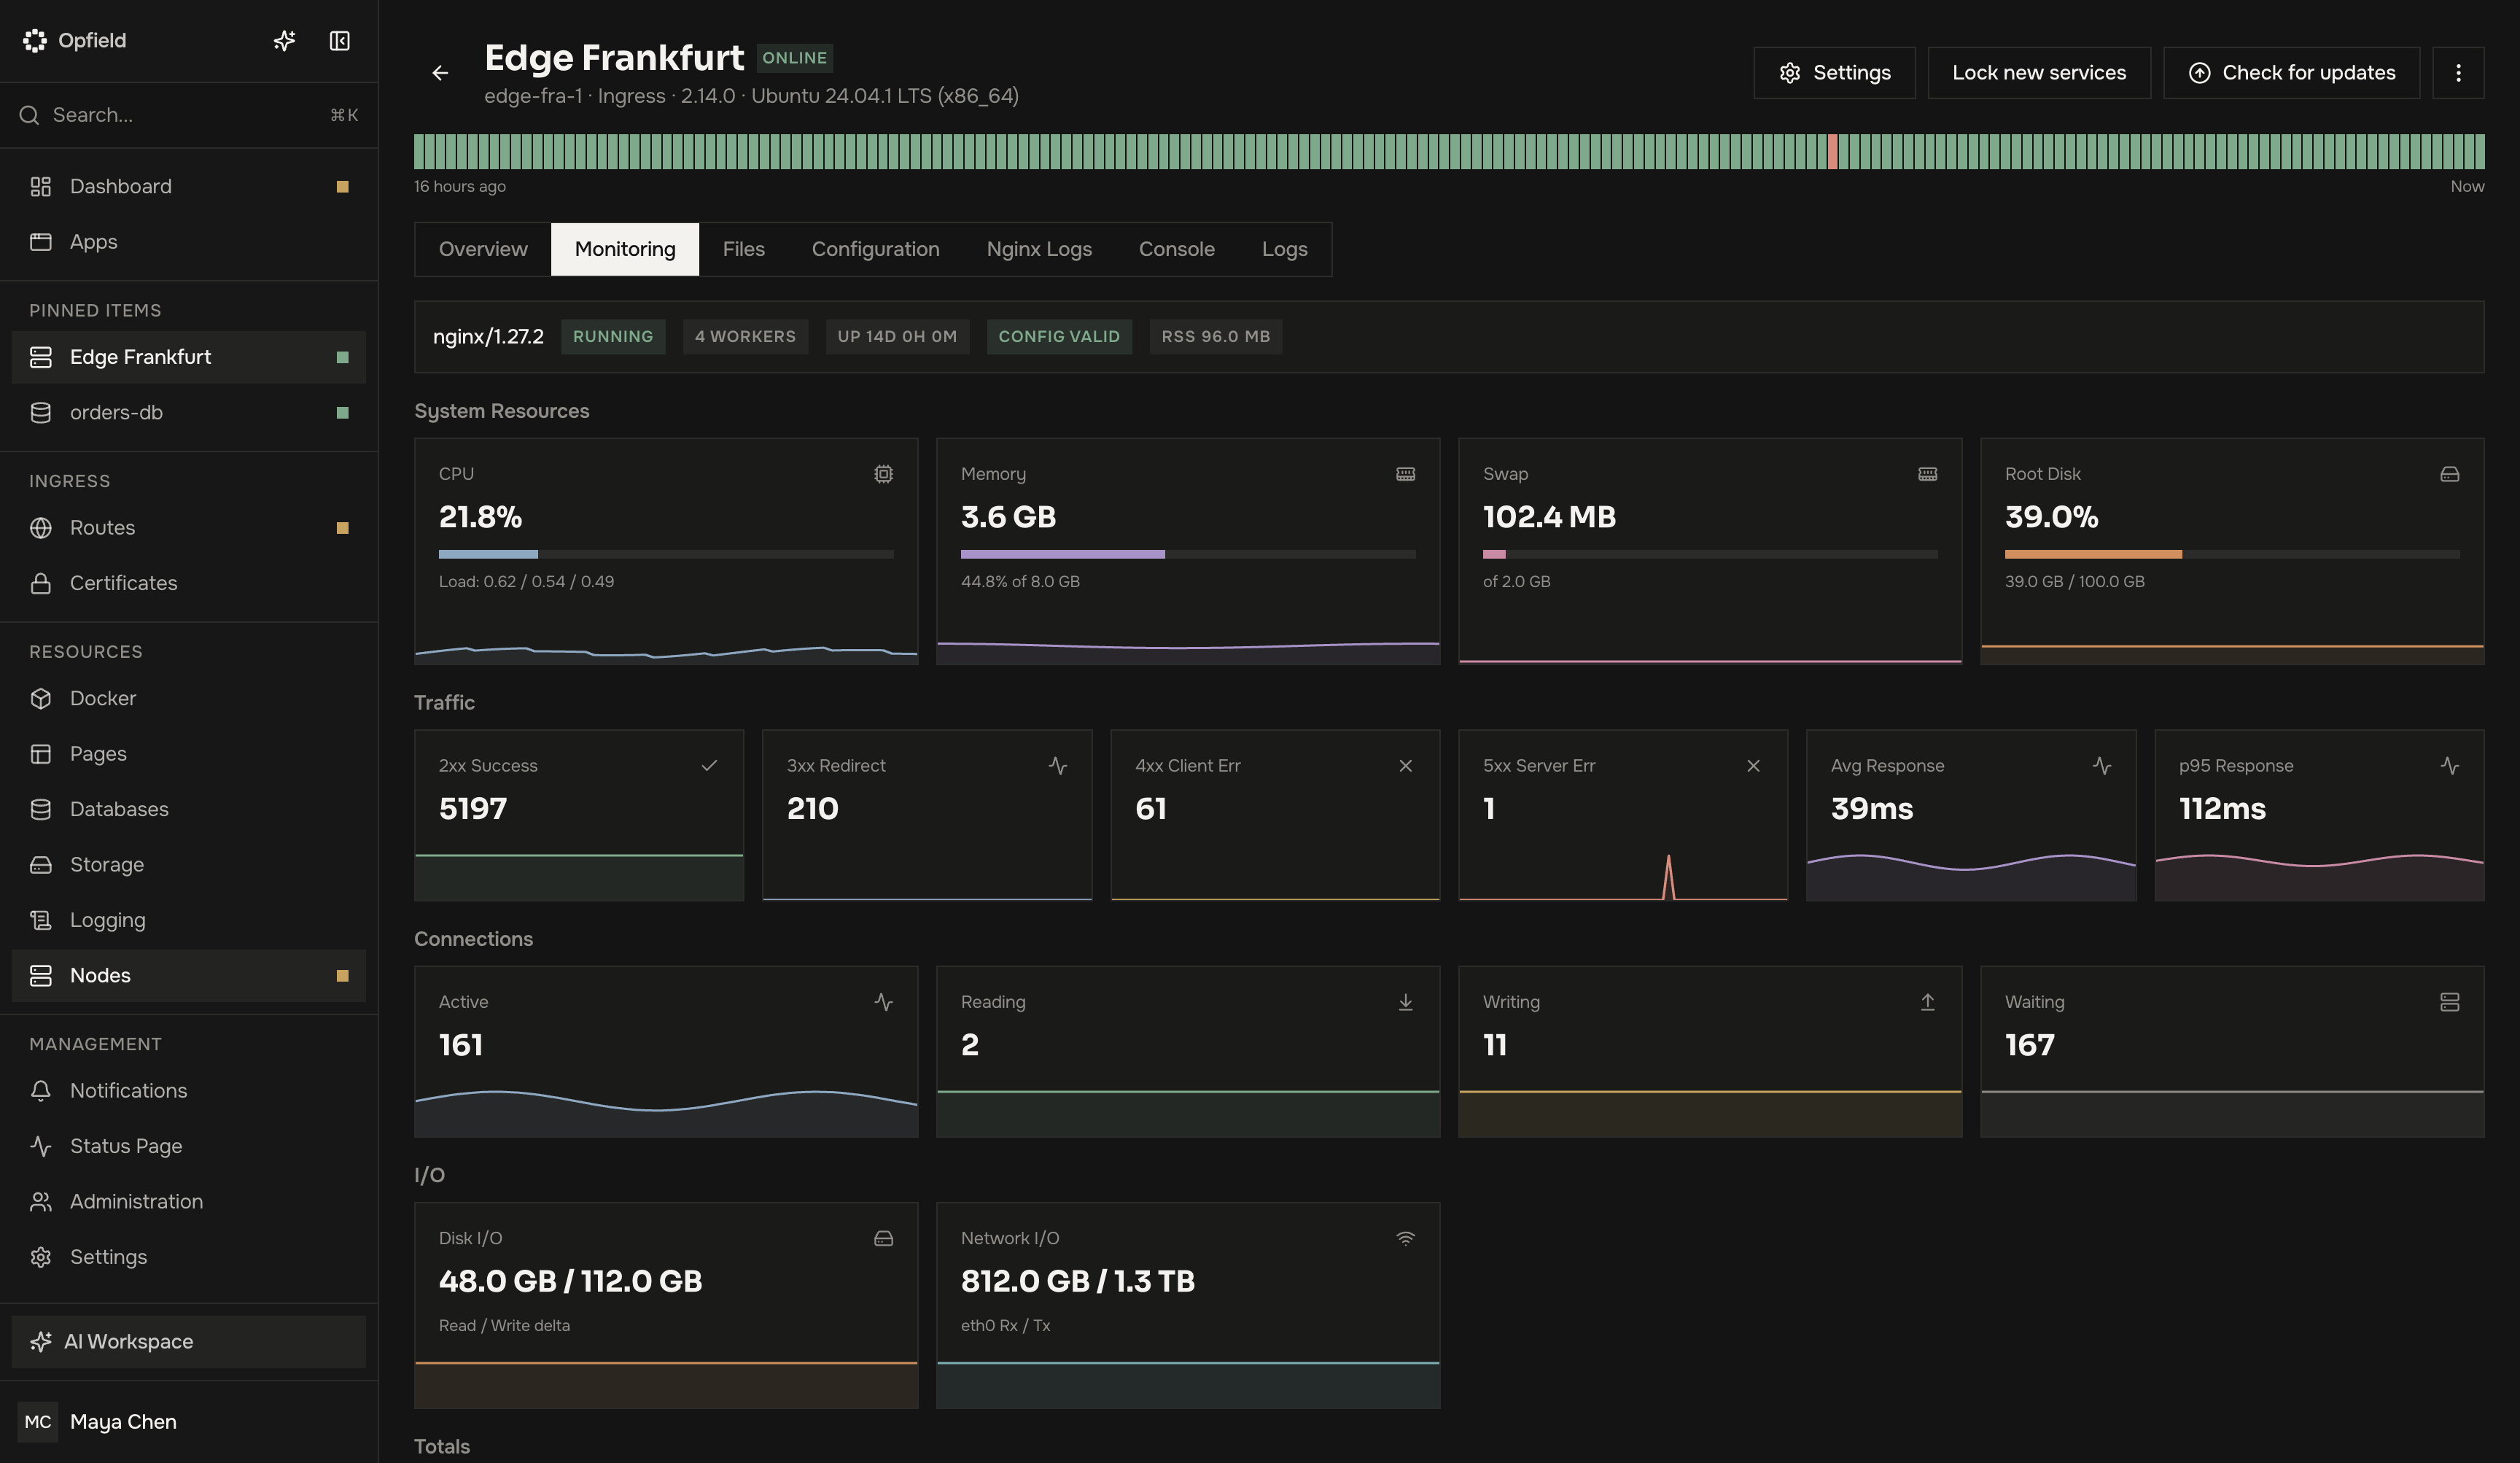
Opfield beobachtet den Zustand der Control Plane, den Zustand von Nodes und Workloads, Ingress-Verkehr, den Zustand von Datenbanken, Build-Aktivität, Inference-Nutzung und Sicherheitsereignisse. Jedes Signal erscheint im Dashboard und auf der Seite der Ressource, die es beschreibt: Nodes, Routen, Workloads, Datenbanken, Builds, Tasks, Benachrichtigungen, Audit und Statusseiten. Bei einem Vorfall beantworten die Signale drei Fragen: Sind Kunden betroffen, wer muss handeln, und wie wird die Wiederherstellung geprüft?
Opfield hat kein Distributed Tracing. Wenn Ihr Sicherheitsteam Audit-Ereignisse in seinem eigenen SIEM analysiert, exportiert Opfield sie dorthin; siehe Strukturiertes Logging und SIEM.
Streben Sie eine kleine Menge vertrauenswürdiger Signale mit benannten Verantwortlichen, sinnvoller Aufbewahrung und einem getesteten Weg von der Erkennung bis zur Wiederherstellung für Kunden an. Sie legen fest, was Erfolg für das Geschäft bedeutet: Service-Level-Ziele (SLOs), Eskalation und Prüfungen externer Abhängigkeiten.
Verwenden Sie den Ressourcenzustand für den unmittelbaren Zustand, Metriken für Trends, Logs für die Diagnose, dauerhafte Tasks für den Fortschritt von Operationen, Benachrichtigungen zum Handeln, Statusseiten für die Kundenkommunikation, Audit für die Zuordnung und SIEM für die externe Sicherheitsanalyse.
Gestalten Sie Alarme entlang anhaltender Auswirkungen auf Kunden und bedeutsamer Zustandsübergänge. Vermeiden Sie es, jedes Ereignis auf niedriger Ebene in einen Benachrichtigungskanal zu duplizieren.
Zuständigkeit und Erfolg festlegen
Abschnitt betitelt „Zuständigkeit und Erfolg festlegen“Benennen Sie für jeden wichtigen Dienst den geschäftlichen Verantwortlichen, den technischen Verantwortlichen, das Ziel für die Rufbereitschaft und den Verantwortlichen für die Kundenkommunikation. Legen Sie fest, was verfügbar aus Sicht des Benutzers bedeutet, nicht nur anhand eines internen Prozess-Abzeichens. Eine Route kann fehlerfrei sein, während ihre Anwendung oder Datenbank unbrauchbare Antworten liefert; ein Node kann online sein, während ein Kundenablauf gestört ist.
Verwenden Sie ein SLO – ein messbares Zuverlässigkeitsziel über die Zeit –, um zu entscheiden, welche Bedingungen Alarme verdienen und welche nur in Dashboards oder Berichte gehören. Halten Sie die erwartete Wiederherstellungsprüfung im Alarm selbst fest. Erfolg ist erreicht, wenn der Kundenpfad wieder funktioniert, sich das Signal erholt hat und jede vorübergehende Gegenmaßnahme entfernt wurde.
Signaltypen
Abschnitt betitelt „Signaltypen“| Signal | Bester Einsatz | Häufiger Fehler |
|---|---|---|
| Zustand | Aktuelle Bereitschaft des Dienstes | Ein grünes Abzeichen als Beweis für durchgängige Verfügbarkeit werten |
| Metriken | Kapazität und Trends | Bei jeder kurzen Spitze alarmieren |
| Logs | Detaillierte Diagnose | Secrets oder unbegrenzte Nutzdaten senden |
| Tasks | Dauerhafter Fortschritt von Operationen | Annehmen, dass ein angenommener Task bereits abgeschlossen ist |
| Ereignisse | Zustandsübergänge von Ressourcen | Ereignisvolumen als Zustandsmetrik verwenden |
| Audit | Wer was geändert hat | Betriebslogs durch Audit-Einträge ersetzen |
| Benachrichtigungen | Handeln durch Operatoren | Jedes informative Ereignis weiterleiten |
| Statusseiten | Kundenkommunikation | Private Topologie oder rohe Fehler veröffentlichen |
Eine Betriebssicht aufbauen
Abschnitt betitelt „Eine Betriebssicht aufbauen“- Beginnen Sie mit kundenseitigen Routen und Geschäftsdiensten.
- Ordnen Sie jedem Dienst seinen Ingress, Workload, seine Datenbank, seinen Speicher und seine externen Abhängigkeiten zu.
- Legen Sie das Zustandssignal und das SLO fest, die die Auswirkung auf Kunden abbilden.
- Fügen Sie Alarme zur Ressourcenkapazität mit anhaltenden Zeitfenstern hinzu.
- Leiten Sie dringende Ereignisse an ein Benachrichtigungsziel mit Verantwortlichem.
- Erstellen Sie eine öffentliche Statuskomponente nur für Informationen, die Kunden sehen sollen.
- Testen Sie Ausfall und Wiederherstellung, nicht nur die Zustellung von Benachrichtigungen.
Ablauf der Diagnose
Abschnitt betitelt „Ablauf der Diagnose“Verwenden Sie das Dashboard für die Ersteinschätzung und öffnen Sie dann die betroffene Ressource. Vergleichen Sie den Live-Zustand mit aktuellen Metriken, Tasks, Ereignissen und Logs. Setzen Sie Daten über stabile Ressourcen-ID, Operations-ID, Request-ID und Zeitstempel in Beziehung. Beruht der angezeigte Zustand auf einer zwischengespeicherten Momentaufnahme, stellen Sie die Verbindung des zuständigen Nodes wieder her, bevor Sie die Ressource ändern.
Beim Datenbank-Monitoring beginnt die Erfassung nach dem Bootstrap von Opfield und wenn eine verwaltete Datenbank bereit wird im Hintergrund; das Öffnen der Datenbankseite ist keine Voraussetzung. Ein erster Seitenaufruf kann kurz auf den Verlauf oder die erste echte Momentaufnahme warten, darf aber aus fehlenden Daten keinen fehlerfreien Zustand erzeugen.
Beginnen Sie bei einem Vorfall mit dem betroffenen Kundenablauf und arbeiten Sie sich nach innen vor: öffentliches DNS und TLS, Route und Ingress, Workload, private Abhängigkeiten, Speicher und externe Dienste. Verwenden Sie Tasks, um eine angenommene von einer abgeschlossenen Operation zu unterscheiden. Verwenden Sie das Audit, um Konfigurationsänderungen zu verstehen, nicht als Ersatz für Laufzeitlogs.
Opfield-Diagnose
Abschnitt betitelt „Opfield-Diagnose“Opfield meldet auch seinen eigenen Zustand. Der KI-Assistent und MCP-Clients lesen ihn mit manage_opfield_diagnostics:
snapshot: CPU, Arbeitsspeicher, Last und Festplatte des Daten-Volumes des Hosts; Arbeitsspeicher, CPU und Event-Loop-Verzögerung des Backend-Prozesses; Erreichbarkeit, Latenz, Verbindungspool, Größe und lange Abfragen von PostgreSQL und Redis; die Stack-Container (app,postgres,redis,relay,registry) mit Zustand, Health, Neustarts, CPU und Arbeitsspeicher; fehlschlagende Hintergrundjobs; sowie API-Latenz und 5xx;history: Messungen im Minutentakt, 48 Stunden lang aufbewahrt;requestsundjobs: Anzahl, p95 und 5xx pro Route sowie der letzte Lauf und die Fehler jedes Hintergrundjobs;logs: die Logs der Container app, PostgreSQL, Redis, Relay und Registry sowie des letzten Opfield-Update-Laufs.
Das Lesen des Zustands erfordert diagnostics:view; das Lesen der Logs erfordert diagnostics:logs, das ihn einschließt. Die integrierten Admin-Gruppen besitzen beide; benutzerdefinierten Gruppen müssen sie vergeben werden. CPU-Werte umfassen die CPUs, die Opfield tatsächlich verwenden darf, mit kernelCpuCount als Anzahl laut Kernel. Der Arbeitsspeicher ist das cgroup-Limit des Containers, sofern eines gesetzt ist (memoryScope: "cgroup"), und andernfalls die Sicht des Kernels ("kernel"), etwa innerhalb eines LXC-Gasts, dessen eigenes Limit aus dem App-Container nicht sichtbar ist.
Alarmregeln der Kategorie Opfield beobachten dieselben Signale: CPU, Arbeitsspeicher und Festplatte des Hosts, Arbeitsspeicher des Backends, Event-Loop-Verzögerung, 5xx-Rate und p95-Latenz der API, Latenz und Pool-Wartezeiten von PostgreSQL sowie Latenz von Redis. Sie lösen außerdem aus, wenn PostgreSQL oder Redis nicht verfügbar ist, wenn ein Stack-Container ausgefallen oder fehlerhaft ist und wenn ein Hintergrundjob dauerhaft fehlschlägt. Ein Alarm über einen PostgreSQL-Ausfall wird direkt an die Webhooks seiner Regeln gesendet, solange PostgreSQL ausgefallen ist, und erfasst, sobald es zurück ist. /health prüft PostgreSQL über eine eigene Verbindung, sodass ein ausgelasteter Verbindungspool nicht als Ausfall gewertet wird.
Observability selbst prüfen
Abschnitt betitelt „Observability selbst prüfen“Überwachen Sie den Monitoring-Pfad: Aktualität der Nodes, Zustand von ClickHouse, Zustellung der Benachrichtigungswarteschlange, Veröffentlichung der Statusseite, Alter des SIEM-Outbox und Speicheraufbewahrung. Ein Observability-System, das stillschweigend aufhört zu erfassen, muss eine separate Plattformwarnung erzeugen.
Bewahren Sie Telemetrie lange genug für die Rekonstruktion von Vorfällen auf, wenden Sie aber ausdrückliche Aufbewahrungs- und Größenbudgets an. Verwenden Sie Logs nicht als unkontrolliertes Datenarchiv.
Details für Betreiber: veraltete und widersprüchliche Signale
Abschnitt betitelt „Details für Betreiber: veraltete und widersprüchliche Signale“Jede Zustandsentscheidung hat einen Zeitstempel und einen Verantwortlichen. Trennt sich ein Node, kann seine letzte Momentaufnahme veralten; stellen Sie den zuständigen Node wieder her, bevor Sie Ressourcen auf Grundlage alter Informationen ändern. Widersprechen sich die Warnung in der Seitenleiste und eine Detailseite, vergleichen Sie ihre Quelle, ihren Zeitstempel und ihre Aggregationsregel, statt anzunehmen, dass eine der Farben maßgeblich ist.
Behandeln Sie fehlende Daten als unbekannt, nicht als fehlerfrei. Prüfen Sie, dass die Erfassung fortschreitet, die neueste Messung voranschreitet, ClickHouse verfügbar ist, wo strukturierte Logs erwartet werden, Benachrichtigungswarteschlangen abgearbeitet werden und öffentliche Status-Updates veröffentlicht werden. Führen Sie nach einer Reparatur die ursprüngliche durchgängige Prüfung aus und dokumentieren Sie jeden blinden Fleck, der die Erkennung verzögert hat.