

Datenbanken und Speicher auf mehreren Servern
In Business und Enterprise kann eine verwaltete PostgreSQL-Datenbank, ein Key-Value-Store, eine ClickHouse-Datenbank oder ein SeaweedFS-Speicher auf 2 bis 5 Storage Nodes laufen, jeder auf einem eigenen Host. Ein Server ist der Primary und nimmt alle Lese- und Schreibvorgänge an; die anderen sind Kopien, die ihm folgen. Geht der Primary verloren, übernimmt eine Kopie. Betreiben Sie in der Produktion außerdem mindestens zwei Relays auf anderen Hosts als dem Opfield-Host, in unterschiedlichen Fehlerdomänen, damit Verbindungen zur Datenbank nicht vom Opfield-Host abhängen; siehe Wie viele Relays.
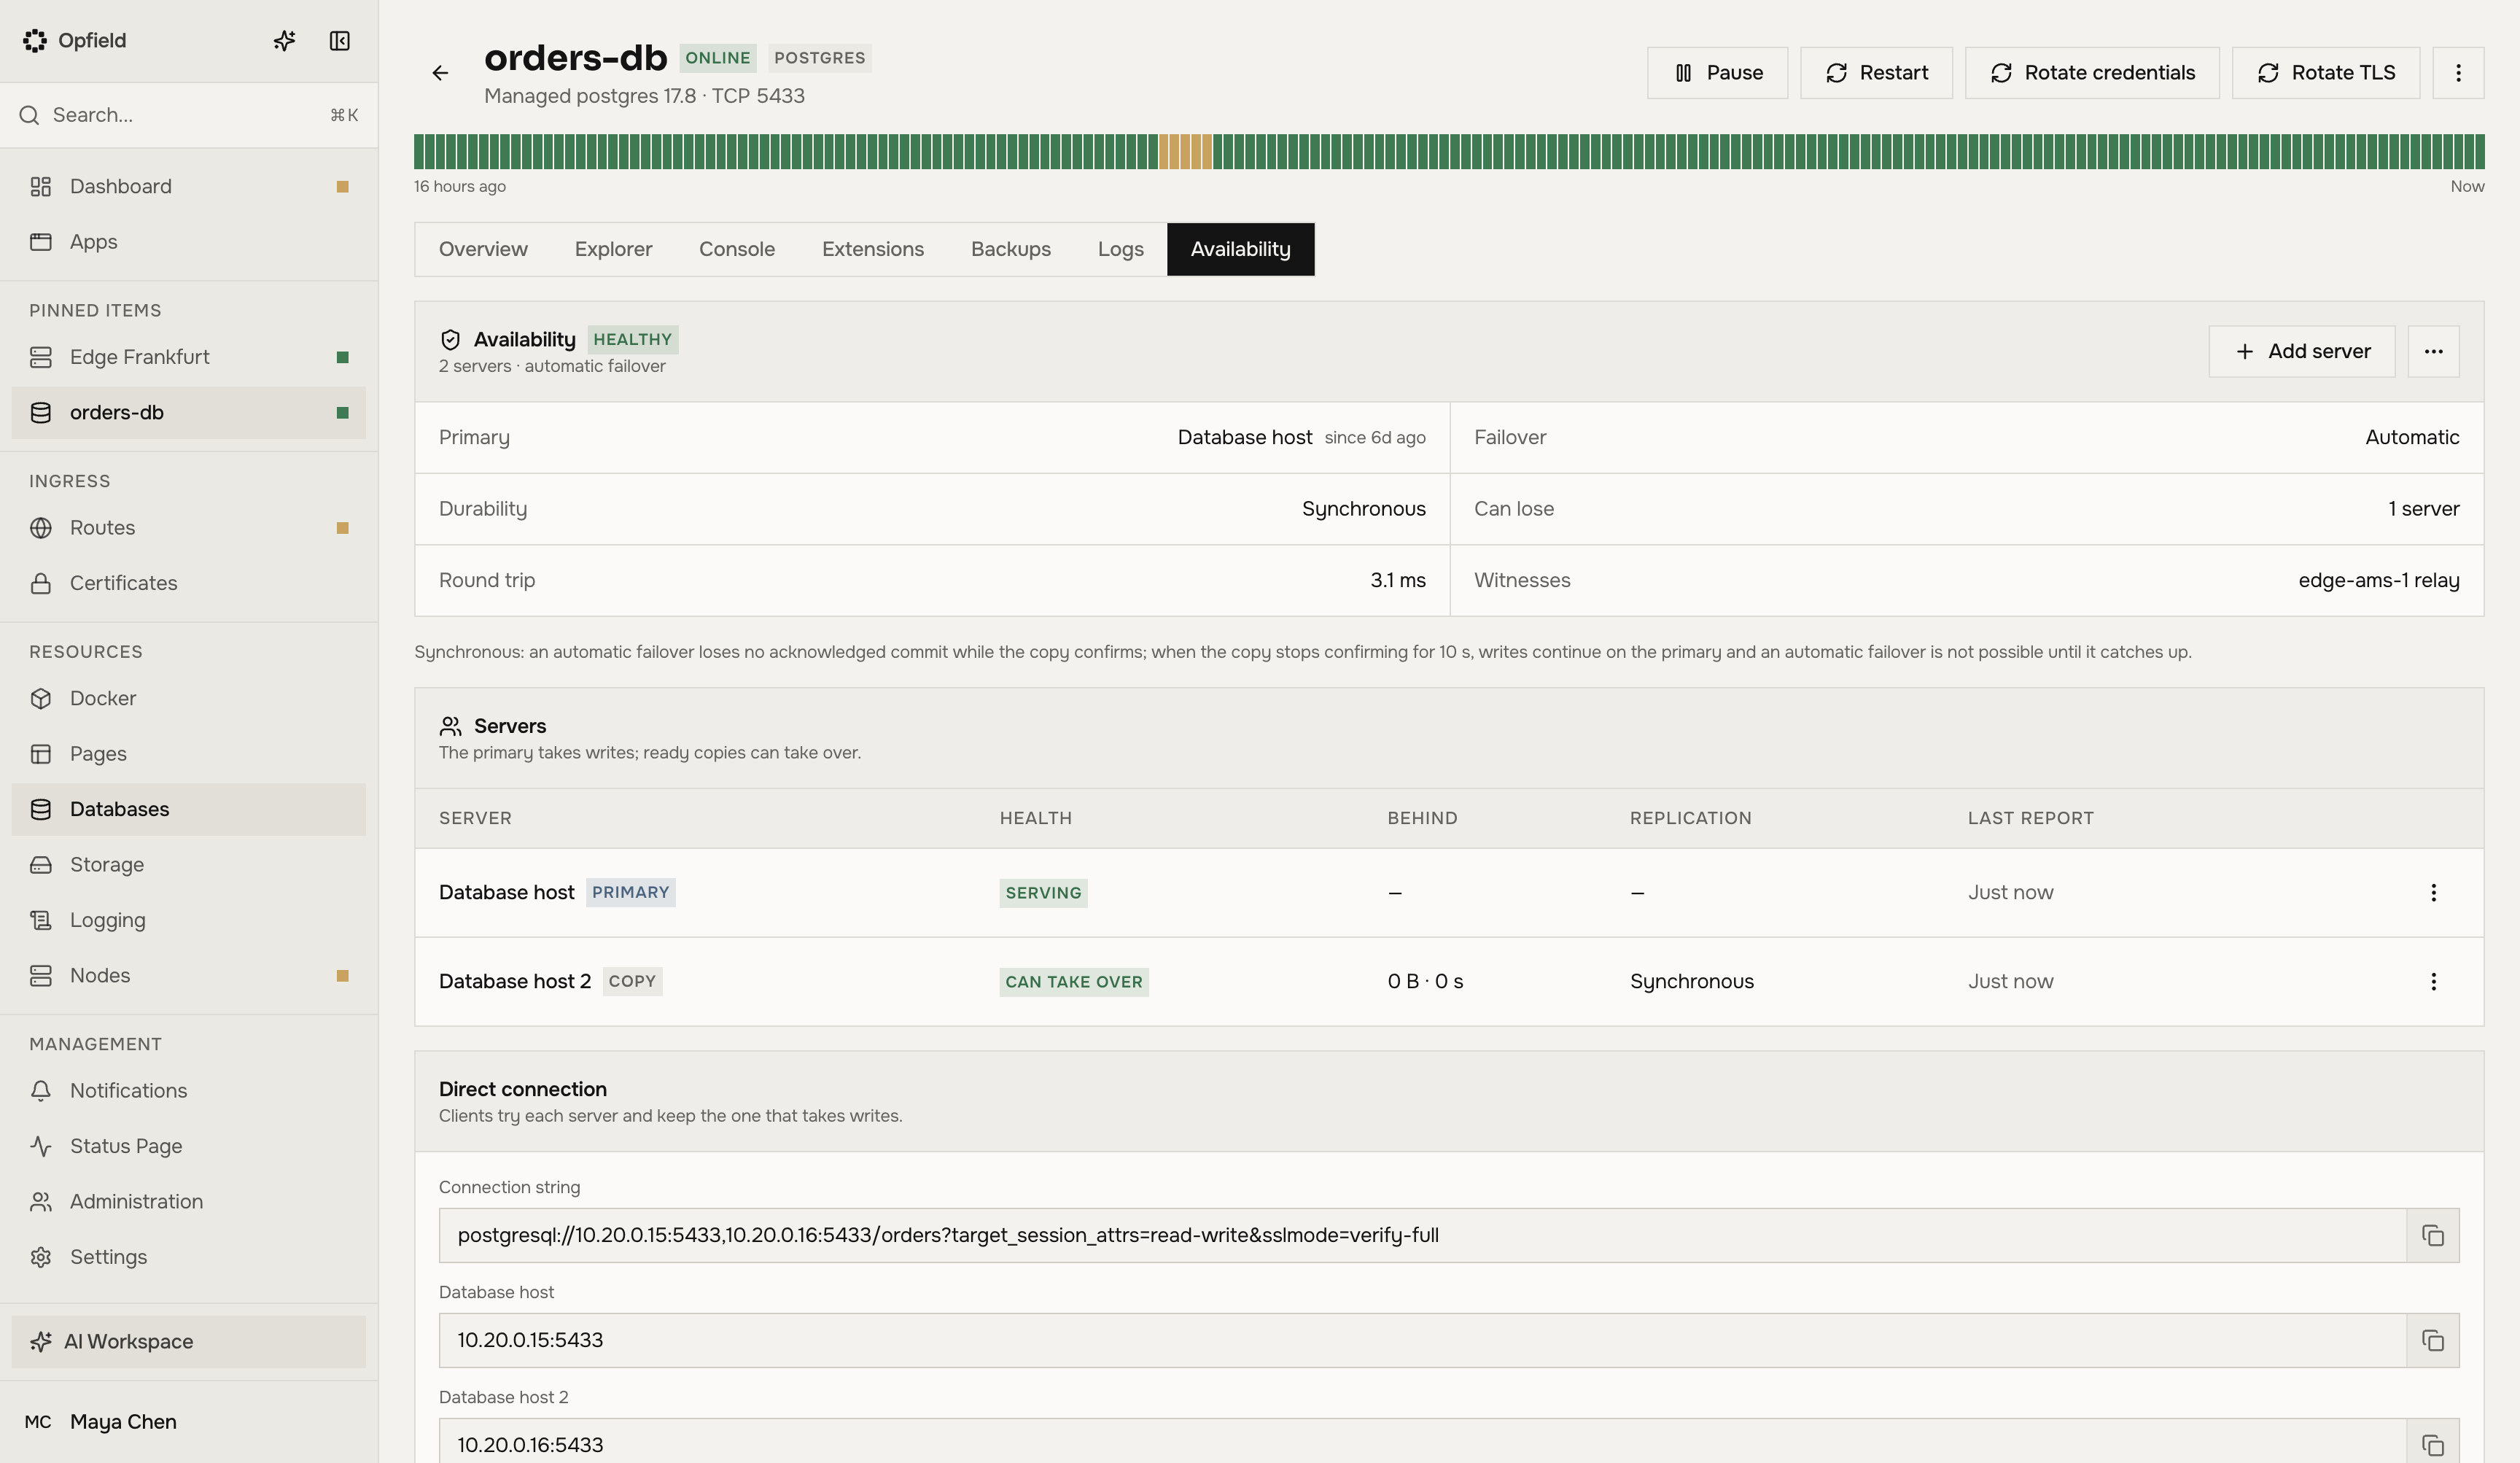
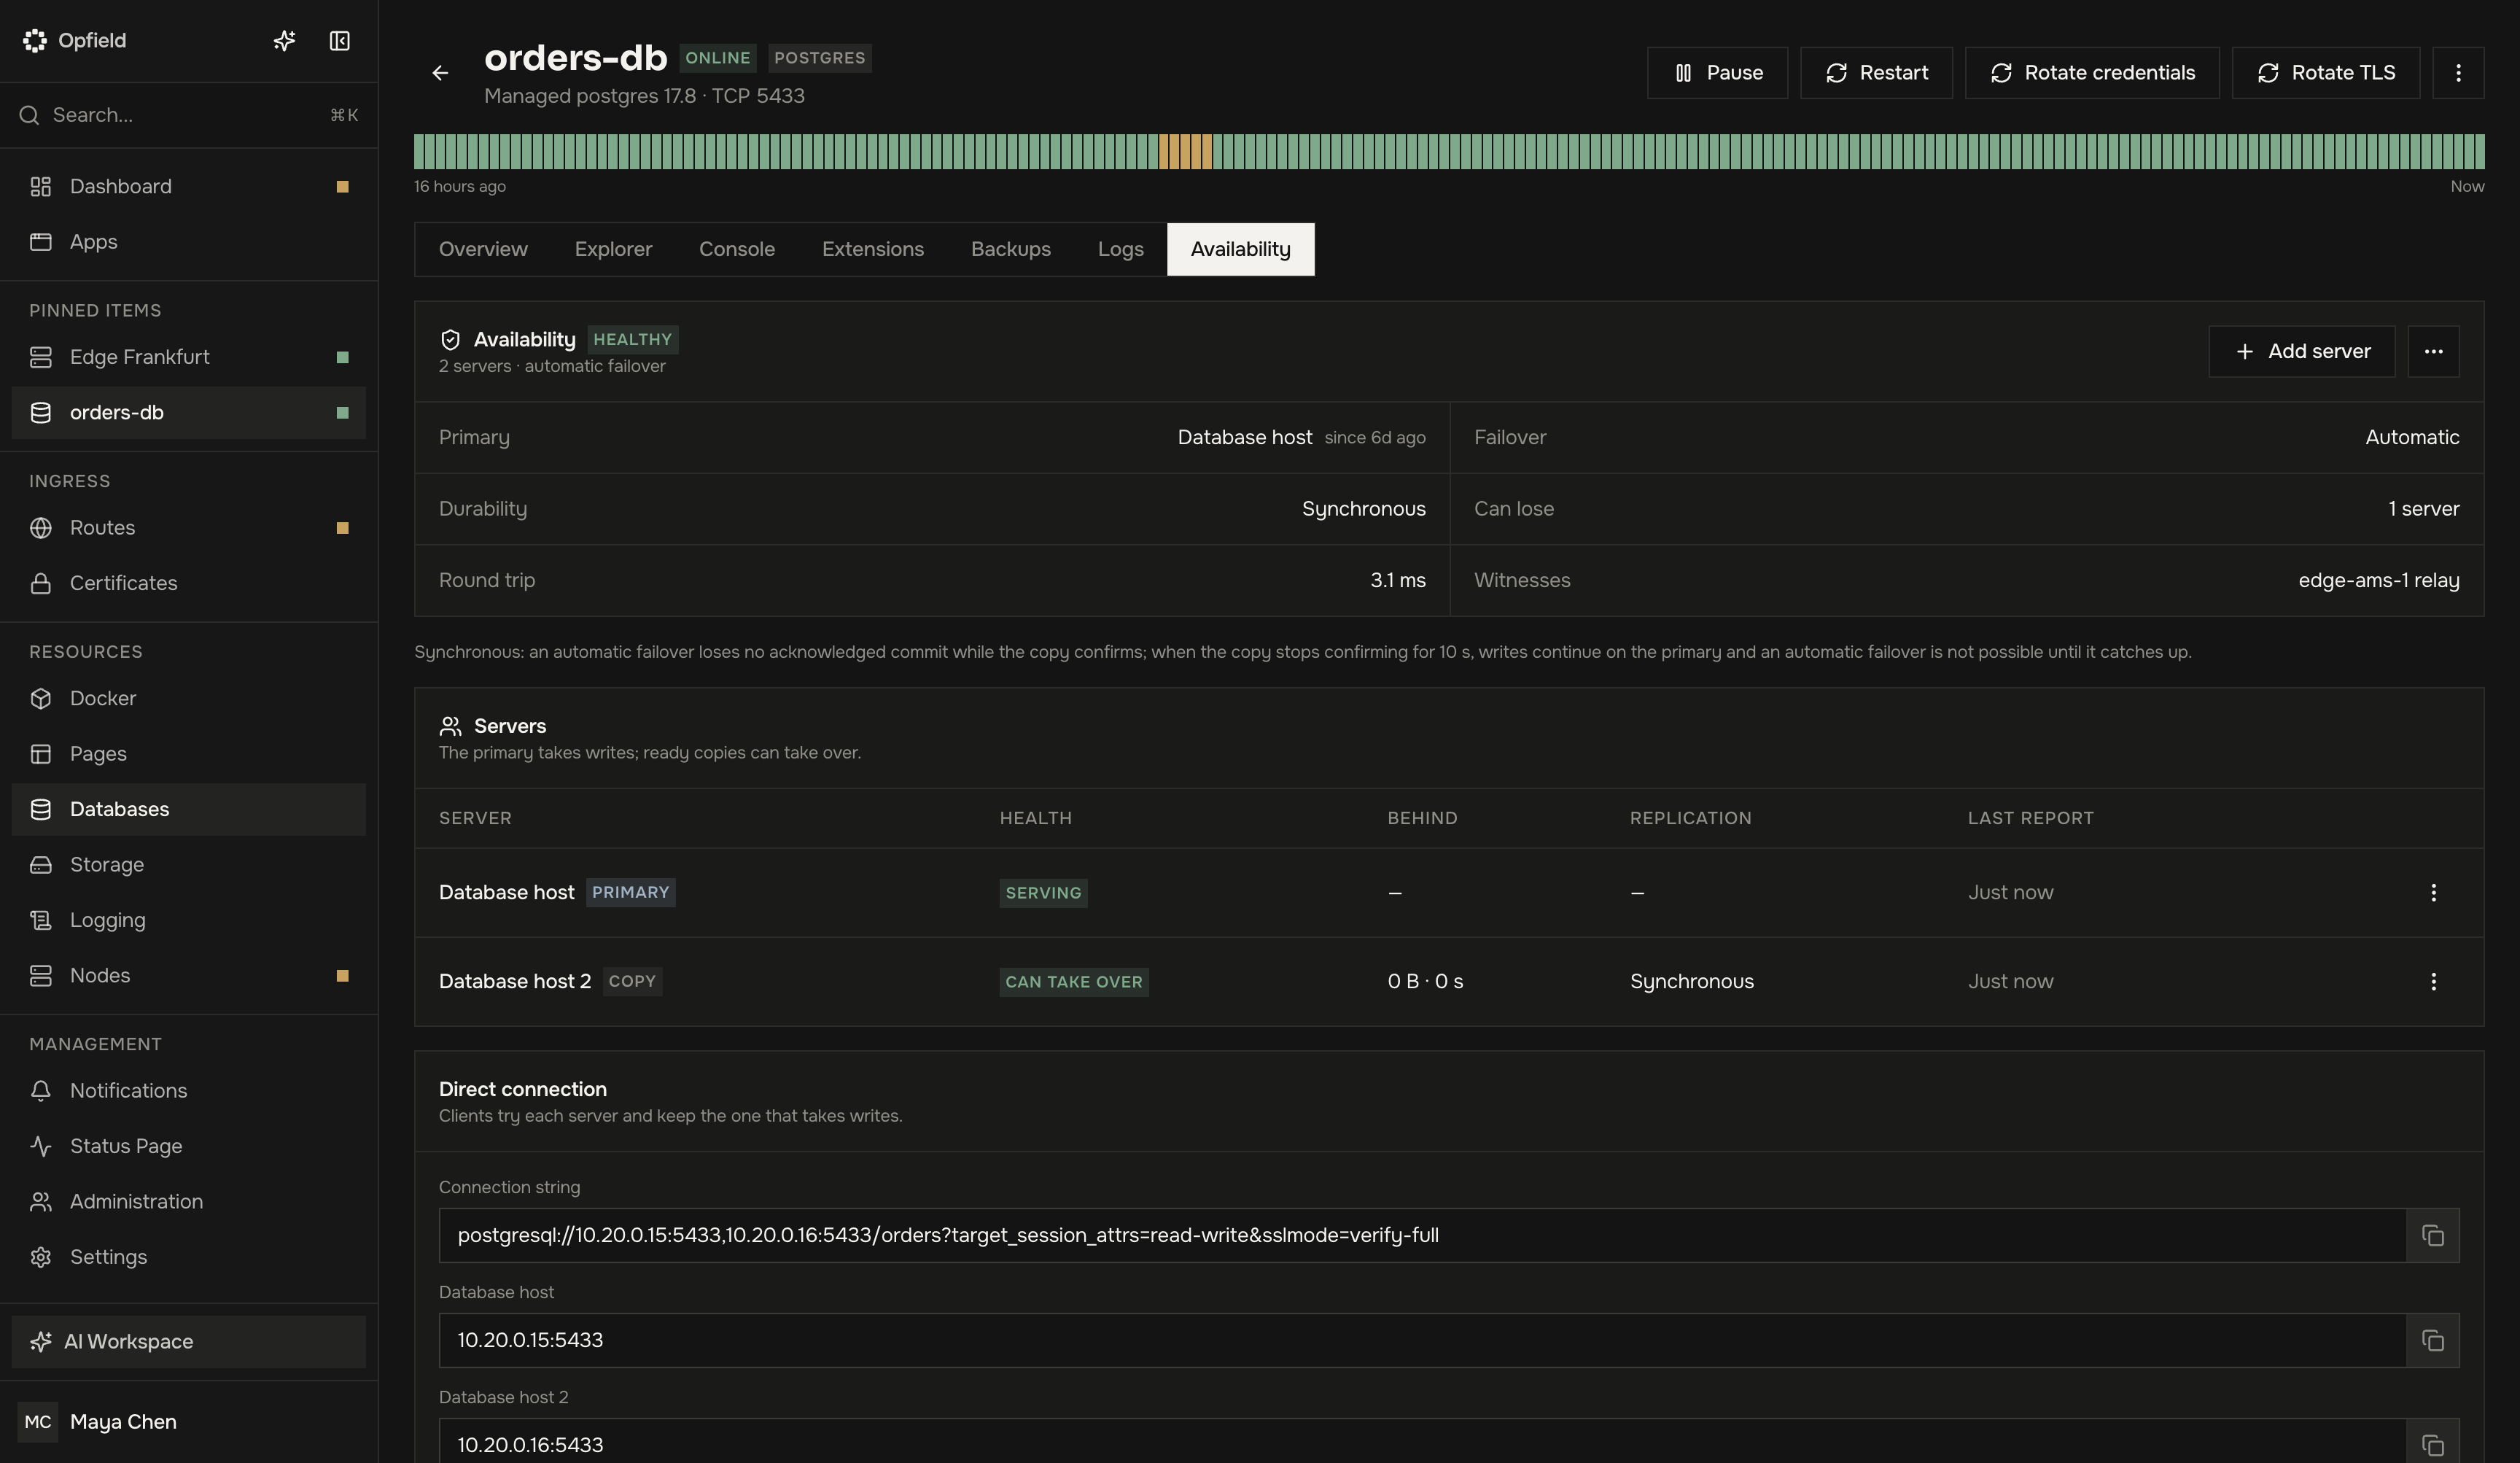
Verbindungen, Bindings und die eigenen Werkzeuge von Opfield erreichen immer den Primary. Kopien dienen nur dem Failover und Backups, nicht dem Lesen.
Einschalten
Abschnitt betitelt „Einschalten“- Verwenden Sie für eine neue Ressource Availability im Erstellungsformular.
- Verwenden Sie für eine bestehende Make available… auf ihrer Seite.
Bevor sich etwas ändert, zeigt die Vorabprüfung den Modus, die Server und Witnesses, die gemessene Umlaufzeit zwischen den Servern, die Dauerhaftigkeit und was ein Failover verlieren kann. Das Einschalten bei einer bestehenden Ressource startet sie einmal neu; sie behält ihre Daten und bedient von ihrem Server aus, während die Kopien befüllt werden.
Die Registerkarte Availability der Datenbank bzw. des Speichers zeigt dann die Server mit ihrer Rolle, ihrem Zustand und ihrem Rückstand, die Witnesses, die Einstellungen und die Ereignisse.
Automatisches Failover und Witnesses
Abschnitt betitelt „Automatisches Failover und Witnesses“Automatisches Failover benötigt eine Mehrheit von Abstimmenden auf getrennten Hosts. Die Abstimmenden sind die Datenserver plus Witnesses. Ein Witness stimmt darüber ab, welcher Server Primary ist, und hält keine Daten. Bei zwei Datenservern fügt Opfield einen oder drei Witnesses hinzu, sodass ein Datenserver oder ein Datenserver und ein Witness ausfallen können.
Ein Witness läuft auf:
- einem Relay, dem ein Administrator das Hosten von Witnesses erlaubt hat, unter Settings → Relay, Spalte Witnesses (
PATCH /api/system/relay/instances/{id}, MCPmanage_relay_poolset_witness_hosting); Opfield bevorzugt erlaubte Relays; - oder einem Docker Node auf einem anderen Host.
Ein geschütztes Relay hostet Witnesses erst, nachdem sein Eigentümer es in der lokalen Konfiguration des Relays erlaubt hat; bis dahin zeigt Settings → Relay „Protected relay: needs local opt-in“. Bei ClickHouse sind die Witnesses Abstimmende von ClickHouse Keeper, die keine Daten halten.
Zwei Server ohne Witness: manuelles Failover
Abschnitt betitelt „Zwei Server ohne Witness: manuelles Failover“Gibt es keinen dritten Host für einen Witness, bilden zwei Server ein replicated pair mit manuellem Failover: Die Kopie folgt dem Primary, aber nichts schaltet selbstständig um. Geht der Primary verloren, schalten Sie mit Make this copy primary auf die Kopie um.
Damit nie zwei Primaries Schreibvorgänge annehmen, nimmt ein Primary keine Schreibvorgänge mehr an, wenn er 30 Sekunden lang weder Opfield noch seine Kopie erreichen kann.
Wenn Opfield ausgefallen ist
Abschnitt betitelt „Wenn Opfield ausgefallen ist“Das Failover funktioniert ohne Opfield. Die Server und Relays entscheiden untereinander, welcher Server Primary ist, solange die signierte Richtlinie der Relays gültig ist: die Richtlinien-Lease der Relays, standardmäßig 72 Stunden, die die Vorabprüfung auf 7 Tage zu erhöhen anbietet (Settings → Relay, Policy lease). Siehe Relays ohne Opfield.
Was in der Zwischenzeit geschehen ist, erreicht Opfield, wenn es zurück ist, mit dem Zeitpunkt des Geschehens, im Audit-Log und in Alarmen. Backups warten auf Opfield, weil Opfield sie plant. Ein replicated pair ohne Witnesses kann weiterhin nur über Opfield umgeschaltet werden.
Was ein Failover verlieren kann
Abschnitt betitelt „Was ein Failover verlieren kann“„Bestätigt“ bedeutet, dass der Client einen Erfolg erhalten hat.
| Engine und Zustand | Was ein ungeplantes Failover verlieren kann |
|---|---|
| PostgreSQL, synchron, fehlerfrei | Nichts Bestätigtes. Ein Commit, auf den der Client nicht mehr gewartet hat, kann verloren gehen, wenn der Primary innerhalb von etwa 5 Sekunden ausfällt; Opfield erfasst ihn. |
| PostgreSQL, synchron, Kopie zurückgefallen | Kein automatisches Failover. Eine Kopie, die 10 Sekunden lang nicht mehr bestätigt, wird aus der synchronen Replikation entfernt, und Schreibvorgänge gehen weiter; eine manuelle Umschaltung verliert dann die Schreibvorgänge seitdem, und Opfield zeigt den Zeitpunkt und eine Schätzung. |
| PostgreSQL, asynchron | Bis zum Rückstandslimit (standardmäßig 1 MiB) plus etwa 1 Sekunde Schreibvorgänge. Eine Kopie mit größerem Rückstand kann nicht übernehmen. |
| Key-Value-Store (immer asynchron) | Bis zum Rückstandslimit (standardmäßig 1 MiB, meist unter 1 Sekunde). |
| SeaweedFS-Objekte | Nichts, solange beide Kopien beschreibbar sind: Jeder Schreibvorgang wird bestätigt, nachdem beide Server ihn gespeichert haben. Solange ein Server länger als 10 Sekunden ausgefallen ist, werden neue Objekte einmal gespeichert, bis er zurückkehrt, und gehen nur verloren, wenn die Festplatte des verbleibenden Servers verloren geht. |
| Objekt- und Bucket-Metadaten von SeaweedFS | Bis zu etwa 1 Sekunde an Änderungen. |
| ClickHouse, nahe Server | Nichts Bestätigtes, solange fehlerfrei. |
| ClickHouse, entfernt oder beeinträchtigt | Inserts, die die Kopie noch nicht abgerufen hatte; sie kommen zurück, wenn der alte Server mit seiner Festplatte zurückkehrt. |
Dauerhaftigkeit
Abschnitt betitelt „Dauerhaftigkeit“Die Dauerhaftigkeit ist standardmäßig synchronous, wenn die Server nah beieinander liegen (Umlaufzeit bis 10 ms): Ein Commit kehrt zurück, nachdem die Kopie ihn hat. Sie ist asynchronous, wenn sie weit entfernt sind: Ein Commit kehrt sofort zurück, und ein Failover kann die jüngsten Schreibvorgänge verlieren. Ändern Sie sie auf der Registerkarte Availability. Synchrone Dauerhaftigkeit bei weit entfernten Servern lässt jeden Commit auf die Umlaufzeit warten.
Opfield misst die Umlaufzeit alle 10 Minuten und alarmiert, wenn eine synchrone Gruppe weit auseinandergeraten ist, ohne ihre Dauerhaftigkeit zu ändern.
Manuell umschalten
Abschnitt betitelt „Manuell umschalten“Make this copy primary ist eine geplante Umschaltung ohne Verlust, wenn der Primary bedient und die Kopie aktuell ist. Ist der Primary weg oder die Kopie im Rückstand, kann die Umschaltung jüngste Schreibvorgänge verlieren: Der Dialog zeigt die Schätzung und bittet Sie, sie zu bestätigen (API und MCP: acceptDataLoss: true). Der alte Primary kehrt als Kopie zurück.
Clients verbinden
Abschnitt betitelt „Clients verbinden“Verbindungen und Bindings folgen dem Primary selbstständig. Verwenden Sie für direkte Verbindungen zu einer veröffentlichten Ressource den Verbindungsstring von der Seite der Ressource: Er nennt jeden Server, und ein Client, der jeden ausprobiert, behält den, der Schreibvorgänge annimmt. Eine Kopie lehnt Client-Verbindungen ab.
Alltägliche Operationen
Abschnitt betitelt „Alltägliche Operationen“Solange eine Ressource auf mehreren Servern läuft, wirken ihre üblichen Aktionen auf jeden Server:
- Das Ändern von Einstellungen oder der Version und das Neustarten erfolgen jeweils für einen Server, zuerst für die Kopien. Muss der Primary neu starten, übergibt er zuerst ohne Verlust an eine aktualisierte Kopie, sodass die Ressource weiter bedient.
- Das Pausieren, auch wenn die App, zu der sie gehört, heruntergefahren wird, stoppt zuerst die Kopien und dann den Primary, der seine Rolle behält, sodass kein Failover erfolgt. Das Fortsetzen startet zuerst den Primary.
- Bevor der Daemon eines Nodes aktualisiert wird, übergibt ein Primary auf diesem Node an eine fehlerfreie Kopie.
- Backups lesen von einer aktuellen Kopie, sofern es eine gibt, andernfalls vom Primary.
- Eine Kopie kann neu aufgebaut werden: Ihre Daten werden erneut vom Primary kopiert, und sie kann nicht übernehmen, bis das abgeschlossen ist. Server können hinzugefügt und entfernt werden; eine Gruppe behält mindestens zwei Server.
- Das Ein- oder Ausschalten von TLS einer Datenbank wird abgelehnt, solange Availability aktiv ist.
- Turn off availability behält den Primary als einzigen Server und entfernt die Kopien. Das Löschen der Ressource schaltet Availability zuerst aus.
Alarme und Hinweise
Abschnitt betitelt „Alarme und Hinweise“Die Alarmkategorien für Datenbanken und Managed storage bieten Ereignisse für Failover, Umschaltung, beeinträchtigt, kein automatisches Failover, wiederhergestellt, Server meldet sich nicht, Kopie nicht mehr synchron, Server jetzt weit entfernt, Witness verloren oder verschoben sowie Wiedereintritt und Neuaufbau, und Metriken für den Replikationsrückstand (Bytes und Sekunden) und die Umlaufzeit. Die Registerkarte Availability listet dieselben Ereignisse auf. Das Dashboard zeigt einen Hinweis, solange eine Gruppe kein Failover durchführen kann, solange der Primary eines replicated pair sich nicht meldet, solange ein Witness verloren ist, solange eine Gruppe beeinträchtigt ist, und für einen Tag nach einem Failover.
Tarif und Lizenz
Abschnitt betitelt „Tarif und Lizenz“Der Betrieb auf mehreren Servern ist eine Funktion von Business und Enterprise, einschließlich replicated pairs mit manuellem Failover. Nach der Lizenz-Kulanzfrist läuft alles weiter, was läuft: Failover, Fencing, Wiedereintritt von Kopien, Make this copy primary, Neuaufbau einer Kopie, Entfernen eines Servers, Ausschalten von Availability und Verschieben von Witnesses. Einschalten, Hinzufügen eines Servers und Ändern von Einstellungen werden abgelehnt, bis die Lizenz verlängert wird. Siehe Tarife und Leistungsumfang.
API und MCP
Abschnitt betitelt „API und MCP“REST: /api/databases/managed/{id}/availability und /api/managed-storage/{id}/availability (Vorabprüfung, Einschalten, Einstellungen, Mitglieder, zum Primary machen, Neuaufbau, Ereignisse, Ausschalten). Für Änderungen wird der Bearbeitungs-Scope der Ressource benötigt (databases:edit oder storage:edit), für das Lesen ihr Lese-Scope. MCP: die Availability-Aktionen von manage_managed_database und manage_managed_storage sowie set_witness_hosting von manage_relay_pool.