

Opfield Inference
Opfield Inference gibt einem Team einen einzigen Endpunkt für freigegebene KI-Modelle. Administratoren verbinden Anbieterkonten, fassen kompatible Quellen hinter stabilen öffentlichen Modell-IDs zusammen, entscheiden, wer welches Modell nutzen darf, und legen Limits pro Benutzer fest. Benutzer und Coding-Agenten erhalten ein einziges Opfield-Token statt Zugangsdaten für jeden Upstream-Anbieter.
Es ist eine von AI Workspace und Remote-MCP getrennte Datenebene. AI Workspace ist der in die Opfield-Oberfläche integrierte Assistent; MCP stellt externen Agenten Infrastrukturwerkzeuge bereit; Opfield Inference transportiert Modellanfragen und -antworten für kompatible KI-Clients. Das Aktivieren eines dieser Bestandteile aktiviert die anderen nicht stillschweigend, und ihre Zugangsdaten sind nicht austauschbar.
Was Opfield Inference löst
Abschnitt betitelt „Was Opfield Inference löst“- Eine Client-Konfiguration: Clients behalten dieselbe Opfield-Basis-URL und dieselbe öffentliche Modell-ID, während Administratoren kompatible Upstream-Quellen ändern.
- Zentrale Zugriffskontrolle: Veröffentlichte Modelle können auf ausgewählte Benutzer und Gruppen beschränkt werden.
- Isolation der Anbieter: Endbenutzer erhalten niemals das Abonnement oder die API-Zugangsdaten des Anbieters.
- Kapazitätsbewusstes Routing: Opfield berücksichtigt den Zustand der Verbindung, erkannte Kontingente, Budgets, Kompatibilität der Quelle und aktuelle Verfügbarkeit, bevor es eine Anfrage sendet.
- Normalisierte Nutzungserfassung: Abonnementkapazität wird zu Credits; die Nutzung über API-Schlüssel wird zu bepreisten Ausgaben; beides bleibt dem Opfield-Benutzer zuordenbar.
- Betriebliche Belege: Anfragen, Versuche, ausgewählte Quellen, Nutzung, Fehler und Endzustand werden erfasst, ohne Prompt- und Antwortinhalte in normale Aktivitätslogs zu schreiben.
Opfield schafft keine Anbieterkapazität und ersetzt nicht die Bedingungen des Anbieters zu Datenschutz, Verfügbarkeit, Datenresidenz oder Vertrag. Eine fehlerfreie Verbindung bedeutet, dass Opfield sie derzeit nutzen kann, nicht dass der Anbieter künftige Kapazität garantiert.
Architektur und Ablauf einer Anfrage
Abschnitt betitelt „Architektur und Ablauf einer Anfrage“flowchart TD Client[KI-Client<br/>Codex · Claude Code · SDK] --> API[Opfield Inference API<br/>stabile Modell-ID] API --> Admission[Benutzer authentifizieren<br/>Zugriff und Budgets prüfen] Admission --> Router[Inferenz-Router<br/>kompatible Quellen bewerten] Router --> Subscription[Abonnementquelle] Router --> ApiKey[API-Schlüssel-Quelle] Router --> Local[Andere kompatible Quelle] Subscription --> Provider[Ausgewählter Modellanbieter] ApiKey --> Provider Local --> Provider Provider --> Response[Gestreamte oder vollständige Antwort] Response --> Ledger[Nutzung abrechnen<br/>Credits oder API-Ausgaben] Ledger --> Client
Die Opfield-Anwendung ist für Benutzer, die Veröffentlichung von Modellen, Berechtigungen, Budgets und die sichtbare Nutzung zuständig. Der überwachte Inferenz-Kern ist für Protokollübersetzung und Ausführung zuständig. Anbieterverbindungen bleiben externe Abhängigkeiten, und der Client ist für den Prompt, Fortsetzungskennungen und die Verarbeitung der endgültigen Antwort zuständig.
Weg für Administratoren
Abschnitt betitelt „Weg für Administratoren“- Aktivieren Sie Inference unter Settings > General.
- Installieren Sie den überwachten Inferenz-Kern und warten Sie, bis er als fehlerfrei gemeldet wird.
- Fügen Sie eine Anbieterverbindung hinzu und schließen Sie ihren Authentifizierungsablauf ab.
- Warten Sie auf die Erkennung von Modellen und Kontingenten; veröffentlichen Sie nicht aus veralteten Erkennungsdaten.
- Erstellen Sie ein öffentliches Modell und hängen Sie eine oder mehrere protokollkompatible Quellen an.
- Legen Sie Kontext, Ausgabe, Modalität, Preise und Abonnementmultiplikatoren genau fest.
- Konfigurieren Sie eine Standard-Limitrichtlinie und fügen Sie dann bei Bedarf engere Überschreibungen pro Benutzer hinzu.
- Vergeben Sie
feat:ai:usenur an Benutzer oder Gruppen, die Inference aufrufen sollen. - Testen Sie eine normale Anfrage, einen Stream, ein abgelehntes Modell, ein ausgeschöpftes Limit und einen sicheren Ausfall einer Quelle.
Fügen Sie eine Ausweichquelle nur hinzu, wenn ihr Protokoll, ihre Modalitäten, ihre Kontextgröße, ihr Werkzeugverhalten und ihre Ausgabesemantik mit den anderen Quellen des Modells übereinstimmen.
Weg für Benutzer und Client-Endpunkte
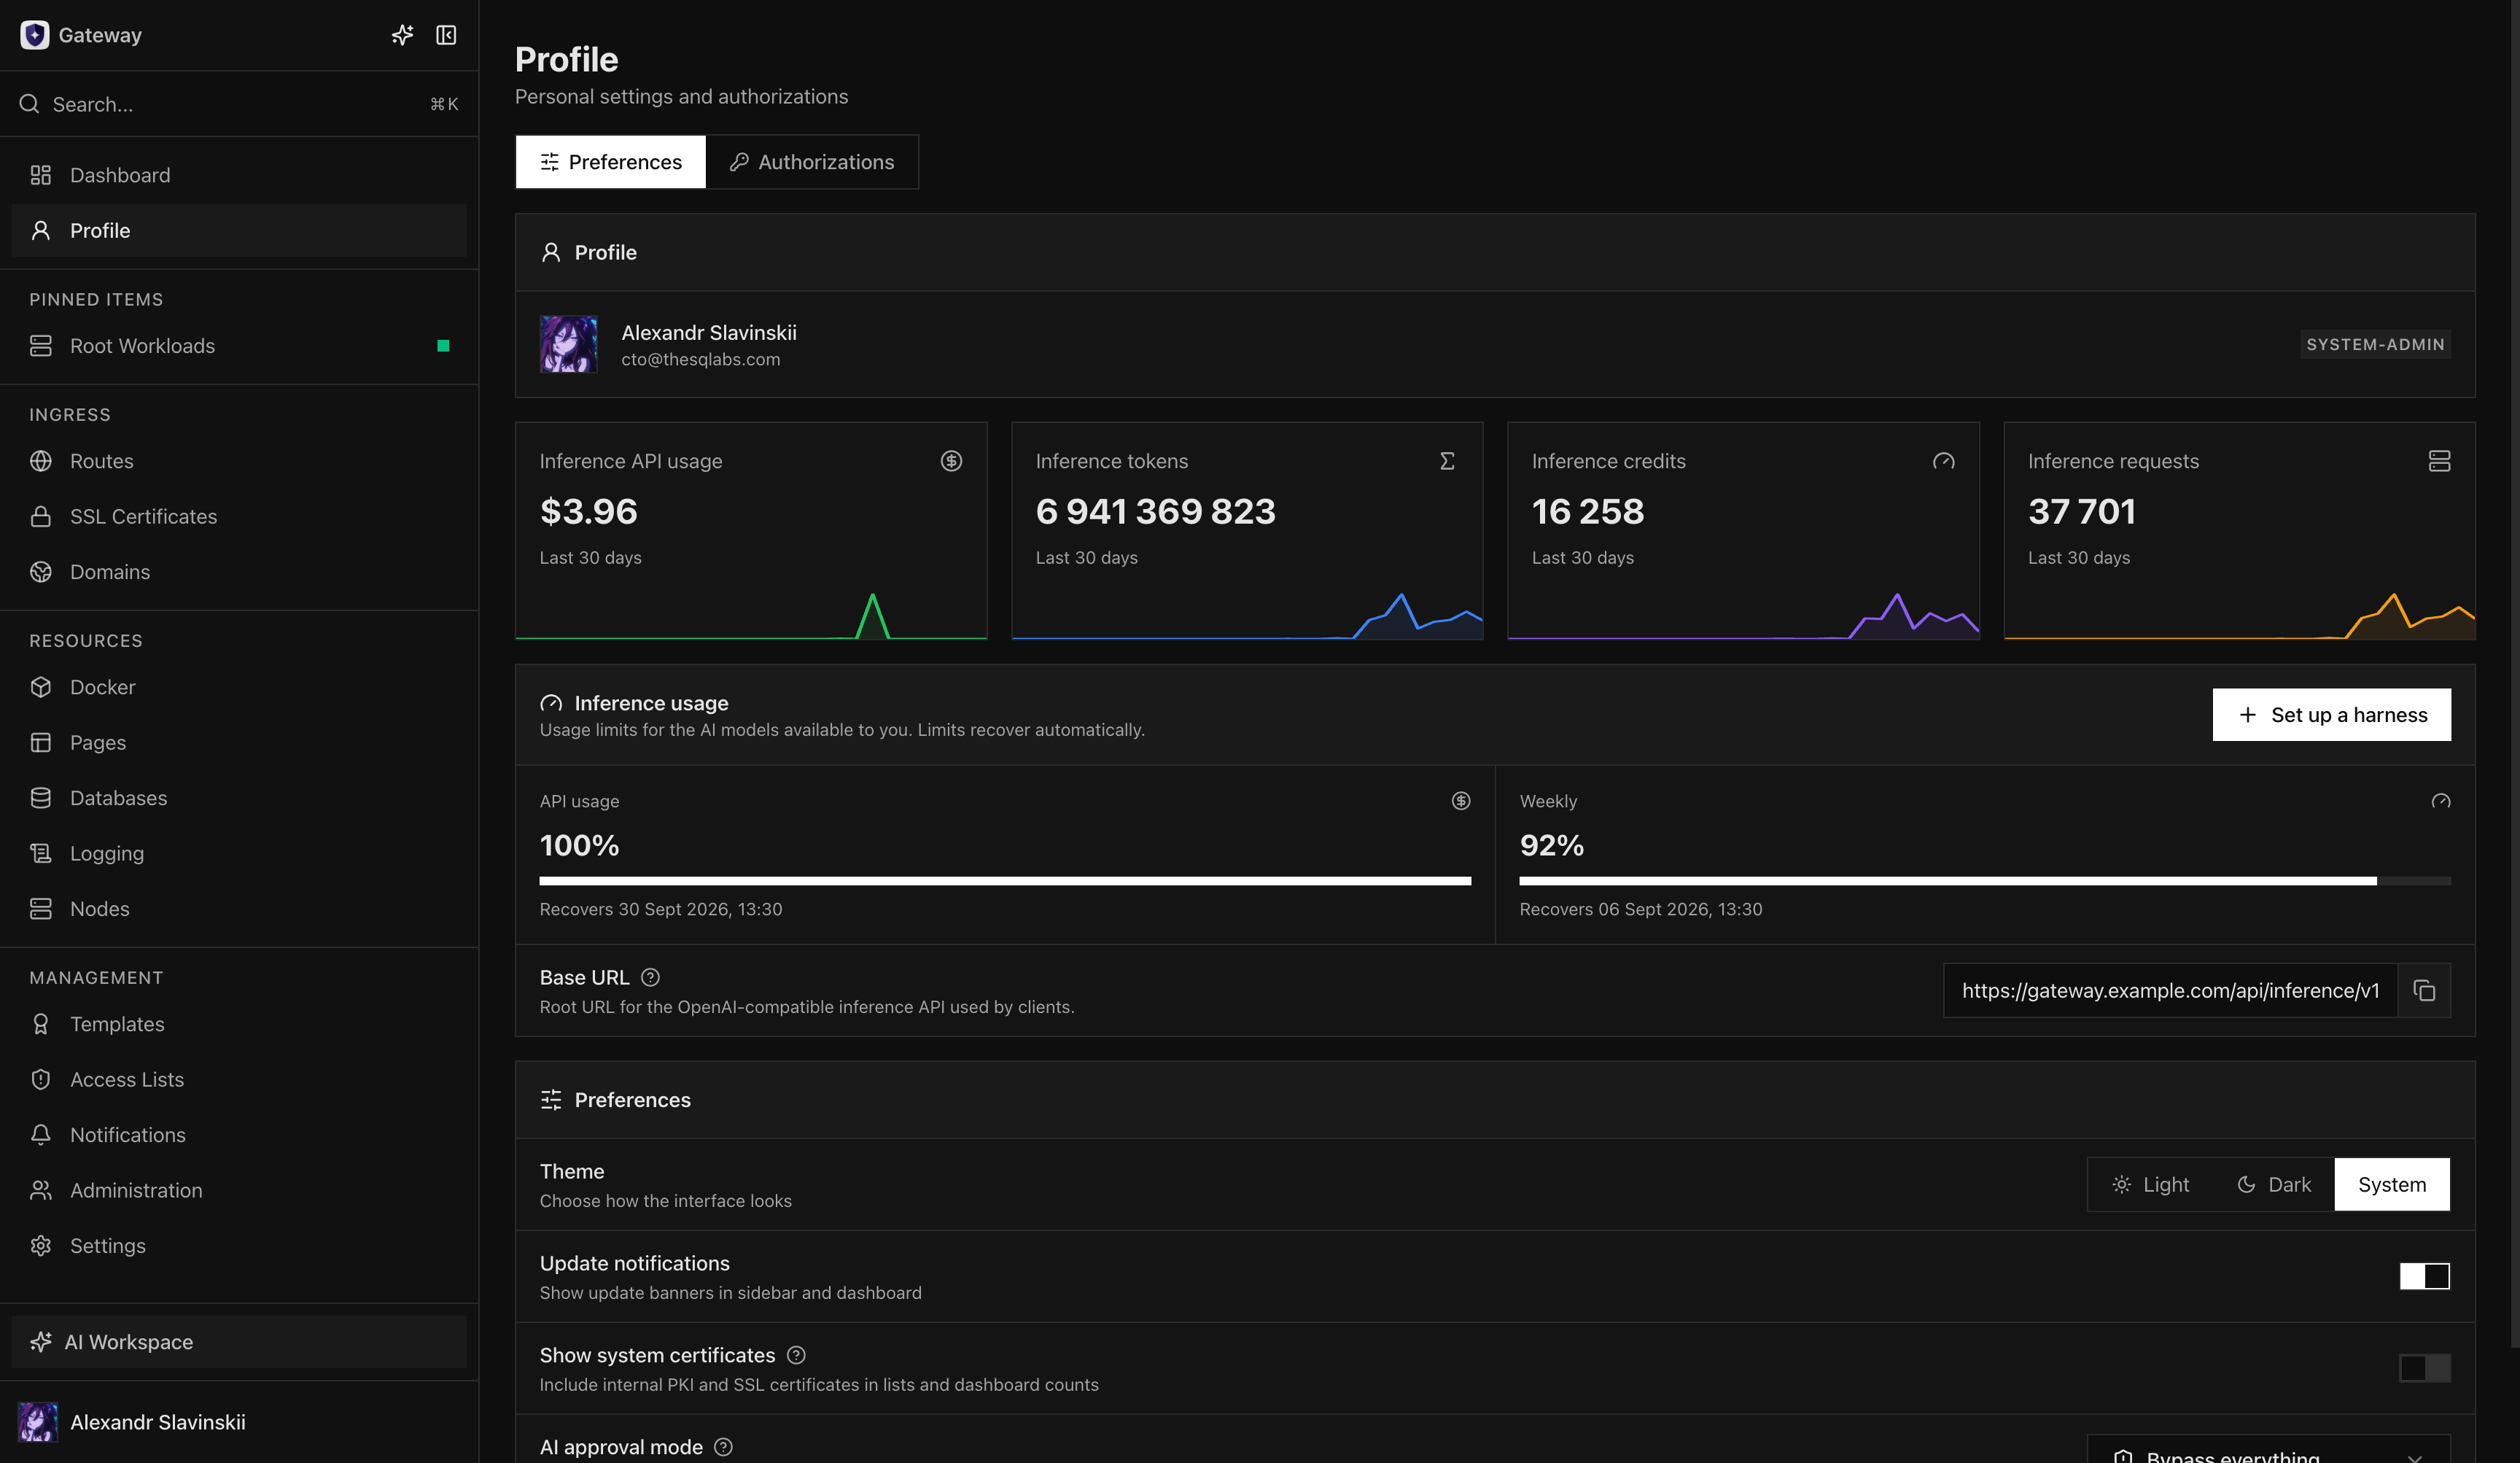
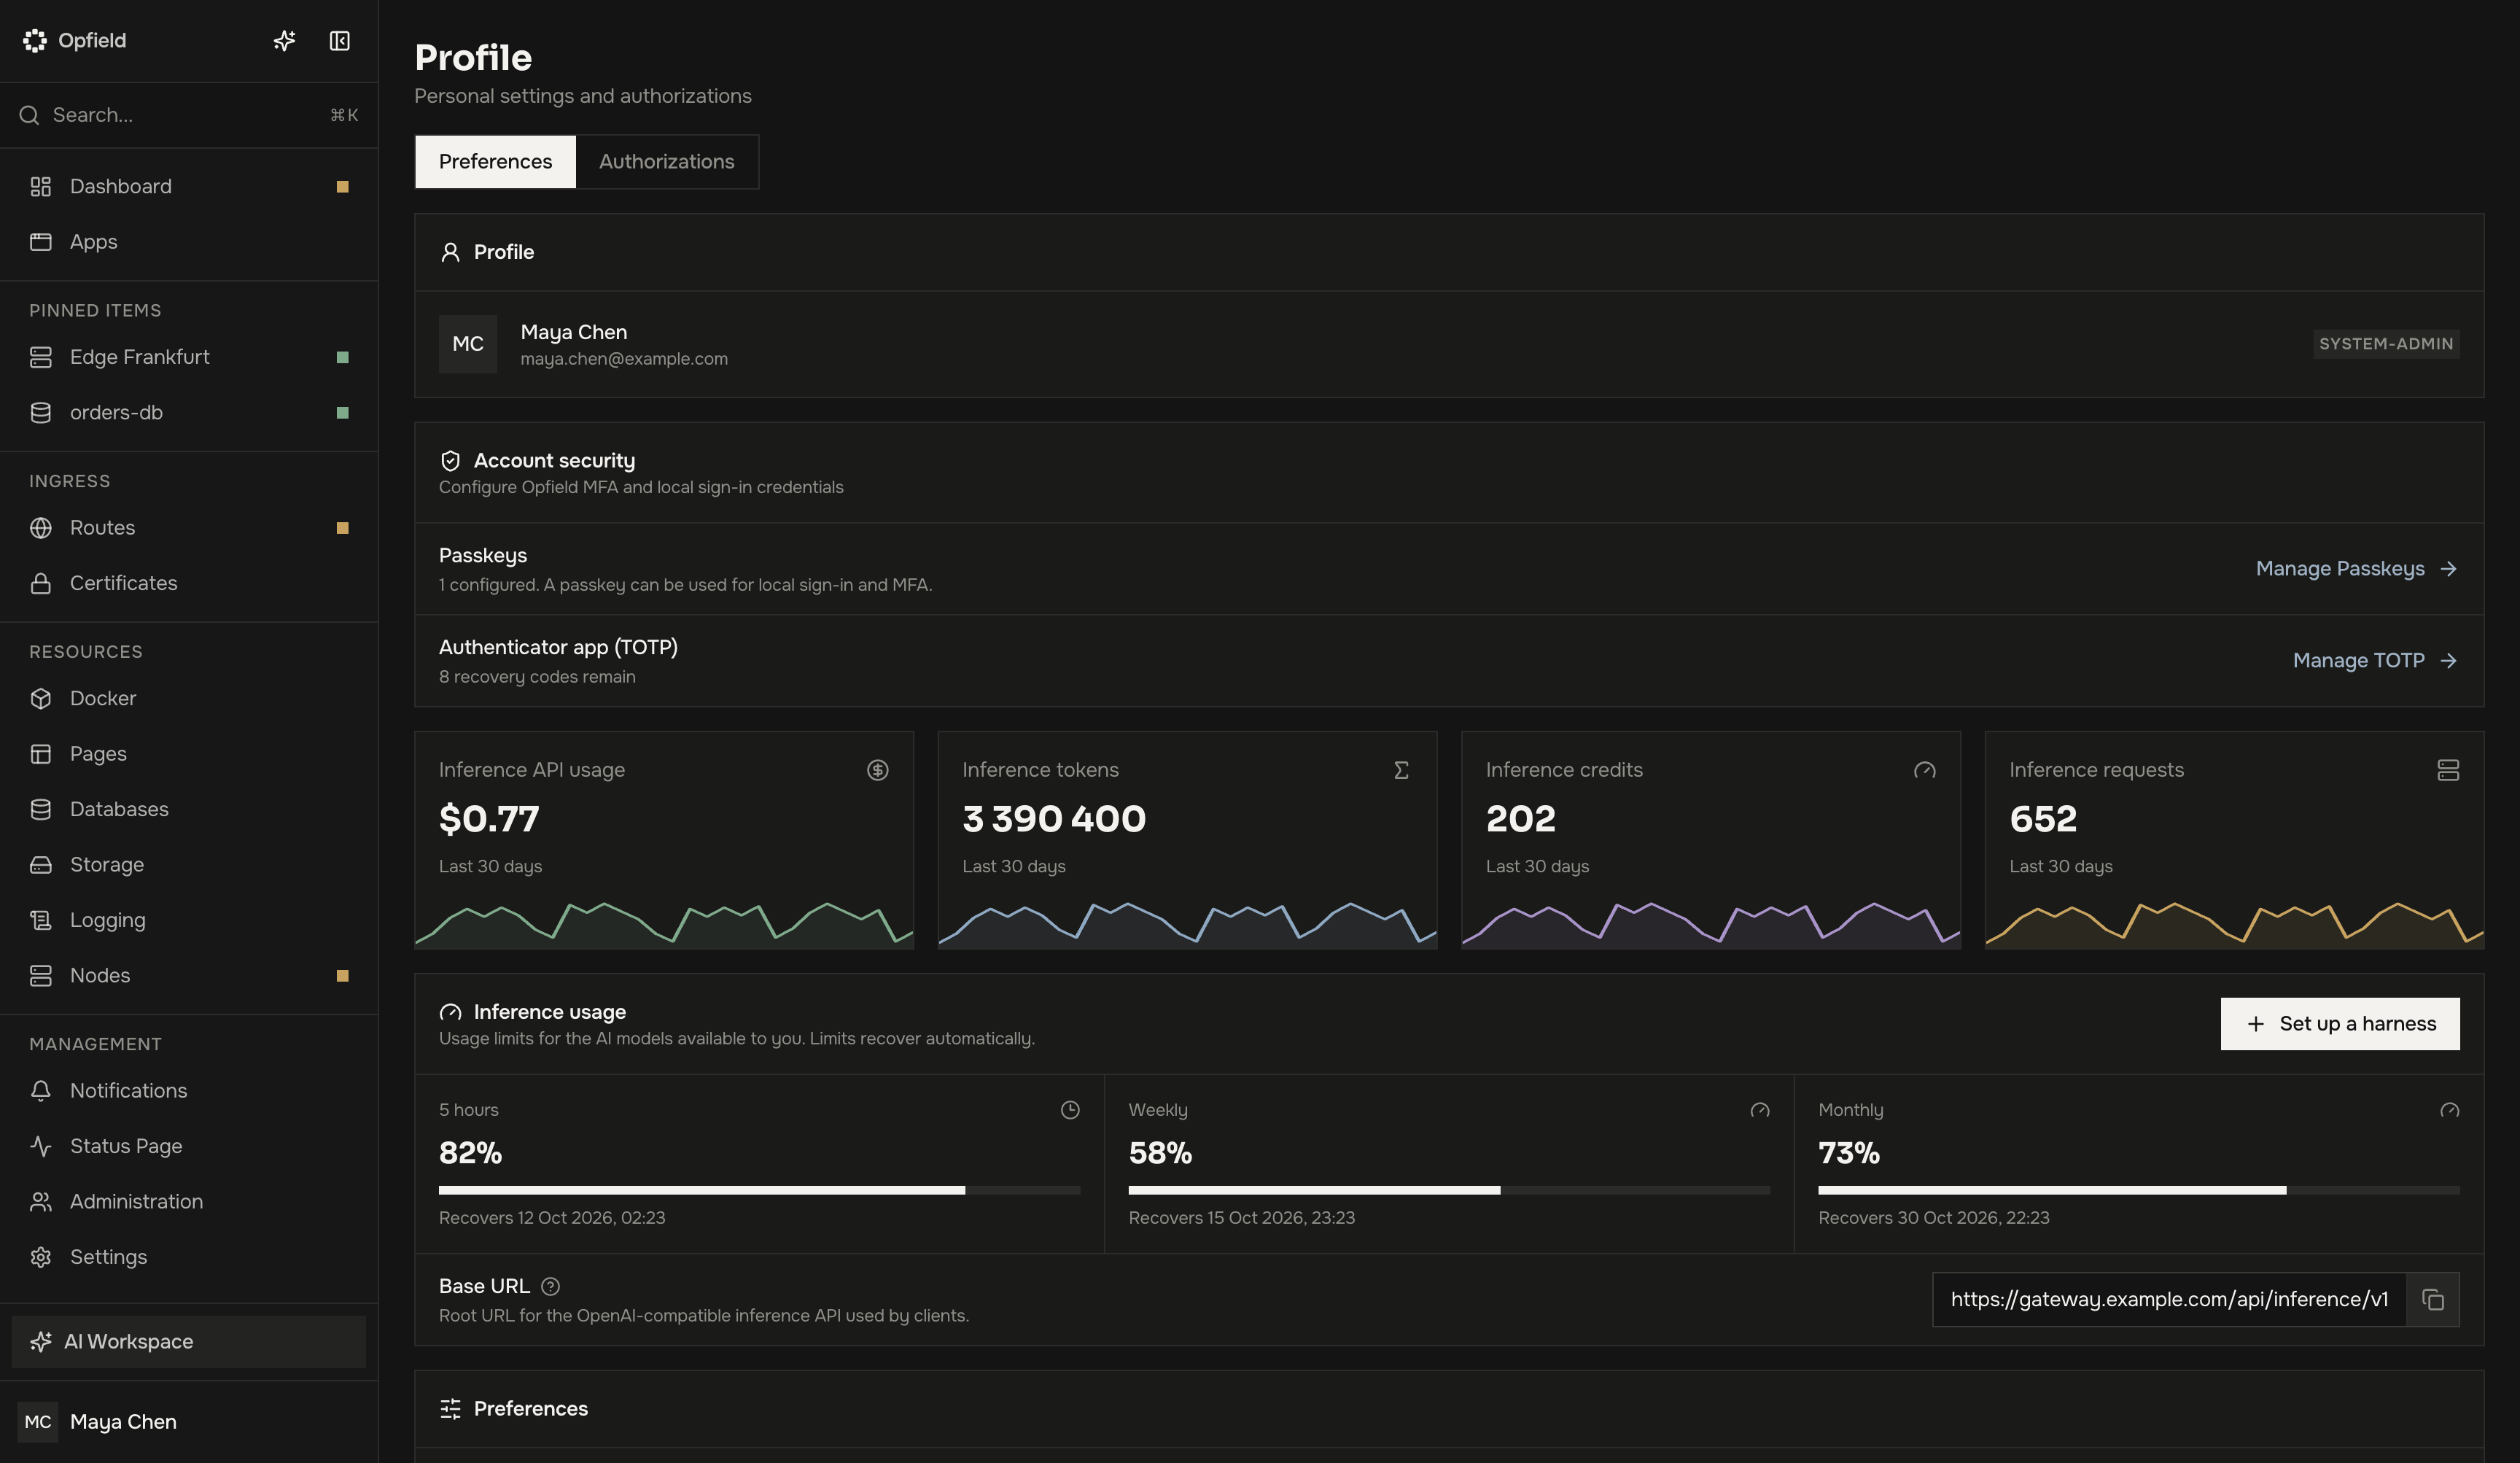
Abschnitt betitelt „Weg für Benutzer und Client-Endpunkte“Benutzer benötigen feat:ai:use. Um einen Harness zu verbinden, klicken Sie auf Set up a harness im Bereich Inference usage unter Profile (angezeigt, wenn mindestens ein Limit für den Benutzer gilt) oder in der Zeile Inference endpoints unter Settings > Inference. Der Dialog Set Up an Inference Harness zeigt die Werte, die Sie in die eigenen Anbietereinstellungen des Harness einfügen:
- OpenAI-kompatible Basis-URL:
https://opfield.example.com/api/inference/v1; - Anthropic-kompatible Basis-URL:
https://opfield.example.com/api/inference; Anthropic-Clients ergänzen/v1/messagesselbst; - API-Schlüssel: ein neues
gwi_-Token, das der Dialog für den Benutzer erstellt und einmal anzeigt. Jedes Öffnen widerruft die Schlüssel aus früheren Öffnungen, die noch kein Client verwendet hat; - Modell: jedes Modell, das dem Benutzer zur Verfügung steht.
Der empfohlene Harness ist DeepSeek harness: Fügen Sie Opfield in dessen Einstellungen mit diesen Werten als Anbieter hinzu. Jeder andere Harness und jedes SDK, das einen OpenAI- oder Anthropic-kompatiblen Anbieter akzeptiert, wird auf dieselbe Weise eingerichtet.
Um ein Token ohne den Dialog zu erstellen, verwenden Sie Profile > Authorizations > Inference API Tokens. Das Token wird einmal angezeigt und gehört diesem Benutzer.
| Client-Familie | Basis-URL |
|---|---|
| OpenAI-kompatible Clients | https://opfield.example.com/api/inference/v1 |
| Anthropic SDK und Claude-kompatible Clients | https://opfield.example.com/api/inference |
Verwenden Sie die vom Administrator veröffentlichte öffentliche Modell-ID, nicht den Modellnamen eines Upstream-Anbieters. GET /api/inference/v1/models listet die Modelle auf, die ein gwi_-Schlüssel aufrufen kann; die Konsole liest dieselbe Liste mit der Sitzung des Benutzers über GET /api/inference/catalog.
Anbieter, Quellen und öffentliche Modelle
Abschnitt betitelt „Anbieter, Quellen und öffentliche Modelle“Eine Anbieterverbindung stellt ein authentifiziertes Upstream-Konto oder einen Upstream-Endpunkt dar. Die Erkennung erfasst die Modelle, technischen Fähigkeiten und Kontingentinformationen, die diese Verbindung aktuell meldet, und füllt Modelllimits, Reasoning-Stufen und Modalitäten aus der aktuellen Modellliste des Anbieters. Kann der Inferenz-Kern das Konto nicht lesen oder muss es erneut angemeldet werden, meldet die Synchronisation diesen Grund statt eines Erfolgs, und ein alter Kontingentwert wird nicht als aktuell gespeichert. Gehen beim Failover die Konten aus, erhalten Clients den tatsächlichen Fehler des Anbieters, etwa Authentifizierung, Kontingent oder Ablehnung. Claude Fable 5.1, Mythos 5.1 und Opus 5.5 werden erkannt; bei Modellen mit Fable 5.1 und Opus 5.5, die vor 2.11 veröffentlicht wurden, sind Werkzeuge deaktiviert, und sie müssen erneut gespeichert werden.
Eine Quelle verbindet ein erkanntes Anbietermodell mit einem veröffentlichten Opfield-Modell. Eine Quelle kann den Abonnementmultiplikator überschreiben, wenn ihre tatsächlichen Kapazitätskosten vom Modellstandard abweichen. Das Deaktivieren einer Quelle entfernt sie aus dem neuen Routing, ohne dass Clients die öffentliche Modell-ID ändern müssen.
Ein veröffentlichtes Modell ist der stabile Vertrag, der Benutzern bereitgestellt wird. Es legt die öffentliche ID, Kontext- und Ausgabelimits, Fähigkeiten, Zugriffsregeln und kompatible Quellen fest. Ähnliche Upstream-Namen reichen nicht aus: Zwei Quellen sind nur dann sichere Alternativen, wenn ihr Anfrageprotokoll und ihr für Benutzer sichtbares Verhalten kompatibel sind.
Anbieterquellen verwenden normalerweise einen von zwei Abrechnungsmodi:
| Quelltyp | Was Opfield begrenzt |
|---|---|
| Abonnement | Credits über aktivierte Zeitfenster von 5 Stunden, 7 Tagen und 30 Tagen |
| API-Schlüssel | Bepreiste Nutzung gegen ein Budget in USD pro Kalendermonat |
Lokale oder privat gehostete Endpunkte benötigen weiterhin eine ausdrückliche Preis- und Quellrichtlinie, wenn sie an der Budgetdurchsetzung teilnehmen. Veröffentlichen Sie keine Quelle mit unbekannten Fähigkeiten oder Preisen, nur weil ein Health Check erfolgreich ist.
Ein veröffentlichtes Modell kann außerdem einen System prompt für den Codex-Harness tragen. Append to harness default behält die Standardanweisungen von Codex bei, einschließlich seiner Regeln für Werkzeuge und Patch-Format, und fügt den Prompt danach an; Replace harness default ersetzt sie vollständig, daher muss ein Ersatz jede Regel erneut nennen, die das Modell weiterhin benötigt. Der Prompt erreicht ein Gerät bei seiner nächsten Aktualisierung des Modellkatalogs und dem nächsten Neustart von Codex.
Lebenszyklus einer Anfrage und Failover
Abschnitt betitelt „Lebenszyklus einer Anfrage und Failover“Für jede Anfrage führt Opfield Folgendes aus:
- Es validiert das
gwi_-Token und ermittelt den zugehörigen Benutzer. - Es löst das öffentliche Modell auf und prüft den Zugriff des Benutzers.
- Es bildet eine Menge geeigneter Quellen aus aktivierten Modellen, Quellen, Verbindungen, Protokollkompatibilität, Kontingent und Budgetzustand.
- Es reserviert eine vorsichtig bemessene Kapazität, bevor es einen Anbieter kontaktiert.
- Es sendet die Anfrage über den Inferenz-Kern und normalisiert Streaming, Nutzung und Fehler.
- Es versucht eine andere kompatible Quelle nur dann erneut, wenn der Fehler als wiederholbar eingestuft ist und eine weitere geeignete Quelle existiert.
- Es rechnet die Reservierung mit der tatsächlichen Anbieternutzung ab oder mit einer begrenzten Schätzung, wenn die genaue Nutzung nie eintrifft.
- Es schreibt einen Endzustand der Anfrage und einen Eintrag in das Nutzungsbuch.
Manche Protokolle erfordern für Fortsetzungen eine Bindung an die Quelle. Opfield bewahrt diese Bindung, solange sie gültig ist, und hebt sie auf, wenn der Lebenszyklus eine sichere Wiederholung erlaubt. Clients dürfen nicht annehmen, dass jeder Fehler auf einen anderen Anbieter ausweichen kann: Ungültige Eingaben, verweigerter Zugriff, eine ungültige Fortsetzungs-ID und ein ausgeschöpftes Benutzerbudget sind keine Failover-Ereignisse wegen Kapazität.
Streaming- und Nicht-Streaming-Anfragen müssen genau einen Endzustand erreichen. Prüfen Sie nach einer Netzwerkunterbrechung die erfasste Anfrage, bevor Sie ein möglicherweise teures Duplikat senden.
Bei langen stillen SSE-Antworten, einschließlich Compaction, sendet Opfield einen anfänglichen Keepalive-Kommentar und prüft alle 15 Sekunden, ob ein weiterer nötig ist. Kommentare werden nur zwischen vollständigen Ereignissen gesendet und wenn der Empfänger Daten annehmen kann. Sie sind weder Modellausgabe noch Abschlussereignisse; das tatsächliche Endereignis steuert weiterhin die Abrechnung. Das schützt den HTTP-Stream vor Leerlauf-Timeouts zwischengeschalteter Systeme.
Credits und Nutzungserfassung
Abschnitt betitelt „Credits und Nutzungserfassung“Credits sind ein normalisiertes Maß für den Verbrauch bei Abonnementanbietern. Sie sind kein Geld und bewusst nicht identisch mit rohen Token-Summen. Opfield gewichtet Token-Klassen und wendet dann die wirksamen Multiplikatoren der Quelle an.
Credit-Formel
Abschnitt betitelt „Credit-Formel“weighted tokens = uncached input tokens + cached input tokens × 0.10 + cache-write tokens × 1.25 + output tokens + reasoning tokens
public credits = weighted tokens ÷ 1,000,000 × model multiplier × burn multiplier × service-tier multiplierBei einem Gesamtmultiplikator von 1× entspricht ein öffentlicher Credit einer Million gewichteter Tokens.
| Bestandteil | Gewicht | Warum es abweicht |
|---|---|---|
| Nicht zwischengespeicherte Eingabe | 1.00 |
Vollständige Prompt-Verarbeitung |
| Gelesene zwischengespeicherte Eingabe | 0.10 |
Die Wiederverwendung eines bestehenden Anbieter-Caches ist günstiger |
| Cache-Schreibvorgang | 1.25 |
Das Erstellen eines Cache-Zustands verbraucht zusätzliche Kapazität |
| Ausgabe | 1.00 |
Generierte Tokens zählen vollständig |
| Reasoning | 1.00 |
Gemeldete Reasoning-Tokens zählen vollständig |
Die Multiplikatoren bedeuten:
- Modellmultiplikator: die Abonnementkosten des veröffentlichten Modells, optional durch eine bestimmte Quelle überschrieben.
- Burn-Multiplikator: schützt gemeinsam genutzte Abonnementkapazität, wenn das Anbieterkontingent schneller verbraucht wird, als die verbleibende Zeit erlaubt. Er beträgt normalerweise
1×, kann dynamisch steigen und ist auf8×begrenzt. Compaction-Anfragen verwenden1×. - Service-Tier-Multiplikator: OpenAI-Abonnementanfragen mit dem Tier
Fast/priorityverbrauchen2×Credits. Andere aktuelle Kombinationen verwenden1×.
Der Burn-Multiplikator vergleicht das verbleibende Abonnementkontingent mit der verbleibenden Zeit in jedem erkannten Zeitfenster des Anbieters. Vereinfacht dargestellt:
burn multiplier = min(8, max( 1, time remaining fraction ÷ quota remaining fraction, 0.30 ÷ quota remaining fraction))Opfield berechnet den Multiplikator pro Modell über die Abonnementkonten dieses Modells. Ein Kontingentfenster, das ein Anbieter auf eine Modellfamilie beschränkt, zählt nur für diese Familie. Fehlende Kontingentdaten belassen den Multiplikator bei 1×; veraltete, leere oder ausgeschöpfte erkannte Kontingente können den schützenden Wert 8× erzwingen.
Rechenbeispiel
Abschnitt betitelt „Rechenbeispiel“Angenommen, eine Woche enthält:
- 600 Millionen nicht zwischengespeicherte Eingabe-Tokens;
- 1,5 Milliarden zwischengespeicherte Eingabe-Tokens;
- 100 Millionen Cache-Schreib-Tokens;
- 300 Millionen Ausgabe-Tokens;
- 50 Millionen Reasoning-Tokens.
Die gewichtete Summe beträgt:
600M + 1,500M × 0.10 + 100M × 1.25 + 300M + 50M= 1,225M weighted tokensMit einem Modellmultiplikator von 2×, einem Burn-Multiplikator von 1.25× und dem normalen Service-Tier von 1×:
1,225M ÷ 1M × 2 × 1.25 × 1 = 3,062.5 creditsDeshalb können zwei Benutzer mit ähnlichen rohen Token-Summen unterschiedlich viele Credits verbrauchen: Cache-Verhalten, Modellwahl, Kontingentdruck beim Anbieter und Service-Tier spielen alle eine Rolle.
Empfohlene wöchentliche Credit-Limits
Abschnitt betitelt „Empfohlene wöchentliche Credit-Limits“Das 7-Tage-Limit ist ein Nutzungsfenster, das mit der ersten über ein Abonnement abgerechneten Anfrage des Benutzers beginnt, kein Kontingent pro Kalenderwoche. Diese Werte sind ungefähre Ausgangspunkte für einen Benutzer, der Coding-Agenten oder andere Workloads mit langem Kontext ausführt:
| Wöchentliches Limit | Nutzungsprofil | Praktische Bedeutung |
|---|---|---|
2,500 Credits |
Gering | Gelegentliche Agentensitzungen und kurze tägliche Arbeit |
5,000 Credits |
Regelmäßig | Tägliche Entwicklung mit moderatem Kontext und Werkzeugeinsatz |
7,500 Credits |
Intensiv | Häufige lange Sitzungen, mehrere Repositories oder wiederholte Arbeit mit großem Kontext |
10,000 Credits |
Hoch | Anhaltende tägliche Agentennutzung mit starkem Kontextwechsel |
15,000 Credits |
Sehr hoch | Nahezu durchgehende Power-User- oder Multi-Agenten-Workloads |
Behandeln Sie die Tabelle als Richtlinien-Grundlage, nicht als Zusage einer festen Anzahl von Anfragen oder Tokens. Beginnen Sie mit dem nächstliegenden Profil, beobachten Sie mindestens ein vollständiges 7-Tage-Fenster und passen Sie es dann an die tatsächlichen Modell- und Burn-Multiplikatoren an. Verwenden Sie Richtlinien pro Benutzer, statt ein gemeinsames Limit mit der Teamgröße zu multiplizieren.
Nutzungsfenster und Sicherheitsmarge
Abschnitt betitelt „Nutzungsfenster und Sicherheitsmarge“Die Abonnementnutzung kann unabhängig über 5 Stunden, 7 Tage und 30 Tage begrenzt werden. Eine Belastung wird in jedem aktivierten Fenster gezählt. Jedes Fenster beginnt mit der ersten über ein Abonnement abgerechneten Anfrage des Benutzers nach dem Ende des vorherigen Fensters und wird bei Ablauf vollständig zurückgesetzt; das nächste Fenster beginnt mit der nächsten solchen Anfrage. Die Oberfläche zeigt für jedes Fenster den Zeitpunkt der Zurücksetzung an.
Opfield reserviert Kapazität, bevor es eine Anfrage sendet, und das vollständig konfigurierte Abonnementlimit ist nutzbar. Eine Anfrage, die zugelassen wurde, solange der Benutzer noch ein positives Guthaben hat, läuft immer bis zum Ende, sodass die letzte Runde das Limit geringfügig überschreiten kann; Opfield kürzt niemals eine zugelassene Anfrage. Die nächste Anfrage nach Ausschöpfen des Guthabens wird mit der Erholungszeit des Fensters abgelehnt.
Quellen mit API-Schlüssel verbrauchen keine Abonnement-Credits. Opfield bepreist nicht zwischengespeicherte Eingabe, zwischengespeicherte Eingabe, Cache-Schreibvorgänge, Ausgabe, Reasoning und unterstützte Einheitenkosten anhand der aktuellen Preis-Momentaufnahme der Quelle und wendet dann das konfigurierte monatliche Limit in USD an. Gleichen Sie diese betriebliche Schätzung mit der Abrechnung des Anbieters ab, bevor Sie finanzielle Entscheidungen treffen.
Sichtbarkeit und Verwaltung der Nutzung
Abschnitt betitelt „Sichtbarkeit und Verwaltung der Nutzung“Benutzer sehen ihre aktuelle Inference-Nutzung und die Erholungsfenster unter Profile. Das Dashboard kann knappe oder ausgeschöpfte Fenster anzeigen. Administratoren mit Zugriff auf die Nutzung können Systemsummen, Richtlinien pro Benutzer, Anfrageaktivität, Token-Klassen, Credits, API-Ausgaben, ausgewählte Modelle und Endstatus prüfen.
Konfigurieren Sie zuerst die Systemstandards. Eine Richtlinie pro Benutzer kann den Standard einengen, darf aber eine global deaktivierte Dimension nicht stillschweigend wieder öffnen. Setzen Sie die Nutzung nur aus einem ausdrücklichen betrieblichen Grund zurück; ein Limit zu erhöhen ist meist klarer, als den Verlauf zu löschen, mit dem ein Vorfall erklärt wird.
Grenzen bei Datenschutz und Zugangsdaten
Abschnitt betitelt „Grenzen bei Datenschutz und Zugangsdaten“Opfield schreibt keine Prompt- oder Modellausgabeinhalte in normale Aktivitätseinträge. Es speichert normalisierte Metadaten, Token-Klassen, Kosten, ausgewählte Quelle, Versuche, Fehler und Endzustand. Der ausgewählte Anbieter erhält dennoch den Inhalt der Anfrage, prüfen Sie daher dessen Bedingungen zu Aufbewahrung, Training, Datenresidenz und Datenverarbeitung, bevor Sie ihn veröffentlichen.
gwi_-Tokens sind nur für Opfield Inference gültig. Browsersitzungen, gw_-REST-API-Tokens, gwo_-OAuth-Tokens, gwl_-Logging-Tokens und MCP-Autorisierung können sie nicht ersetzen. Verwenden Sie getrennte Tokens für getrennte Clients und widerrufen Sie ein Token, wenn sich sein Client oder Eigentümer ändert.
Private Upstream-Adressen sind standardmäßig gesperrt. Erlauben Sie sie nur, wenn der Administrator die Vertrauensgrenze des Netzwerks bewusst akzeptiert und den Pfad gegen Server-Side Request Forgery und unbeabsichtigten internen Zugriff geschützt hat.
Fehlerdiagnose
Abschnitt betitelt „Fehlerdiagnose“| Symptom | Zuerst prüfen |
|---|---|
401 |
Das gwi_-Token existiert, ist nicht widerrufen und wird an die Inference-Basis-URL gesendet |
| Modell nicht gefunden oder abgelehnt | Öffentliche Modell-ID, Gruppenzugriff, Aktivierung der Quelle und veröffentlichte Fähigkeiten |
| Kapazität nicht verfügbar | Aktuelle Erkennung, Anbieterkontingent, Verbindungszustand, geeignete Ausweichquellen |
| Budget ausgeschöpft | Credits des Benutzers für 5 h/7 d/30 d oder monatliches API-Limit in USD und Erholungszeit |
| Fortsetzung abgelehnt | Ursprüngliche Quellbindung, Fortsetzungskennung und Anbieterkompatibilität |
| Stream endet ohne Abschluss | Trennung durch den Client, Endereignis des Anbieters, Zustand des Anfrageversuchs und Abgleich |
| Nutzung erscheint unerwartet hoch | Cache-Klassifizierung, Modellmultiplikator, dynamischer Burn-Multiplikator und Tier Fast/priority |
| API-Ausgaben weichen von der Rechnung ab | Preis-Momentaufnahme, Tier für langen Kontext, Kosten ohne Token-Bezug und Abrechnung des Anbieters |
Prüfen Sie in dieser Reihenfolge den Zustand des Inferenz-Kerns, den Zustand der Anbieterverbindung, erkannte Modelle und Kontingente, Veröffentlichungsregeln, Token-Zugriff, Benutzerlimits, geeignete Kandidaten und Protokollkompatibilität. Ein Neustart des Kerns ersetzt nicht die Korrektur eines ungültigen Anbieter- oder Modellvertrags.
Einführung und Rollback
Abschnitt betitelt „Einführung und Rollback“Testen Sie für jedes neue Modell beide beworbenen Protokolle, den Abschluss von Streams, das Ausschöpfen des Budgets, ein abgelehntes Modell, widerrufene Tokens und ein sicheres Failover einer Quelle. Legen Sie wöchentliche Limits anhand der empfohlenen Werte fest und vergleichen Sie die Opfield-Nutzung mit der Kapazität oder Abrechnung des Anbieters.
Um ein Modell zurückzuziehen, vergeben Sie keinen neuen Zugriff mehr, ermitteln Sie die Clients, die seine öffentliche ID verwenden, und stellen Sie einen getesteten Ersatz bereit. Wird eine Quelle unsicher oder nicht verfügbar, deaktivieren Sie diese Quelle und prüfen Sie das Kandidaten-Routing, bevor Sie das öffentliche Modell wieder aktivieren. Richten Sie eine bestehende öffentliche ID nicht auf ein wesentlich anderes Modell, nur damit Anfragen weiterhin 200 liefern.