

Verwaltete Datenbanken
Verwaltete Datenbanken stellen von Opfield gesteuerte PostgreSQL-, Key-Value- und ClickHouse-Instanzen auf Storage Nodes bereit. Neue verwaltete Key-Value-Stores laufen mit Valkey und funktionieren mit Redis-Clients; siehe Key-Value-Stores. Opfield ist für den Lebenszyklus der Ressource und die Sollkonfiguration zuständig; der Storage Node ist für die laufende Engine und ihre lokale Laufzeit zuständig. Ein Node, der offline ist, löscht daher nicht die erfasste Konfiguration der Instanz, und die Wiederherstellung beginnt mit dem Zustand des Nodes, nicht mit manuellen Änderungen an der Engine.
Eine verwaltete Instanz wird in einem Formular erstellt, läuft auf dem Storage Node, den Sie wählen, und erreicht Workloads über private Bindings. Eine verwaltete Datenbank läuft auf einem Server, sofern Sie sie nicht auf mehreren verfügbar machen. Opfield stellt sie bereit, konfiguriert, überwacht und sichert sie nach Zeitplan; die Backup-Richtlinie und Wiederherstellungstests, die Wahl der Engine-Version und die Kapazitätsplanung bleiben bei Ihnen. Einen direkten Vergleich mit externen Verbindungen finden Sie unter Verwaltete und externe Datenbanken im Überblick. Das Erstellen einer verwalteten Datenbank erfordert Personal oder höher.
Grenze der Fähigkeiten
Abschnitt betitelt „Grenze der Fähigkeiten“| Fähigkeit | Was Opfield bereitstellt | Was bei Ihnen bleibt |
|---|---|---|
| Bereitstellung | Eine begrenzte PostgreSQL-, Key-Value- oder ClickHouse-Instanz auf einem Storage Node oder mit Availability auf 2 bis 5 | Node-Kapazität, Platzierung, Dauerhaftigkeit des Speichers und freigegebene Engine-Version |
| Konfiguration und Lebenszyklus | Sollkonfiguration, Pausieren und Fortsetzen, Neustart, Wiederholung einer fehlgeschlagenen Bereitstellung, Größenänderung von CPU, Arbeitsspeicher, Swap und Speicher (Speicher kann nur wachsen), maximale Verbindungen bei PostgreSQL, Engine-Einstellungen bei Key-Value und ClickHouse, PostgreSQL-Erweiterungen, Veröffentlichung, Logs, Monitoring und Abläufe zur Außerbetriebnahme | Änderungsfenster, Kompatibilität der Anwendung, unabhängige Prüfung und Rollback-Entscheidung |
| Anwendungszugriff | Verwaltete private Bindings und optionale direkte TLS-Veröffentlichung | Client-Verhalten, Nutzung mit minimalen Rechten, Zertifikatsvertrauen und Richtlinie zur Rotation von Zugangsdaten |
| Backups | Geplante native Datenbank-Backups in eine Speicherverbindung und Wiederherstellung in eine neue verwaltete Datenbank, ab Personal | Backup-Richtlinie, Ziel außerhalb des Hosts, Aufbewahrung, Verschlüsselung des Ziels und regelmäßige Wiederherstellungstests |
| Point-in-Time-Recovery | Wird nicht automatisch bereitgestellt | WAL-, AOF- oder Engine-spezifische Architektur für kontinuierliche Backups und getestetes Wiederherstellungsverfahren |
| Replikation und automatisches Failover | In Business und Enterprise: ein Primary und 1 bis 4 Kopien auf anderen Storage Nodes, automatisches Failover mit Witnesses oder ein manuelles Paar; siehe Datenbanken und Speicher auf mehreren Servern | Wahl der Dauerhaftigkeit gegenüber dem angegebenen Datenverlustfenster, Witness-Hosts und Verhalten der Anwendung beim erneuten Verbinden |
| Änderungen der Engine-Version | Über die API und MCP ein Wechsel auf eine neuere Katalogversion derselben Engine: PostgreSQL innerhalb der Hauptversion, Valkey und ClickHouse auf die nächste Katalogversion; der Container wird auf dem neuen Image neu erstellt und behält seine Daten. Ein vor 2.12 erstellter Key-Value-Store kann einmalig von Redis auf Valkey wechseln | Wahl der Version und, bei einer anderen PostgreSQL-Hauptversion, Wiederherstellung eines Backups in eine neue Instanz |
| Notfallwiederherstellung | Opfield behält die Ressourcendefinition; verlorene Anwendungsdaten kommen nur aus einem Backup zurück | Unabhängiger Wiederherstellungsort, Datenkopien, Schlüssel, Wiederherstellung von DNS und Netzwerk sowie festgelegte RPO/RTO |
Verwaltete Datenbanken haben keine Point-in-Time-Recovery, und automatisches Failover erfordert Business oder Enterprise. Eine Datenbank, die Point-in-Time-Recovery benötigt, kann auf einer Plattform laufen, die sie bietet, und in Opfield als externe Verbindung registriert werden, mit denselben Health Checks, Explorer, Konsole und Backups. Eine fehlerfreie Opfield-Ressource beweist für sich genommen nicht, dass die Daten verfügbar sind.
Vor der Bereitstellung
Abschnitt betitelt „Vor der Bereitstellung“Sie benötigen die Berechtigung, die Datenbank zu erstellen und den ausgewählten Storage Node zu verwenden. Bestätigen Sie Engine und unterstützte Version, Verfügbarkeit des Nodes, Speicher- und Arbeitsspeicheranforderungen, den Backup-Plan und ob externer Client-Zugriff tatsächlich erforderlich ist. Wählen Sie die Kapazität vorsichtig und lassen Sie Raum für Engine-Overhead, temporäre Arbeit und Wiederherstellungsoperationen.
Lassen Sie die direkte Veröffentlichung deaktiviert, sofern ein externer Client keinen dokumentierten Bedarf hat. Private Anwendungskonnektivität sollte Bindings verwenden. Das Aktivieren der direkten Veröffentlichung ist eine bewusste Änderung der Erreichbarkeit der Instanz und öffnet keine Host-Firewall automatisch.
Lesen Sie vor der Bereitstellung den kuratierten Versionskatalog in der Oberfläche. Unterstützte Versionen sind ein betrieblicher Vertrag: Legen Sie keine beliebige Upstream-Patch-Version fest und behalten Sie keine veraltete Engine, nur weil ihr Container noch startet. Dokumentieren Sie für Produktionsdaten vor der Wahl einer Version den Upgrade-Weg und die Kompatibilität bei der Wiederherstellung. Jede Katalogversion ist auf einen Image-Digest festgelegt. Der Storage Node bezieht sie zuerst vom Opfield-Mirror in der GitHub Container Registry (ghcr.io) und weicht auf Docker Hub aus, wobei er in beiden Fällen denselben Digest prüft.
Bereitstellen und prüfen
Abschnitt betitelt „Bereitstellen und prüfen“- Wählen Sie Engine, unterstützte Version, Storage Node, Speichergröße und Arbeitsspeicherprofil.
- Prüfen Sie die standardmäßig private Netzwerkkonfiguration und jede Einstellung zur direkten Veröffentlichung.
- Erstellen Sie die Instanz und verfolgen Sie die Bereitstellungsoperation bis zum Abschluss.
- Warten Sie, bis die Instanz Ready anzeigt, bevor Sie ein Anwendungs-Binding erstellen oder sich auf Explorer, Konsole oder Metriken verlassen.
- Prüfen Sie den Zustand der Engine, aktuelle Logs, die Speichermeldung und einen erlaubten Verbindungsweg.
Die erste Prüfung sollte einen für die Engine geeigneten Schreibvorgang und ein Zurücklesen über dieselbe Identität enthalten, die der echte Client verwenden wird. Prüfen Sie bei PostgreSQL die vorgesehene Datenbank und das Schema; prüfen Sie bei einem Key-Value-Store den erwarteten Schlüsselzugriff und die Persistenzrichtlinie; prüfen Sie bei ClickHouse den Pfad zur Zieldatenbank bzw. -tabelle sowie Abfrage- und Speicherverhalten. Entfernen Sie synthetische Daten nach dem Test.
Fehler bei der Bereitstellung entstehen häufig durch nicht verfügbare Nodes, Kapazitätsgrenzen, Speichervorbereitung, nicht unterstützte Engine-Einstellungen oder den Start der Engine. Lesen Sie das Ergebnis der Operation, bevor Sie es erneut versuchen. Wiederholte Neustarts oder Neuerstellungsversuche können den ursprünglichen Fehler verschleiern und ersetzen nicht die Korrektur von Speicher- oder Konfigurationsvoraussetzungen.
Eine bestehende Instanz ändern
Abschnitt betitelt „Eine bestehende Instanz ändern“Pausieren und Fortsetzen steuern die Rechenleistung und bewahren dabei die Datenbankdaten. Rechnen Sie damit, dass normaler Zustand, Metriken, Explorer und Konsolenaktionen nicht verfügbar sind, solange die Instanz pausiert ist. Ein Neustart verursacht eine kurze Dienstunterbrechung und sollte abhängigen Anwendungen angekündigt werden, wenn sie sich nicht automatisch neu verbinden können.
Ändern Sie die Größe nur innerhalb der Grenzen von Engine und Speicher. Speicher kann wachsen, aber nicht schrumpfen, und Größenänderungen sowie Einstellungsänderungen sind nicht verfügbar, solange die Instanz pausiert ist. Eine Änderung kann nicht gespeichert werden, solange eine vorherige Änderung noch angewendet wird. Der Monitoring-Verlauf übersteht einen Zeitraum, in dem die Datenbank oder ihr Node offline war. Sichern Sie vor einer wesentlichen Kapazitätsänderung, verfolgen Sie die Operation der Größenänderung und prüfen Sie dann die Speichermeldung und das Verhalten der Anwendung.
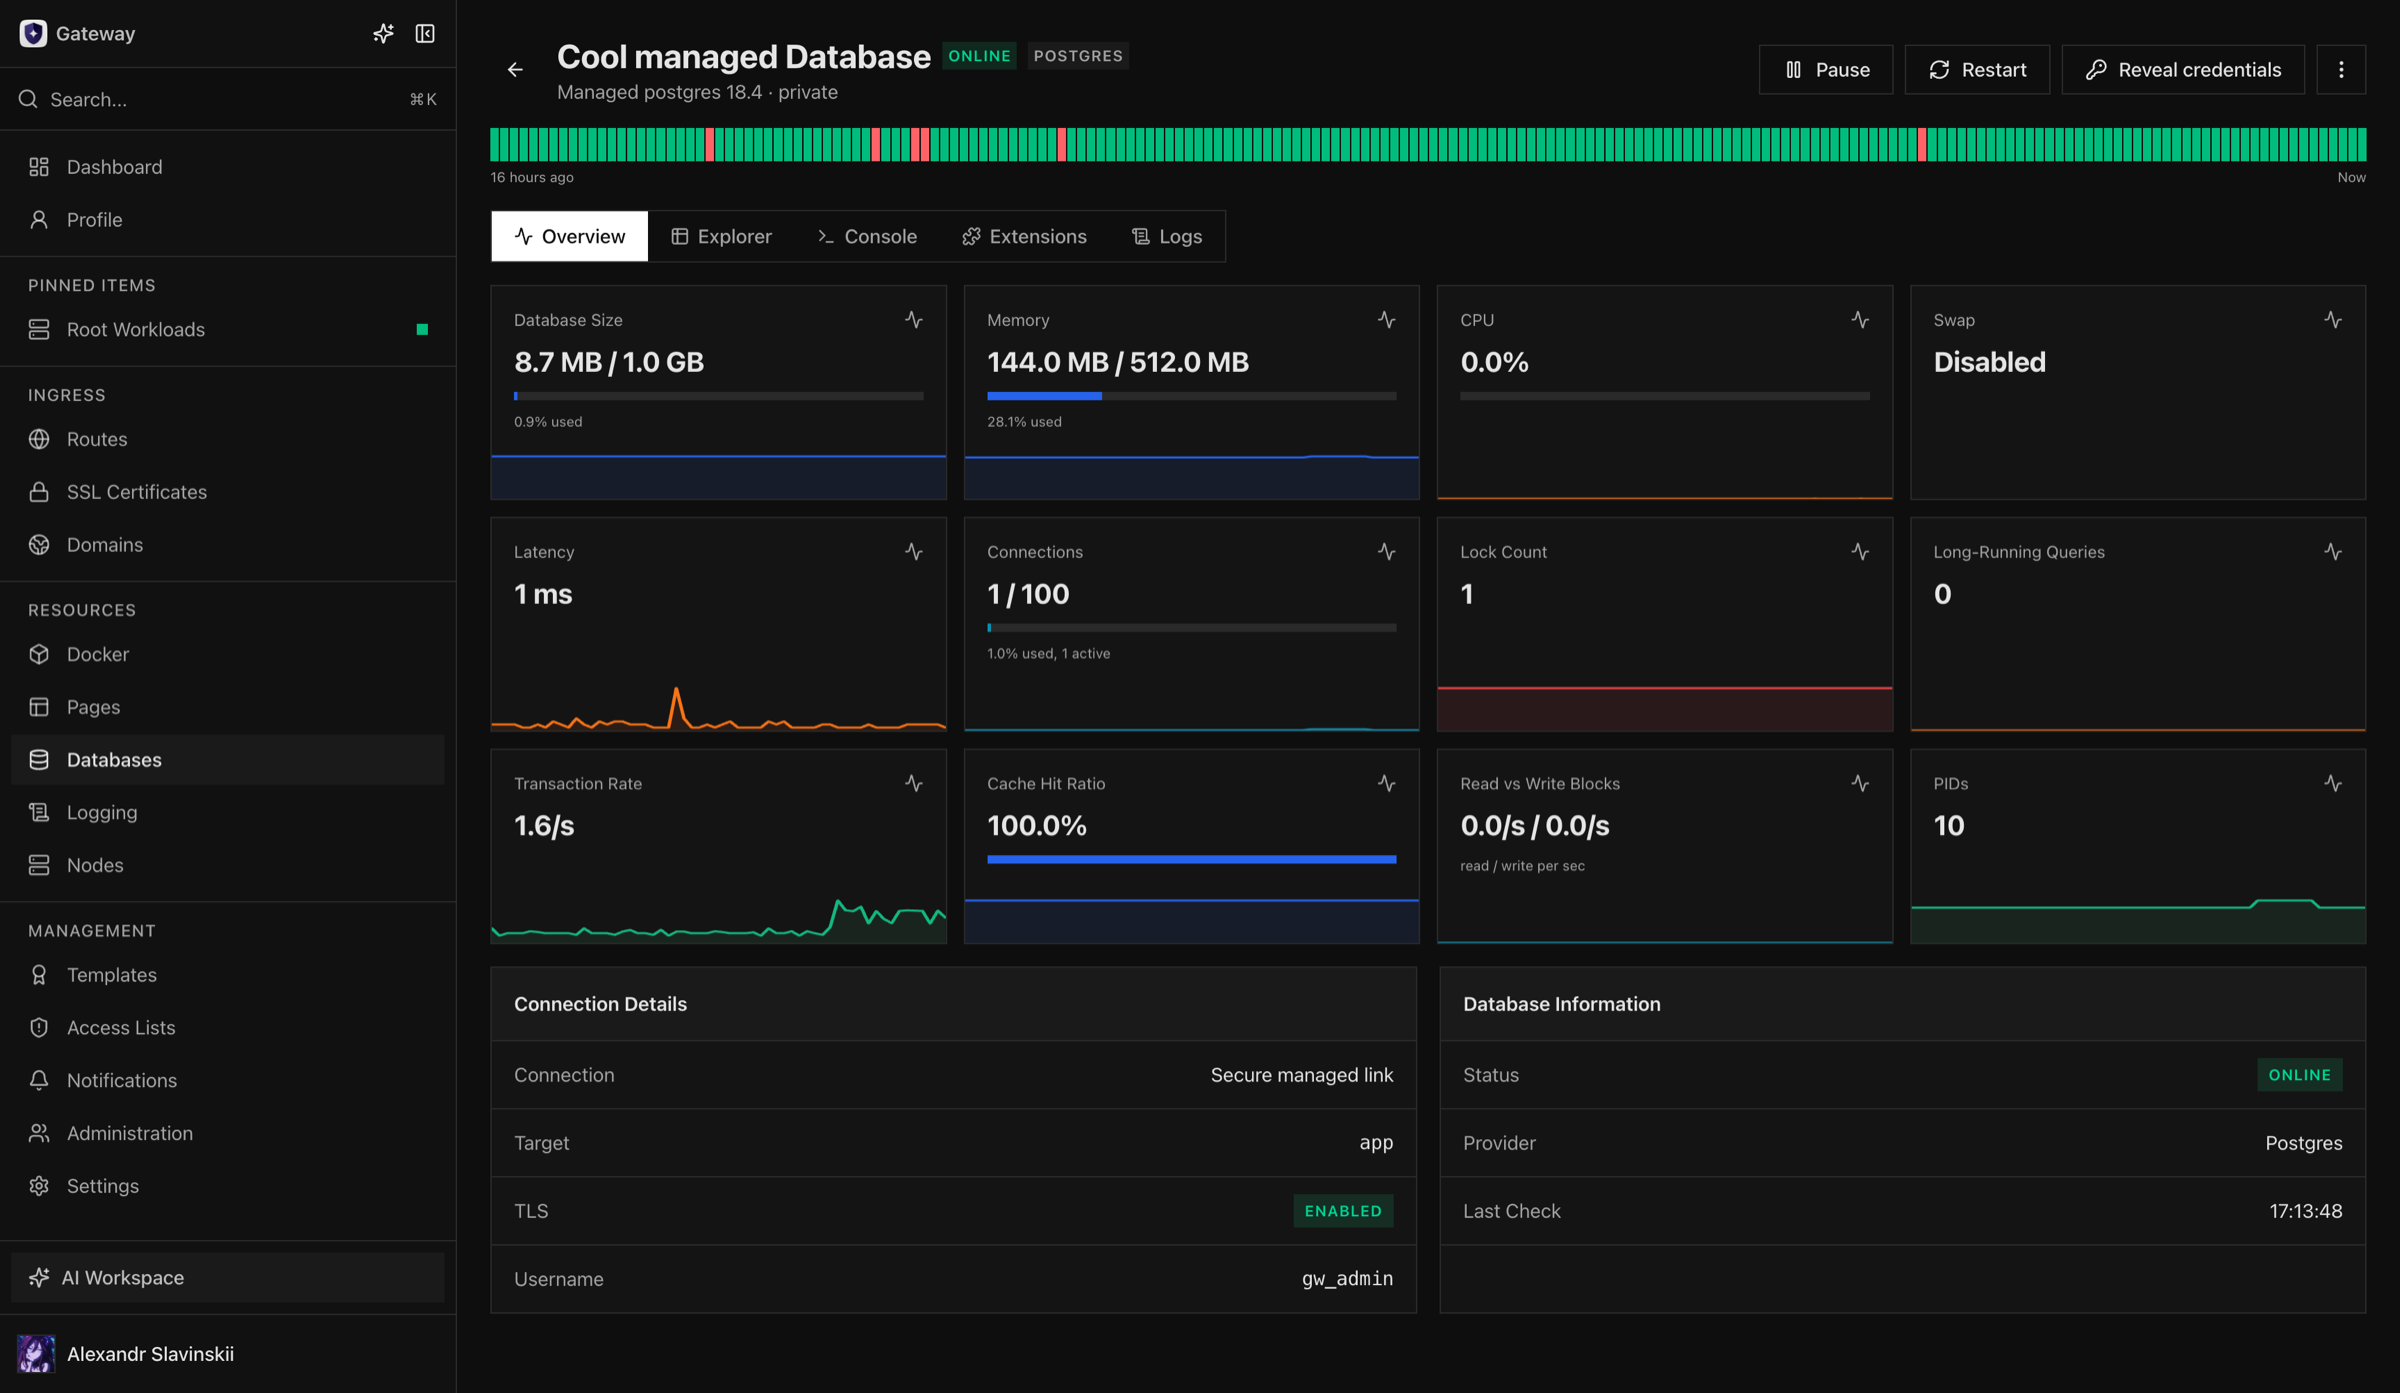
Bei PostgreSQL legt Maximum connections unter Database Settings max_connections fest: standardmäßig 100, von 20 bis 10.000 (postgresConfig.maxConnections in der API und in manage_managed_database update). Das Speichern eines neuen Werts erstellt den Container neu. Derselbe Wert ist die Kapazität der Verbindungen der Datenbank; siehe Verbindungskapazität und Verbindungspools.
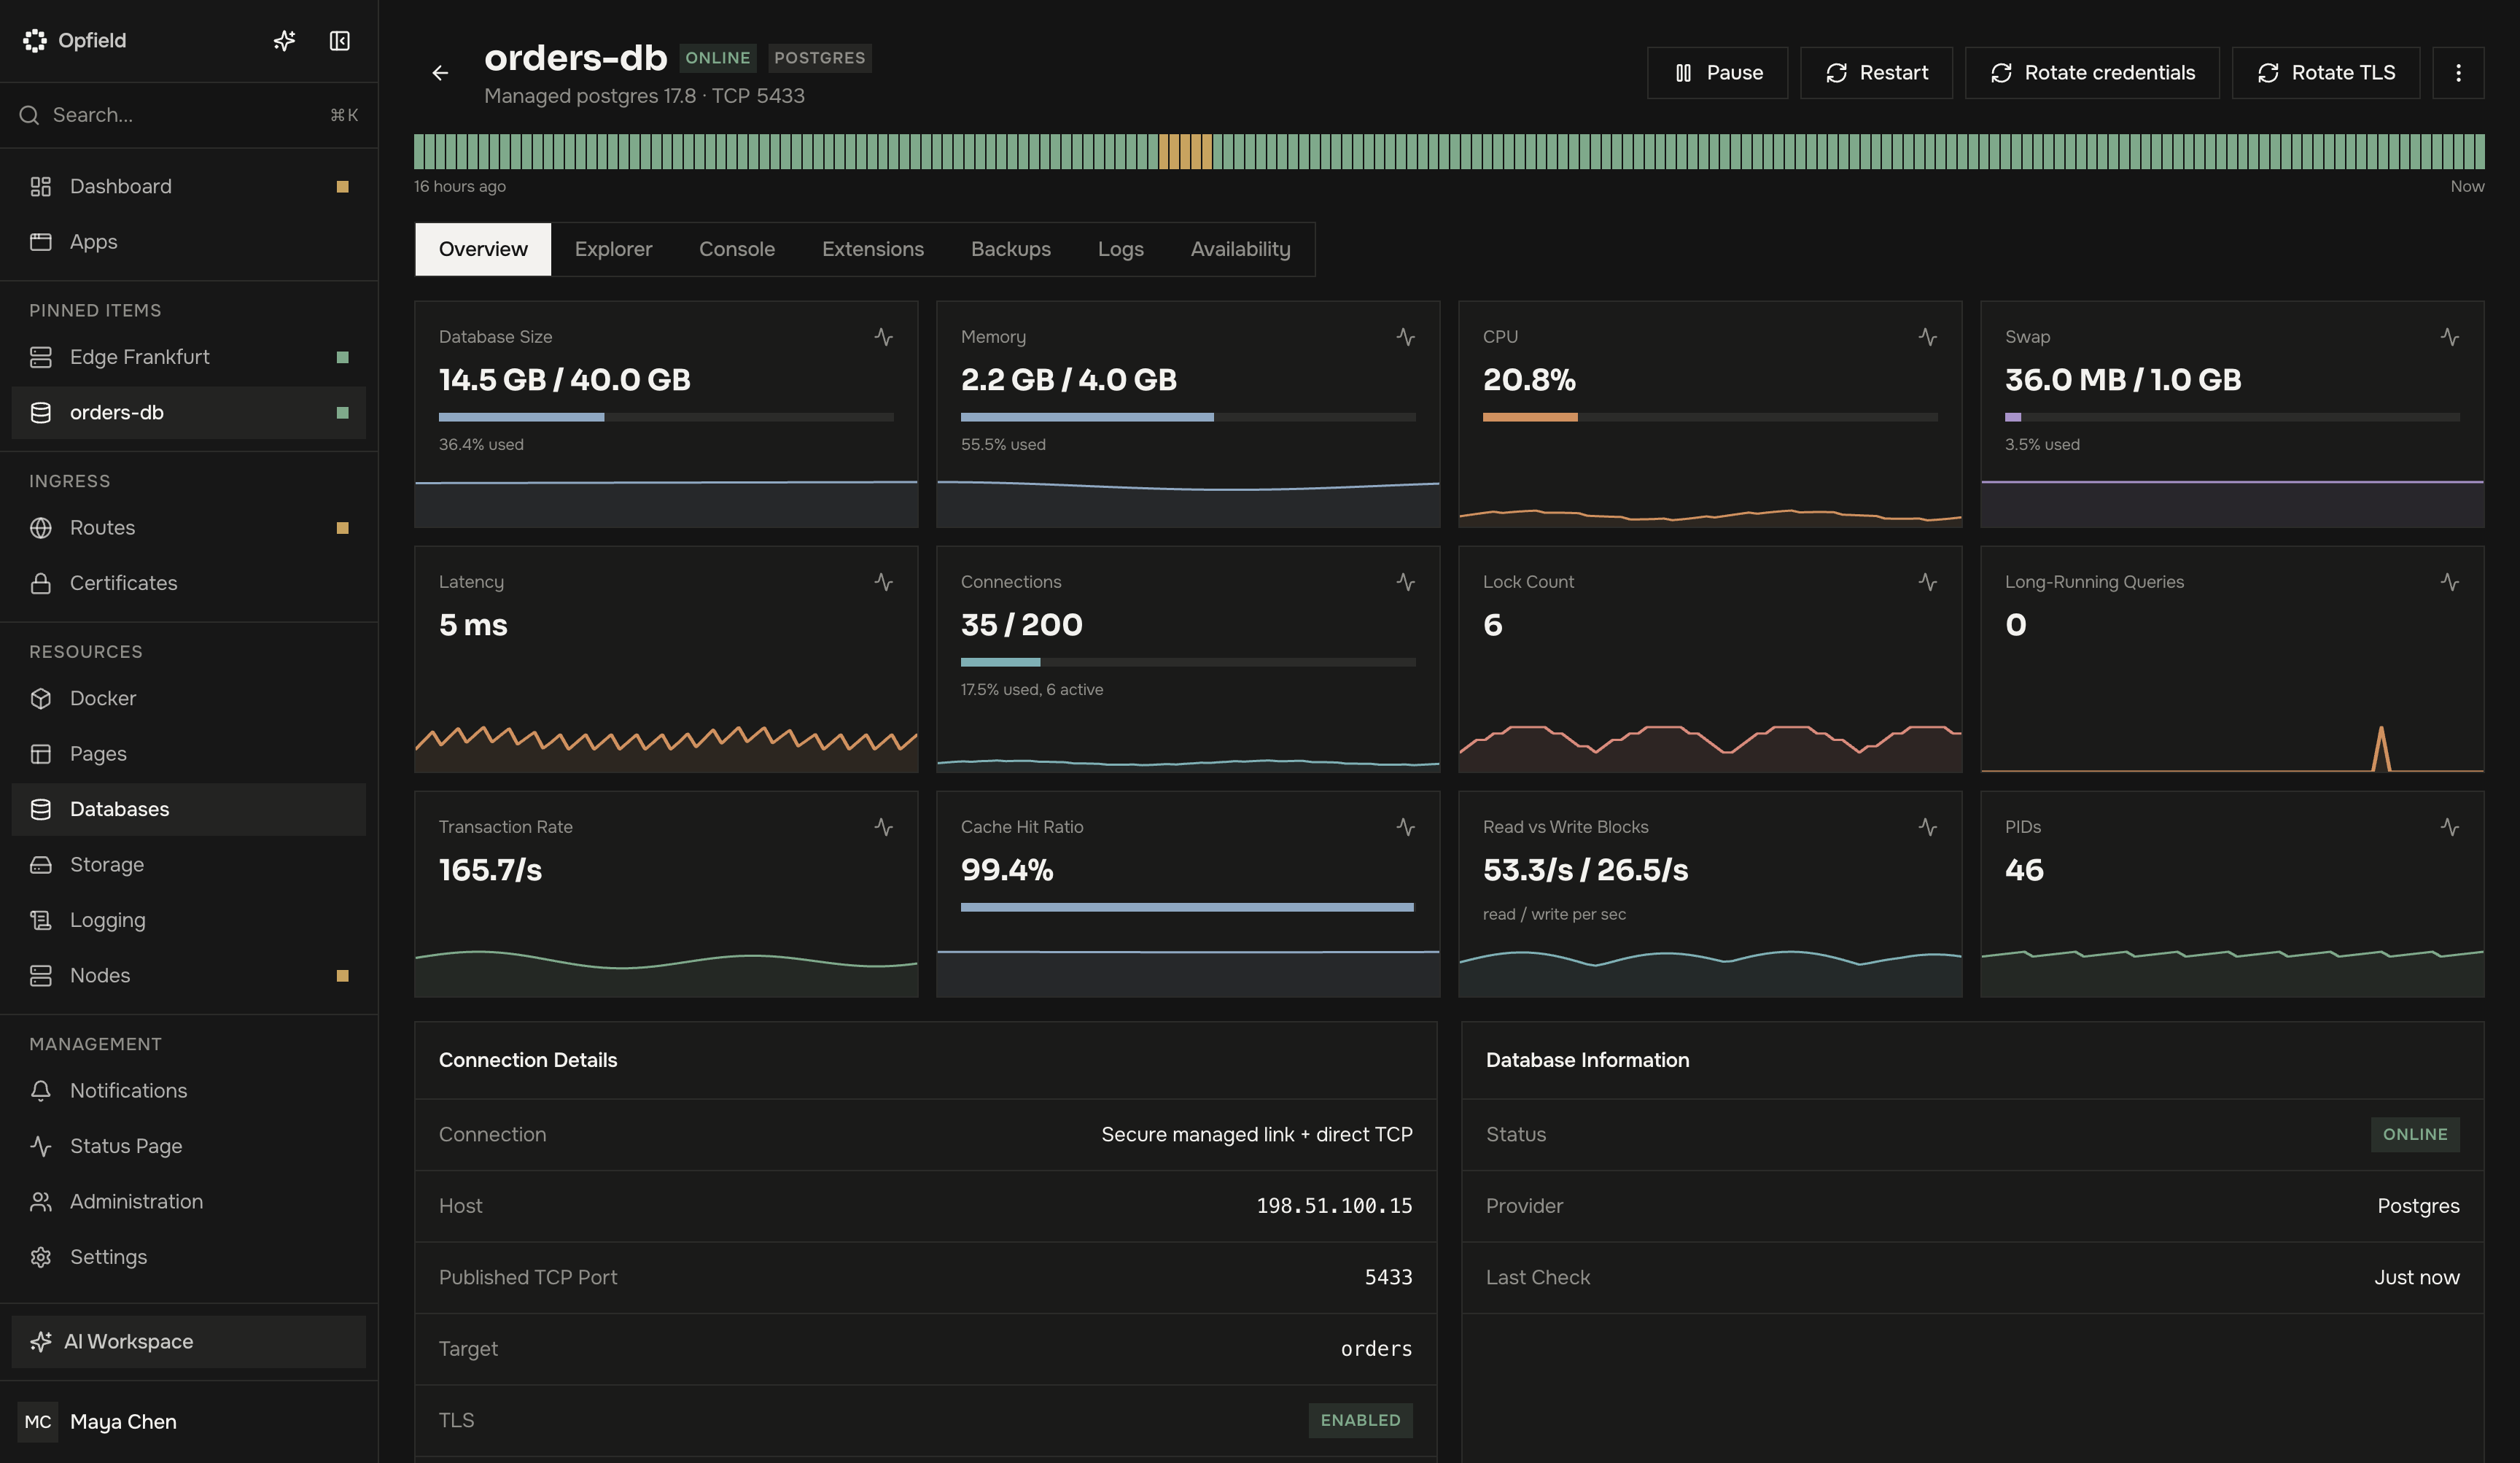
Opfield hält die Zugangsdaten des Engine-Besitzers intern und gibt sie nie an Benutzer zurück. Reveal credentials und die Rotation von Zugangsdaten gelten für einen separaten Benutzer für den direkten Zugriff, der existiert, solange die TCP-Veröffentlichung aktiviert ist; die Rotation betrifft direkte Clients, die ihn verwenden. Anwendungs-Bindings behalten ihre eigenen Engine-Identitäten und sind nicht betroffen.
Halten Sie bei einer geplanten Änderung einen Vorher-Zustand fest: Engine-Version, Speicherbelegung, Anzahl der Verbindungen, aktuelle Bindings, Veröffentlichungszustand, letztes erfolgreiches Backup und den Verantwortlichen der Operation. Vergleichen Sie nach der Änderung dieselben Signale und führen Sie eine echte Client-Abfrage aus. Schlägt die Operation fehl, bewahren Sie ihren Task und die Engine-Logs, bevor Sie es erneut versuchen; wiederholte blinde Versuche können nützliche Belege durch Folgefehler ersetzen.
Veröffentlichung und Außerbetriebnahme
Abschnitt betitelt „Veröffentlichung und Außerbetriebnahme“Die direkte TCP-Veröffentlichung ist optional und sollte als separater Vertrag mit externen Clients behandelt werden. Sie können sie nach der Bereitstellung aktivieren, deaktivieren oder ändern; Opfield erstellt den Datenbankcontainer neu und behält seine Daten, planen Sie also eine kurze Unterbrechung ein. Prüfen Sie nach dem Aktivieren den vorgesehenen Client, das Zertifikatsvertrauen, die Zugangsdaten und den Netzwerkpfad. Das Deaktivieren der Veröffentlichung entfernt diesen direkten Weg, löscht aber weder die Instanz noch private Workload-Bindings.
Das Löschen ist destruktiv. Entfernen oder migrieren Sie zuerst abhängige Bindings – Opfield lehnt das Löschen ab, solange Bindings existieren oder ein Backup bzw. eine Wiederherstellung der Datenbank läuft –, legen Sie fest, wie lange Backups aufbewahrt werden müssen, und bestätigen Sie, dass keine externen Clients mehr die direkte Veröffentlichung benötigen. Das Löschen der Datenbank deaktiviert und entfernt ihre Backup-Richtlinien; ihr Backup-Verlauf und die Artefakte im Speicher bleiben erhalten, und Backups of deleted databases auf der Seite Databases stellt sie in eine neue Datenbank wieder her. Opfield entfernt dann die verwaltete Instanz sowie ihren zugehörigen Identitäts- und Speicherzustand über ihren Lebenszyklus. Entfernen Sie Engine-Benutzer, interne Netzwerkobjekte oder Speicher nicht manuell, um das Löschen zu beschleunigen; lassen Sie die erfasste Operation abschließen, damit die Bereinigung konsistent bleibt.
Details für Betreiber: Speicher und direktes TLS
Abschnitt betitelt „Details für Betreiber: Speicher und direktes TLS“Der Storage Node muss dieselbe Speicher-Vorabprüfung bestehen, die die Laufzeit verwendet. Von Opfield verwaltete Datenbanken verwenden vorab zugewiesene ext4-Images fester Größe statt eines unbegrenzten Docker-Volumes. VM- und Bare-Metal-Hosts bieten die benötigten Loop- und Mount-Fähigkeiten normalerweise. Containerisierte Hosts erfordern ausdrückliche Unterstützung für Loop-Devices und Mounts; ein nicht unterstützter Host wird abgelehnt, statt stillschweigend auf eine schwächere Speicherisolation auszuweichen. Jede verwaltete Datenbank belegt ein Loop-Device, solange sie existiert; dimensionieren Sie den Pool von Loop-Devices eines LXC-Storage-Nodes daher für jede Instanz, jedes Mitglied eines Objektspeichers und jedes gleichzeitige Backup; siehe Voraussetzungen für Storage Nodes und Docker Nodes. Das Löschen einer Instanz gibt ihren Mount und ihr Loop-Device frei, bevor Opfield das Löschen meldet, und der Daemon repariert selbstständig Devices, die frühere Releases zurückgelassen haben.
Der Docker-Daemon, nicht die Neustartrichtlinie von Docker, startet die verwalteten Engines auf einem Storage Node. Nach einem Neustart mountet er zuerst das Disk-Image jeder Instanz und startet erst dann die Engine, sodass eine Engine nie in das leere Mount-Verzeichnis auf dem Root-Dateisystem schreibt. Eine Engine, die unerwartet stoppt, wird mit wachsender Verzögerung von bis zu einer Minute erneut gestartet; eine Instanz, die Sie gestoppt haben, bleibt gestoppt. Ein Storage Node startet auch dann, wenn einer seiner verwalteten Container fehlt; diese Datenbank wird als nicht laufend angezeigt.
Die direkte Veröffentlichung verwendet natives TLS. Opfield stellt das Serverzertifikat aus seiner separaten Database CA aus und hält den privaten Schlüssel in Speicher, der dem Daemon gehört, außerhalb des Datenbank-Images. PostgreSQL und Key-Value-Stores stellen einen TLS-Endpunkt bereit; ClickHouse stellt HTTPS und seinen nativen TLS-Endpunkt bereit. Clients müssen der angezeigten Database CA vertrauen und sollten der dokumentierten Richtlinie für Hostname oder Zertifikatsfingerabdruck folgen, statt die Prüfung zu deaktivieren.
Opfield verlängert das Serverzertifikat automatisch und prüft stündlich: wenn zwei Drittel seiner Laufzeit verstrichen sind, 30 Tage oder weniger verbleiben, eine konfigurierte Dienstadresse fehlt oder das Zertifikat von einer anderen CA stammt. Die Engine lädt das neue Zertifikat an Ort und Stelle neu – PostgreSQL, Key-Value-Stores und ClickHouse bedienen weiter –, und Opfield wechselt erst dann dazu, wenn die Instanz es ausliefert. Die Database CA ändert sich nicht, daher funktionieren Clients, die ihr vertrauen, weiter. Die Connection Details der Datenbank zeigen eine unauffällige Zeile TLS Certificate mit dem Ablaufdatum und entweder „renewed automatically“ oder „needs attention“. Ein Hinweis erscheint auf der Seite nur, wenn Handlungsbedarf besteht – die Verlängerung ist fehlgeschlagen, 7 Tage oder weniger verbleiben, das verlängerte Zertifikat ist noch nicht geladen, die Verlängerung wartet auf den Node-Daemon oder die CA begrenzt die Laufzeit –, mit dem Grund, dem Ablaufdatum und Rotate now, wo Sie rotieren dürfen. Das Dashboard zeigt außerdem eine Warnung mit jeder verwalteten Datenbank und jedem verwalteten Speicher, deren Zertifikat Handlungsbedarf hat und die Sie ansehen dürfen.
Rotate TLS certificate verlängert es sofort mit demselben Neuladen an Ort und Stelle. Ein Neustart wird nur verwendet, wenn Sie ihn erlauben, wenn 7 Tage oder weniger verbleiben oder wenn der Node-Daemon Zertifikate noch nicht neu laden kann. Solange die Verlängerung weiter fehlschlägt, löst Opfield das Benachrichtigungsereignis Managed Service Certificate Renewal Failed aus. API: GET /api/databases/managed/{id}/certificate und POST /api/databases/managed/{id}/rotate-certificate mit optionalem allowRestart; MCP und Assistent: manage_managed_database mit den Aktionen certificate_status und rotate_certificate.
Die eigenen Verbindungen von Opfield für Explorer, Konsole, Monitoring und Backups erreichen eine verwaltete Instanz über den gegenseitig authentifizierten Relay-Tunnel. Bei PostgreSQL mit TLS prüft Opfield zusätzlich das Serverzertifikat gegen die Opfield Database CA und die für diese Instanz ausgestellte Identität. Key-Value-Stores und ClickHouse verwenden innerhalb des Tunnels Klartext.
Anwendungs-Bindings erreichen die Instanz über denselben Tunnel. Bei PostgreSQL mit TLS funktioniert ein Binding-Client, der sich mit der einfachen Binding-URI verbindet, weiterhin: Der Daemon des Storage Nodes öffnet die TLS-Verbindung zu PostgreSQL und prüft das Zertifikat der Instanz, während ein Client, der selbst TLS anfordert, durchgängiges TLS behält. Siehe Anwendungs-Bindings für Datenbanken.
Entscheidungen zur Wiederherstellung
Abschnitt betitelt „Entscheidungen zur Wiederherstellung“- Ist der Node offline, stellen Sie den Node und die Daemon-Verbindung wieder her, bevor Sie die Datenbankdefinition ändern.
- Ist die Bereitstellung fehlgeschlagen, bevor die Engine bereit war, korrigieren Sie das gemeldete Speicher-, Kapazitäts- oder Versionsproblem und verwenden Sie die gezielte Wiederholungsaktion.
- Ist die Engine bereit, Clients schlagen aber fehl, trennen Sie TLS der direkten Veröffentlichung, Binding-Zustand, Zugangsdaten und Anwendungskonfiguration, bevor Sie etwas neu starten.
- Ist der Speicher beschädigt oder sind die Daten inkonsistent, beenden Sie Experimente mit dem Lebenszyklus und stellen Sie aus einem Backup auf Engine-Ebene in ein separates geprüftes Ziel wieder her.
Pausieren ist kein Backup, und ein Neustart ist kein Rollback. Opfield kann den Infrastrukturzustand abgleichen, aber weder eine Schemamigration der Anwendung rückgängig machen noch Daten rekonstruieren, die nie gesichert wurden.