

Vue d'ensemble de l'observabilité
Opfield remplace la pile de supervision auto-hébergée. Les métriques des nœuds et des conteneurs, les journaux des conteneurs et des Routes, les journaux applicatifs structurés, les règles d’alerte, les notifications et les pages de statut publiques sont intégrés. Il n’y a ni Prometheus, ni Grafana, ni Loki, ni Alertmanager à déployer, aucun tableau de bord à construire, et aucun Statuspage ou Uptime Kuma distinct à maintenir synchronisé : chaque métrique, chaque journal et chaque composant de statut est déjà rattaché à la ressource à laquelle il appartient.
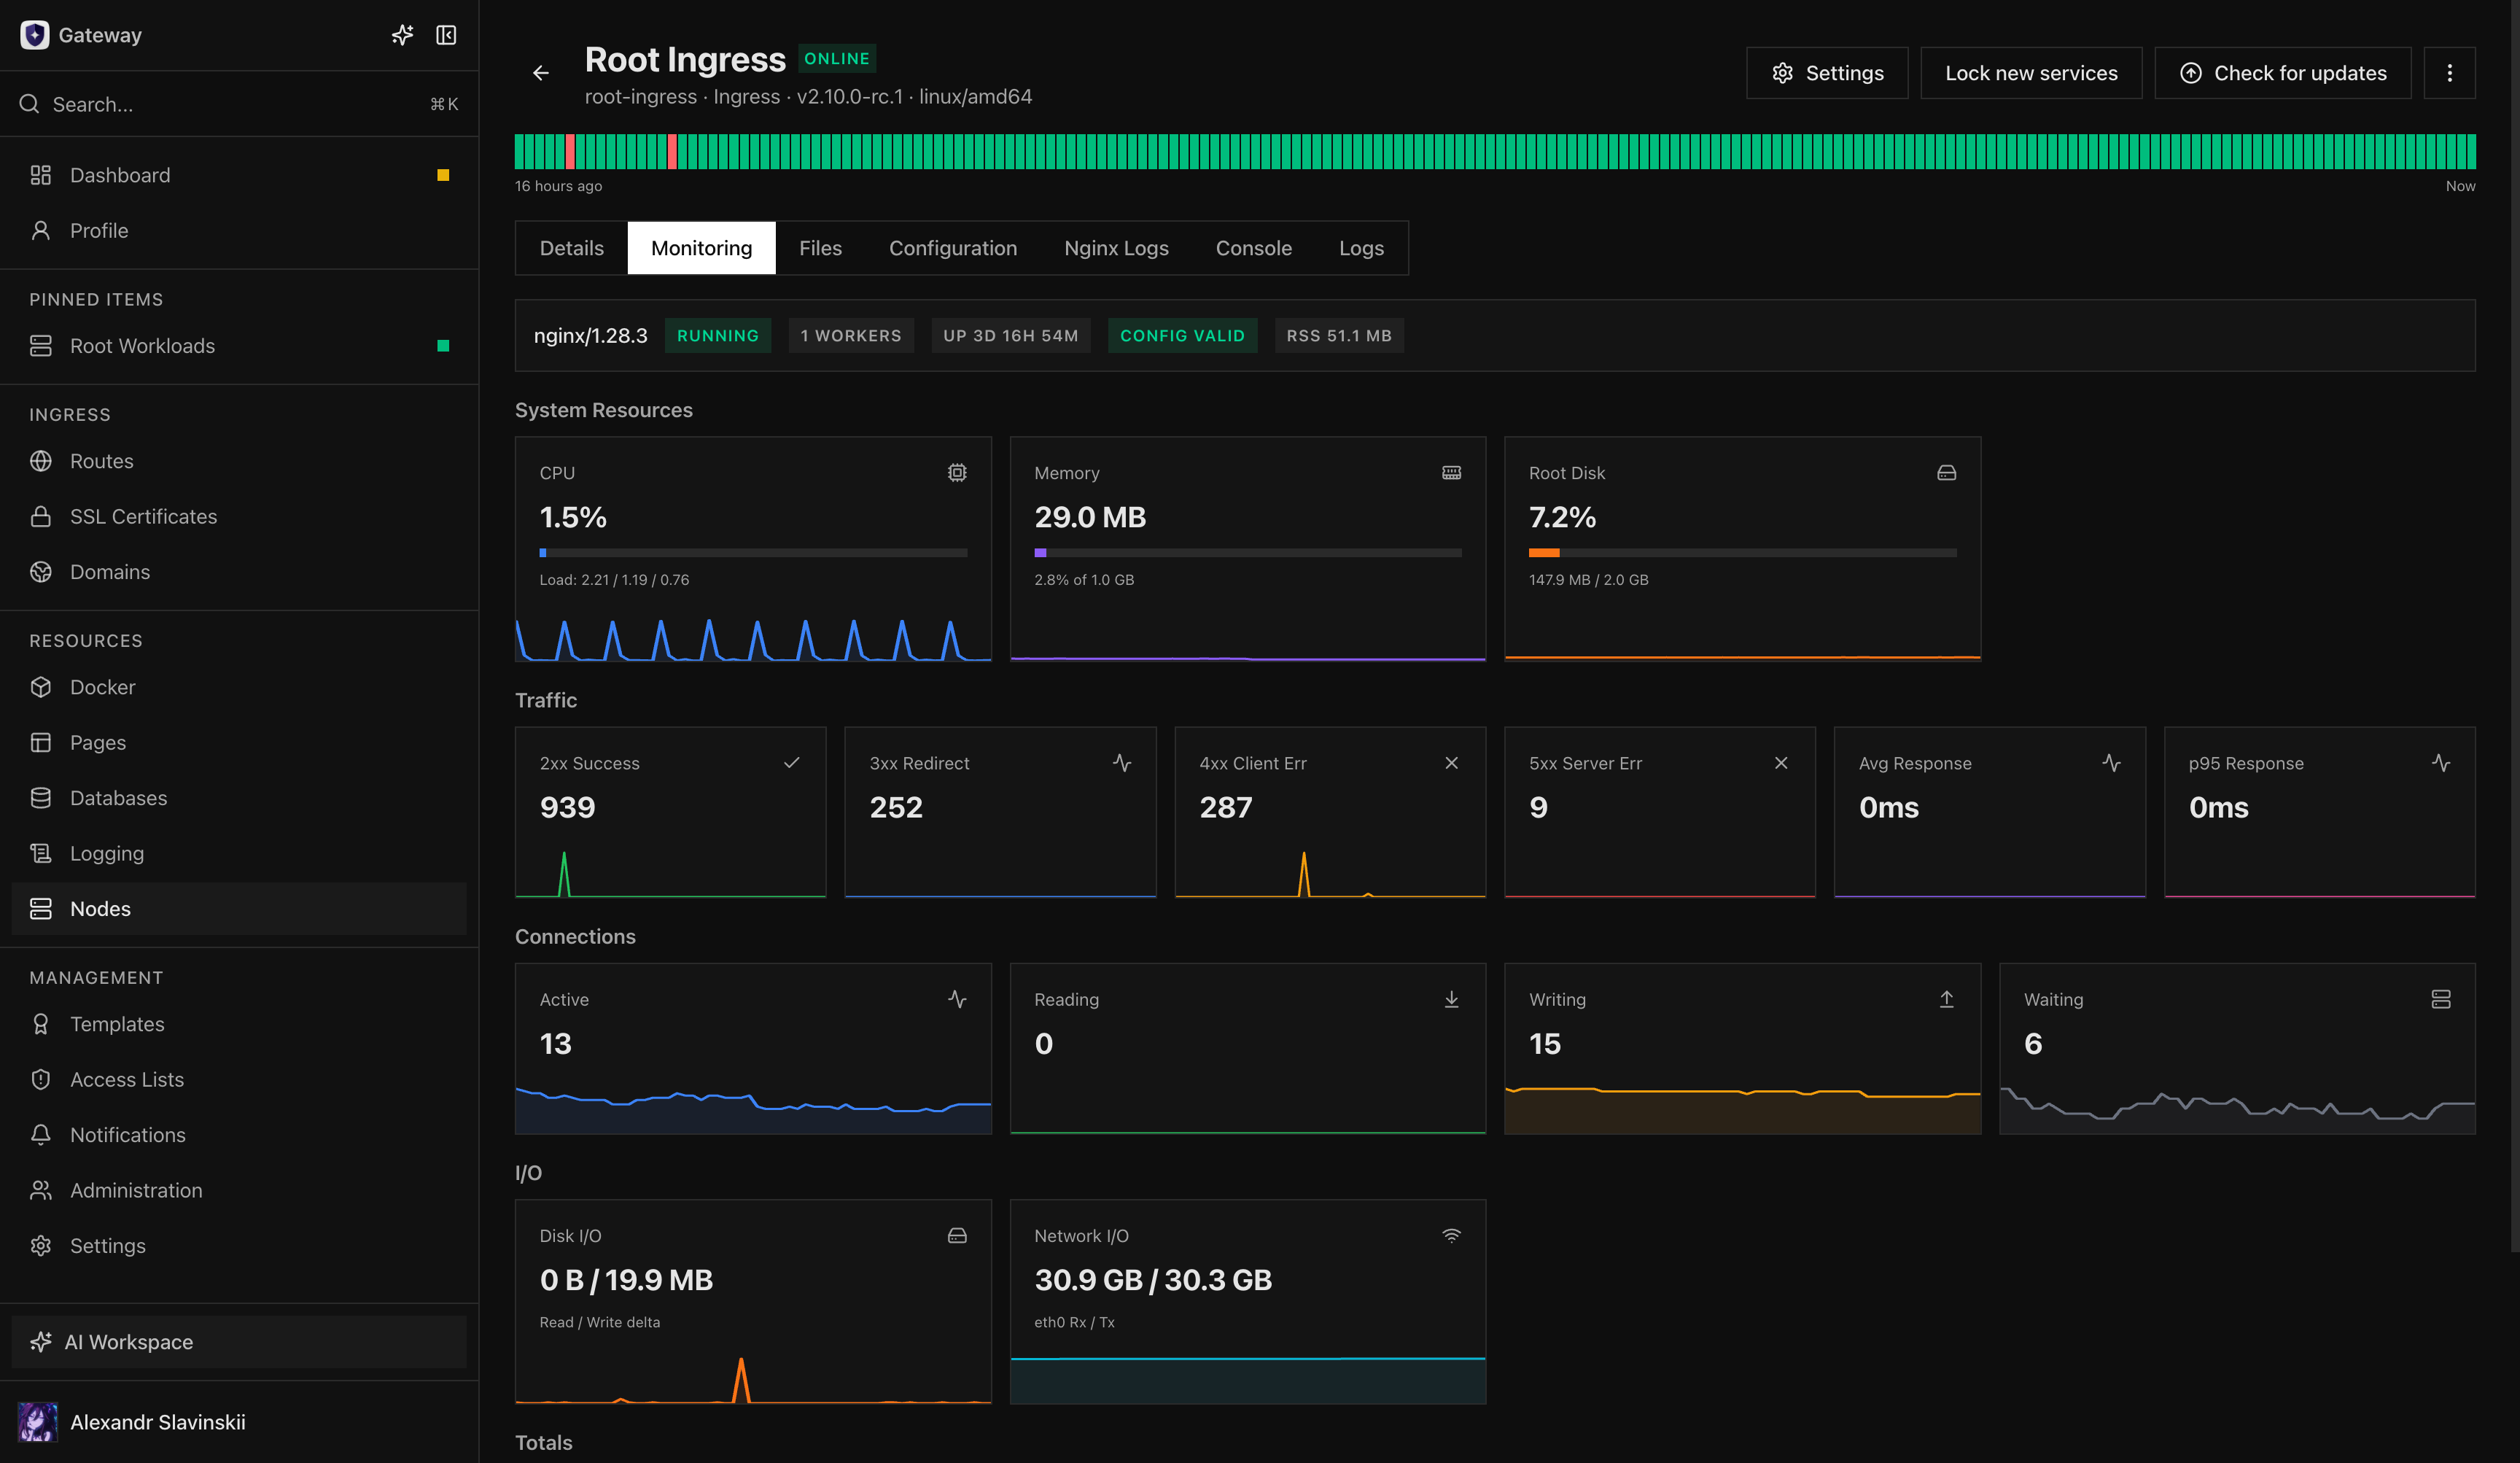
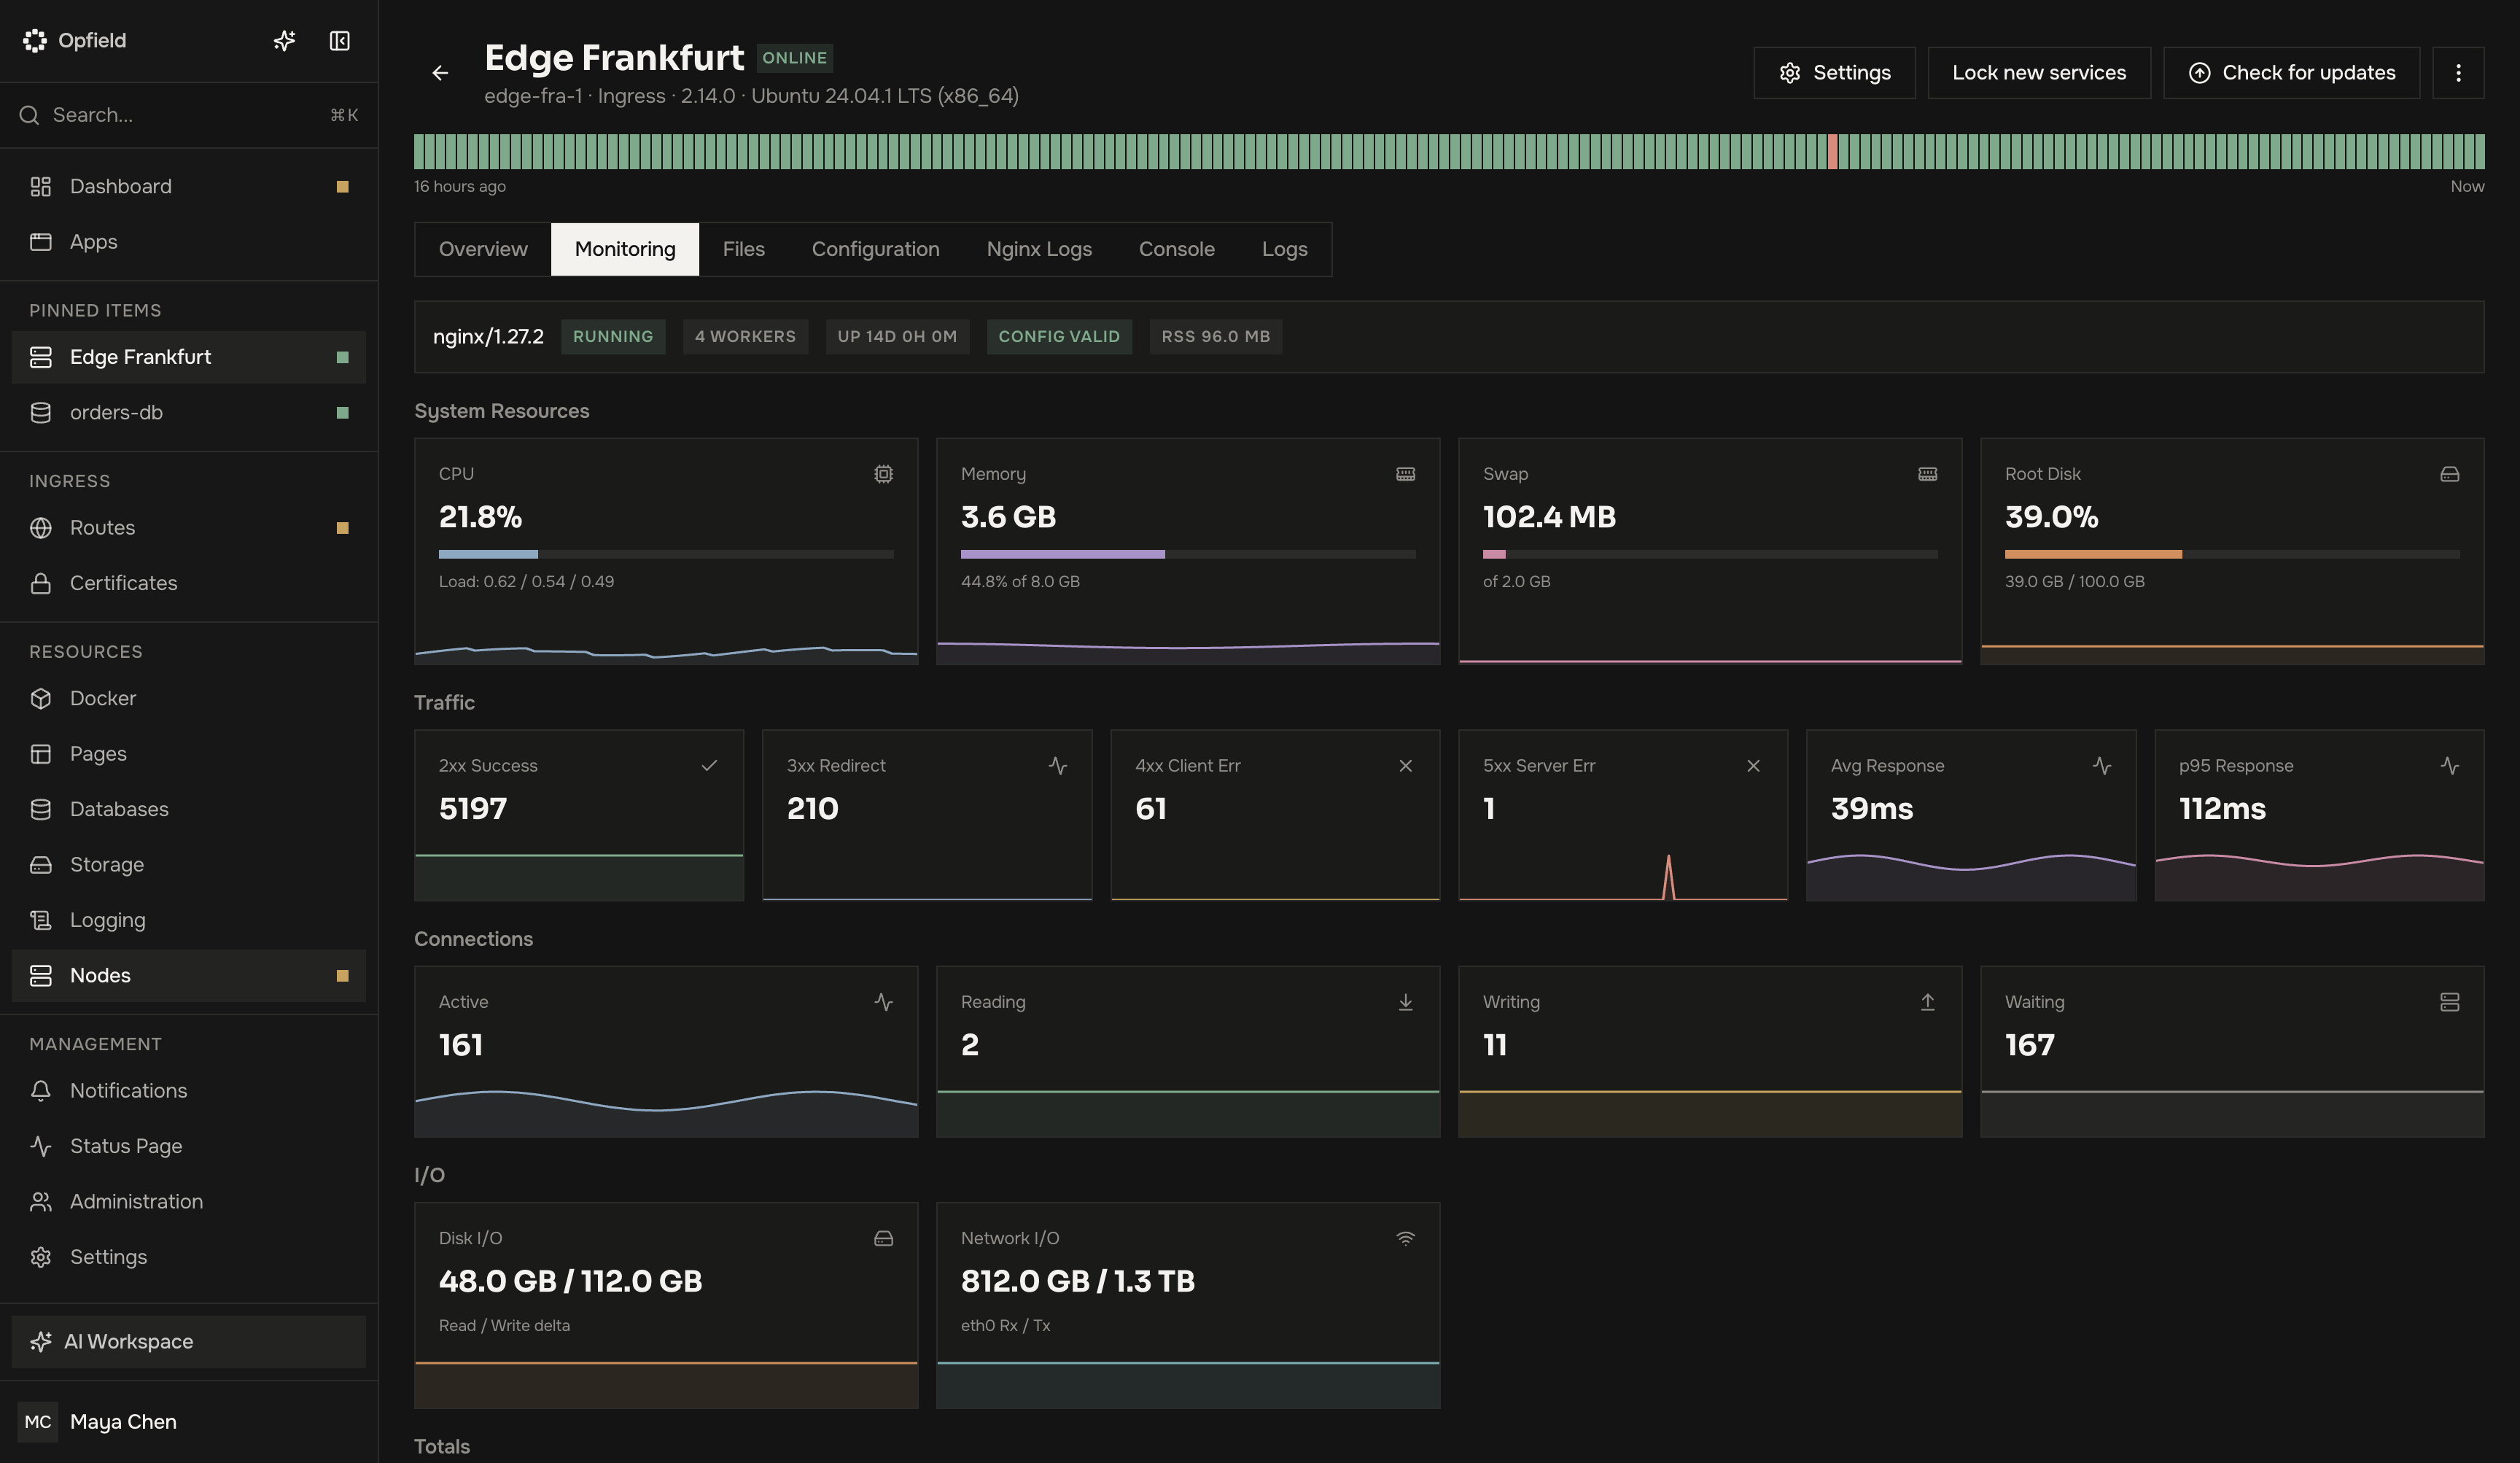
Opfield surveille l’état du plan de contrôle, la santé des nœuds, la santé des charges de travail, le trafic d’ingress, la santé des bases de données, l’activité des builds, la consommation d’inférence et les événements de sécurité. Chaque signal figure sur le tableau de bord et sur la page de la ressource qu’il décrit : nœuds, Routes, charges de travail, bases de données, builds, tâches, notifications, audit et pages de statut. Pendant un incident, les signaux répondent à trois questions : les clients sont-ils affectés, qui doit agir, et comment la reprise est-elle vérifiée ?
Opfield ne propose pas de traçage distribué. Lorsque votre équipe de sécurité analyse les événements d’audit dans son propre SIEM, Opfield les y exporte ; voir Journalisation structurée et SIEM.
Visez un petit ensemble de signaux fiables, avec des responsables nommés, une rétention utile et un chemin testé de la détection à la reprise visible par les clients. C’est vous qui définissez ce que signifie le succès pour l’activité : objectifs de niveau de service (SLO), escalade et vérification des dépendances externes.
Utilisez la santé des ressources pour l’état immédiat, les métriques pour les tendances, les journaux pour le diagnostic, les tâches durables pour l’avancement des opérations, les notifications pour l’action, les pages de statut pour la communication avec les clients, l’audit pour l’attribution et le SIEM pour l’analyse de sécurité externe.
Concevez les alertes autour d’un impact client durable et de transitions d’état significatives. Évitez de dupliquer chaque événement de bas niveau dans un canal de notification.
Définir la responsabilité et le succès
Section intitulée « Définir la responsabilité et le succès »Pour chaque service important, nommez le responsable métier, le responsable technique, la destination d’astreinte et le responsable de la communication avec les clients. Définissez ce que signifie disponible du point de vue de l’utilisateur, et pas seulement d’après un badge de processus interne. Une Route peut être saine alors que son application ou sa base de données renvoie des réponses inutilisables ; un nœud peut être en ligne alors qu’un parcours client est cassé.
Utilisez un SLO — un objectif de fiabilité mesurable dans le temps — pour décider quelles conditions méritent des alertes et lesquelles relèvent uniquement des tableaux de bord ou des rapports. Indiquez dans l’alerte elle-même la vérification de reprise attendue. Le succès est atteint lorsque le parcours client fonctionne à nouveau, que le signal est revenu à la normale et que toute mesure d’atténuation temporaire a été retirée.
Types de signaux
Section intitulée « Types de signaux »| Signal | Meilleur usage | Erreur courante |
|---|---|---|
| Santé | Disponibilité actuelle du service | Considérer un badge au vert comme la preuve d’une disponibilité de bout en bout |
| Métriques | Capacité et tendances | Déclencher une alerte sur chaque pic de courte durée |
| Journaux | Diagnostic détaillé | Envoyer des secrets ou des charges utiles non bornées |
| Tâches | Avancement durable des opérations | Supposer qu’une tâche acceptée est déjà terminée |
| Événements | Transitions d’état des ressources | Utiliser le volume d’événements comme métrique de santé |
| Audit | Qui a modifié quoi | Remplacer les journaux d’exploitation par les enregistrements d’audit |
| Notifications | Action des opérateurs | Transmettre chaque événement informatif |
| Pages de statut | Communication avec les clients | Publier une topologie privée ou des erreurs brutes |
Construire une vue d’exploitation
Section intitulée « Construire une vue d’exploitation »- Partez des Routes visibles par les clients et des services métier.
- Associez chaque service à son ingress, sa charge de travail, sa base de données, son stockage et ses dépendances externes.
- Définissez le signal de santé et le SLO qui représentent l’impact client.
- Ajoutez des alertes de capacité des ressources avec des fenêtres de durée soutenue.
- Dirigez les événements urgents vers une destination de notification dotée d’un responsable.
- Ne créez un composant de statut public que pour les informations que les clients doivent voir.
- Testez la panne et la reprise, et pas seulement l’envoi des notifications.
Processus de diagnostic
Section intitulée « Processus de diagnostic »Utilisez le tableau de bord pour le tri, puis ouvrez la ressource concernée. Comparez la santé en direct avec les métriques récentes, les tâches, les événements et les journaux. Corrélez par identifiant de ressource stable, identifiant d’opération, identifiant de requête et horodatage. Si l’état affiché repose sur un instantané en cache, rétablissez la connexion du nœud propriétaire avant de modifier la ressource.
Pour la supervision des bases de données, la collecte démarre en arrière-plan après l’amorçage d’Opfield et lorsqu’une base de données managée devient prête ; l’ouverture de la page de la base n’est pas un prérequis. Une première visite peut attendre brièvement l’historique ou le premier instantané réel, mais elle ne doit pas fabriquer un état sain à partir de données absentes.
Pendant un incident, commencez par le parcours client concerné et progressez vers l’intérieur : DNS et TLS publics, Route et Ingress, charge de travail, dépendances privées, stockage et services externes. Utilisez les tâches pour distinguer une opération acceptée d’une opération terminée. Utilisez l’audit pour comprendre les changements de configuration, et non comme substitut aux journaux d’exécution.
Diagnostics d’Opfield
Section intitulée « Diagnostics d’Opfield »Opfield rend aussi compte de sa propre santé. L’assistant d’IA et les clients MCP la lisent avec manage_opfield_diagnostics :
snapshot: le CPU, la mémoire, la charge et le disque du volume de données de l’hôte ; la mémoire, le CPU et le retard de la boucle d’événements du processus serveur ; la joignabilité, la latence, le pool de connexions, la taille et les requêtes longues de PostgreSQL et Redis ; les conteneurs de la pile (app,postgres,redis,relay,registry) avec leur état, leur santé, leurs redémarrages, leur CPU et leur mémoire ; les tâches d’arrière-plan en échec ; et la latence et les erreurs 5xx de l’API ;history: des échantillons d’une minute conservés pendant 48 heures ;requestsetjobs: décomptes, p95 et erreurs 5xx par route, ainsi que la dernière exécution et les erreurs de chaque tâche d’arrière-plan ;logs: les journaux des conteneurs app, PostgreSQL, Redis, Relay et registry, et de la dernière exécution de mise à jour d’Opfield.
La lecture de l’état nécessite diagnostics:view ; la lecture des journaux nécessite diagnostics:logs, qui l’inclut. Les groupes d’administration intégrés détiennent les deux ; les groupes personnalisés doivent se les voir accorder. Les valeurs de CPU couvrent les CPU qu’Opfield peut réellement utiliser, kernelCpuCount indiquant le nombre vu par le noyau. La mémoire correspond à la limite cgroup du conteneur lorsqu’elle est définie (memoryScope: "cgroup") et sinon à la vue du noyau ("kernel"), comme à l’intérieur d’un invité LXC, dont la limite propre n’est pas visible depuis le conteneur de l’application.
Les règles d’alerte de la catégorie Opfield surveillent les mêmes signaux : CPU, mémoire et disque de l’hôte, mémoire du serveur, retard de la boucle d’événements, taux de 5xx et latence p95 de l’API, latence et attentes du pool de PostgreSQL, et latence de Redis. Elles se déclenchent aussi lorsque PostgreSQL ou Redis est indisponible, lorsqu’un conteneur de la pile est arrêté ou défaillant, et lorsqu’une tâche d’arrière-plan échoue de manière répétée. Une alerte de panne de PostgreSQL est envoyée directement aux webhooks de ses règles pendant que PostgreSQL est en panne et enregistrée à son retour. /health vérifie PostgreSQL via une connexion qui lui est propre ; un pool de connexions occupé n’est donc pas interprété comme une panne.
Vérifier l’observabilité elle-même
Section intitulée « Vérifier l’observabilité elle-même »Surveillez le chemin de supervision : fraîcheur des nœuds, santé de ClickHouse, envoi de la file des notifications, publication des pages de statut, âge de la file d’envoi SIEM et rétention du stockage. Un système d’observabilité qui cesse silencieusement de collecter doit générer un avertissement distinct au niveau de la plateforme.
Conservez la télémétrie assez longtemps pour reconstituer les incidents, mais appliquez des budgets explicites de rétention et de taille. N’utilisez pas les journaux comme une archive de données non maîtrisée.
Détails pour l’opérateur : signaux périmés et contradictoires
Section intitulée « Détails pour l’opérateur : signaux périmés et contradictoires »Chaque décision de santé a un horodatage et un propriétaire. Si un nœud se déconnecte, son dernier instantané peut devenir périmé ; rétablissez le nœud propriétaire avant de modifier des ressources sur la base d’informations anciennes. Si l’avertissement de la barre latérale et une page de détail divergent, comparez leur source, leur horodatage et leur règle d’agrégation plutôt que de supposer que l’une des deux couleurs fait autorité.
Traitez les données manquantes comme inconnues, et non comme saines. Vérifiez que la collecte progresse, que l’échantillon le plus récent avance, que ClickHouse est disponible là où des journaux structurés sont attendus, que les files de notifications se vident et que les mises à jour de statut public sont publiées. Après la réparation, exécutez la vérification de bout en bout d’origine et documentez tout angle mort qui a retardé la détection.