

Bases de données managées
Les bases de données managées fournissent des instances PostgreSQL, clé-valeur et ClickHouse contrôlées par Opfield sur des nœuds Storage. Les nouveaux stockages clé-valeur managés exécutent Valkey et fonctionnent avec les clients Redis ; voir Stockages clé-valeur. Opfield détient le cycle de vie de la ressource et sa configuration souhaitée ; le nœud Storage détient le moteur en cours d’exécution et son environnement d’exécution local. Un nœud hors ligne n’efface donc pas la configuration enregistrée de l’instance, et la reprise commence par la santé du nœud, et non par des modifications manuelles du moteur.
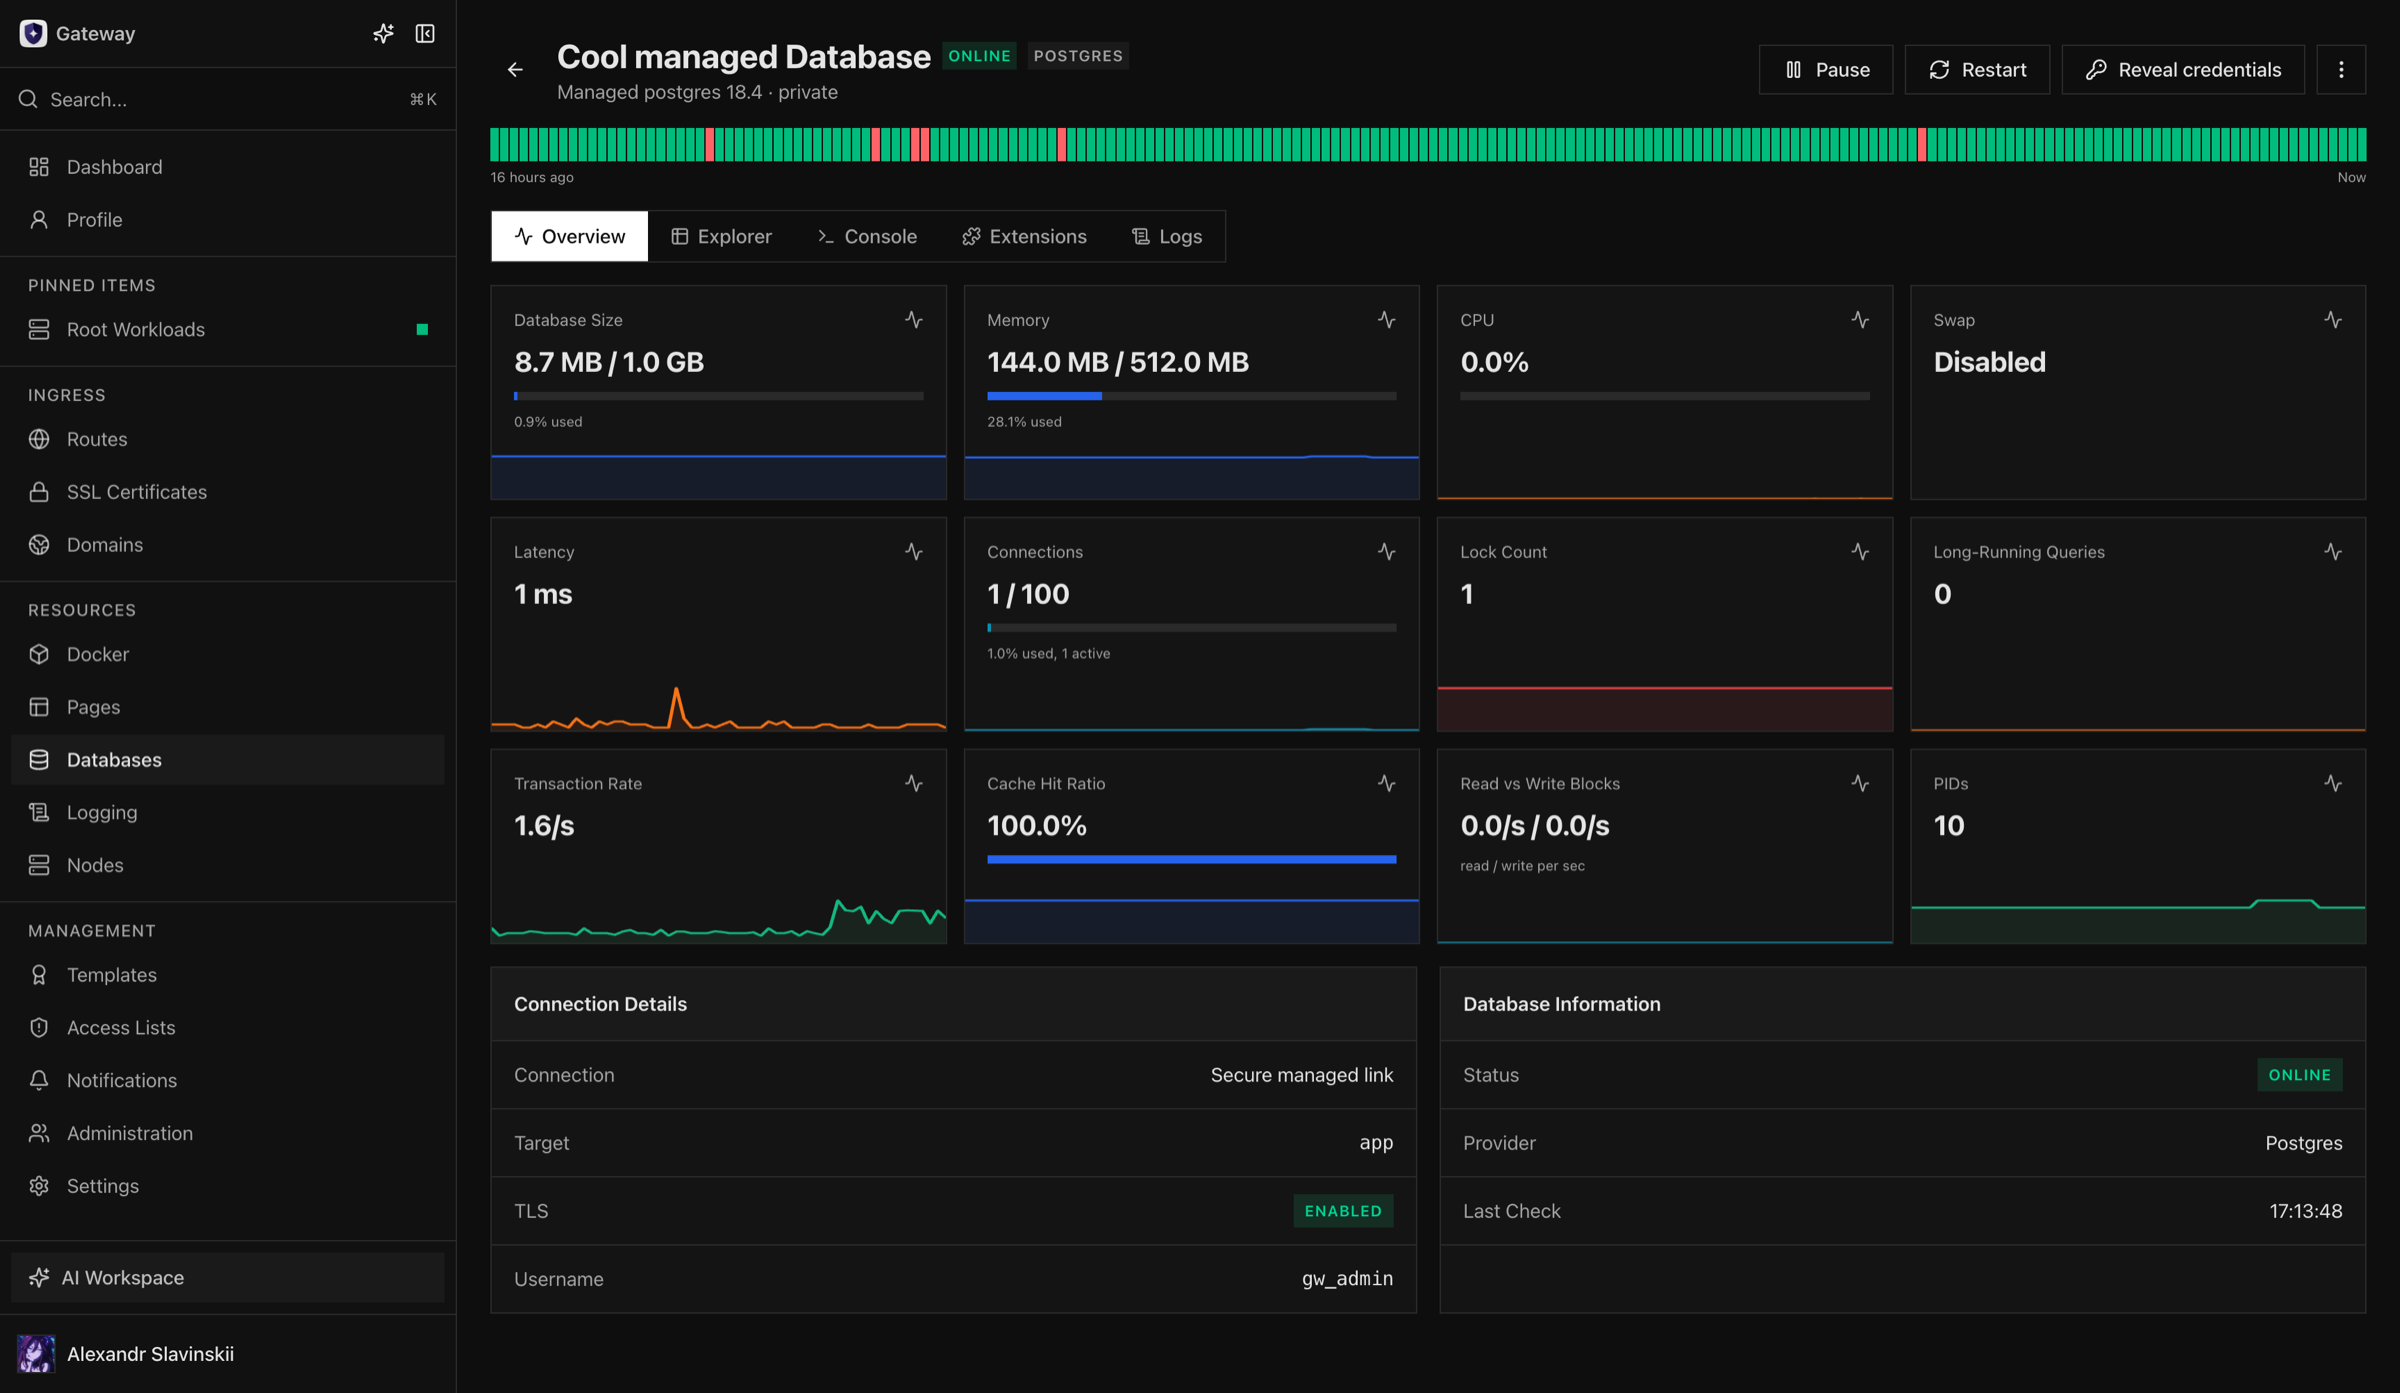
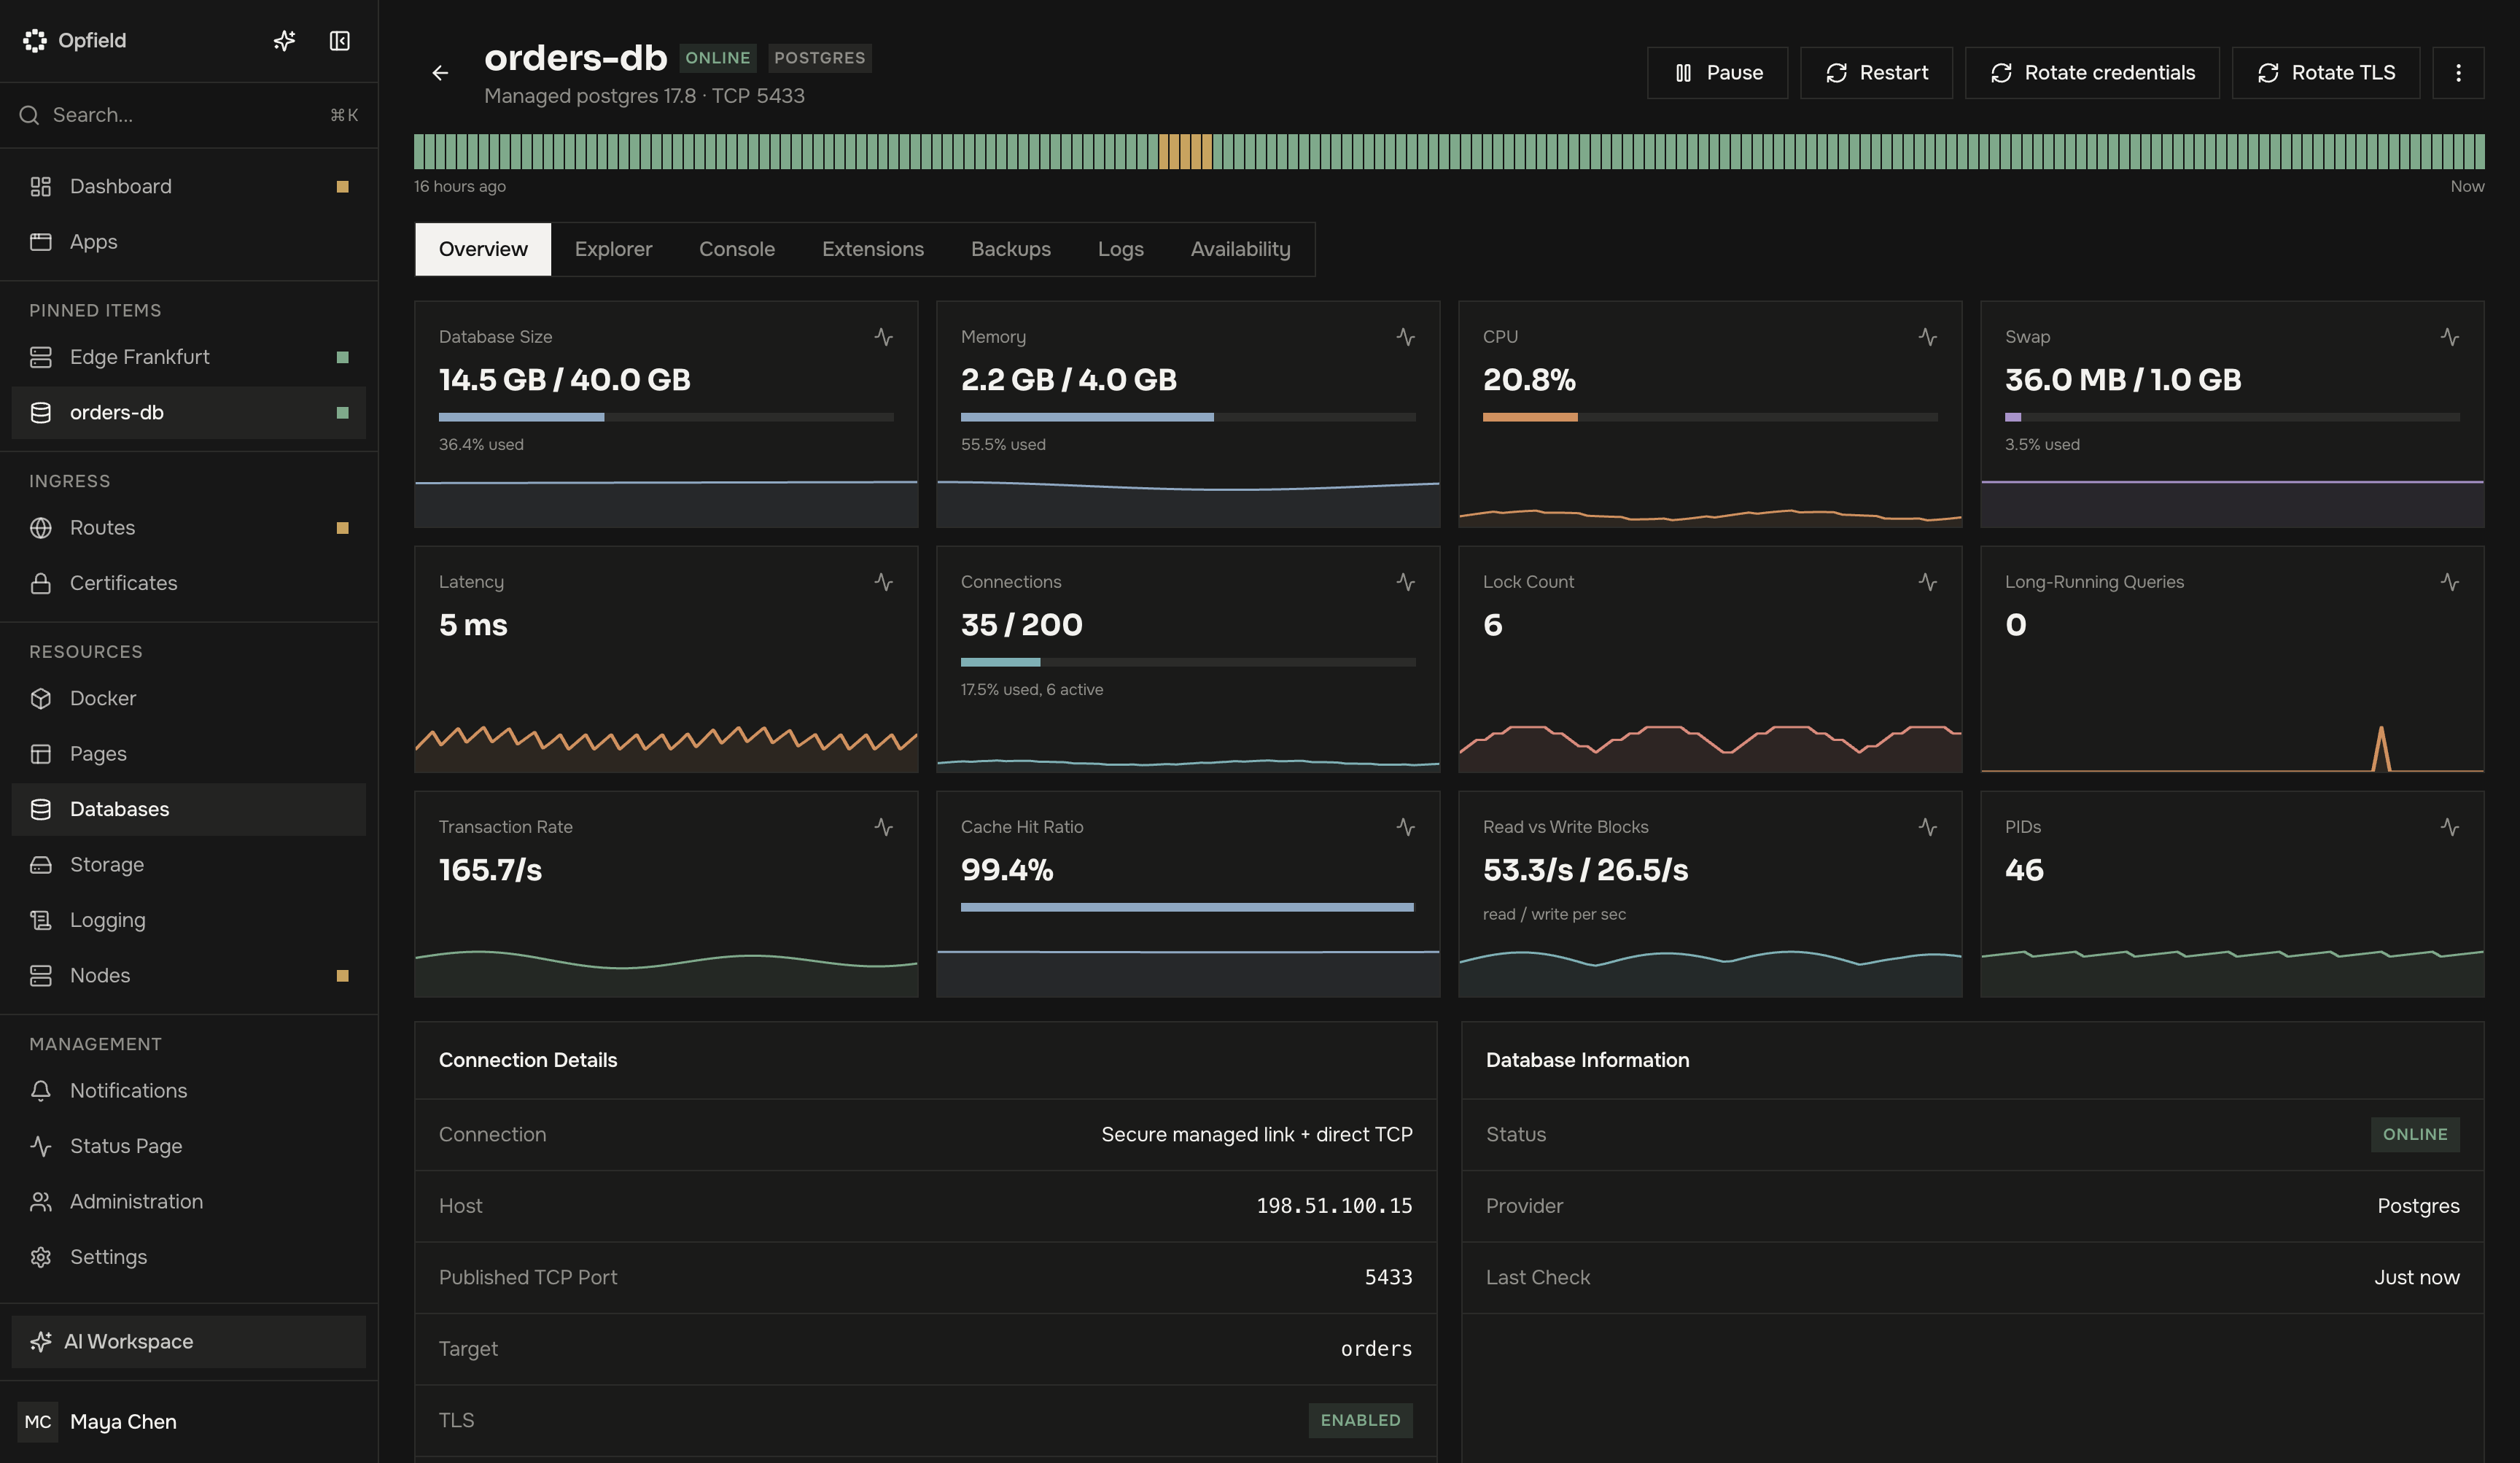
Une instance managée se crée dans un formulaire, s’exécute sur le nœud Storage que vous choisissez et atteint les charges de travail via des liaisons privées. Une base managée s’exécute sur un seul serveur, sauf si vous la rendez disponible sur plusieurs. Opfield la provisionne, la configure, la supervise et la sauvegarde selon un calendrier ; la politique de sauvegarde et les tests de restauration, le choix de la version du moteur et la planification de la capacité restent de votre ressort. Pour une comparaison avec les connexions externes, voir Bases de données managées et externes en un coup d’œil. La création d’une base managée nécessite Personal ou supérieur.
Frontière des capacités
Section intitulée « Frontière des capacités »| Capacité | Ce que fournit Opfield | Ce qui reste de votre ressort |
|---|---|---|
| Provisionnement | Une instance PostgreSQL, clé-valeur ou ClickHouse bornée sur un nœud Storage, ou sur 2 à 5 avec Availability | Capacité du nœud, placement, durabilité du stockage et version du moteur approuvée |
| Configuration et cycle de vie | Configuration souhaitée, mise en pause et reprise, redémarrage, nouvelle tentative d’un provisionnement en échec, redimensionnement du CPU, de la mémoire, du swap et du stockage (le stockage ne peut qu’augmenter), nombre maximal de connexions PostgreSQL, paramètres des moteurs clé-valeur et ClickHouse, extensions PostgreSQL, publication, journaux, supervision et processus de retrait | Fenêtres de changement, compatibilité applicative, vérification indépendante et décision de retour arrière |
| Accès applicatif | Liaisons privées gérées et publication TLS directe facultative | Comportement des clients, usage à privilèges minimaux, confiance dans les certificats et politique de rotation des identifiants |
| Sauvegardes | Sauvegardes de bases de données natives planifiées vers une connexion de stockage, et restauration dans une nouvelle base managée, à partir de Personal | Politique de sauvegarde, destination hors de l’hôte, conservation, chiffrement de la destination et tests de restauration réguliers |
| Restauration à un instant donné | Non fournie automatiquement | Architecture de sauvegarde continue WAL, AOF ou propre au moteur, et procédure de reprise testée |
| Réplication et basculement automatique | En Business et Enterprise : un primaire et 1 à 4 copies sur d’autres nœuds Storage, basculement automatique avec témoins ou paire manuelle ; voir Bases de données et stockage sur plusieurs serveurs | Choix de la durabilité au regard de la fenêtre de perte de données indiquée, hôtes des témoins et comportement de reconnexion de l’application |
| Changements de version du moteur | Via l’API et MCP, passage à une version plus récente du catalogue pour le même moteur : PostgreSQL au sein de sa version majeure, Valkey et ClickHouse vers la version suivante du catalogue ; le conteneur est recréé sur la nouvelle image et conserve ses données. Un stockage clé-valeur créé avant 2.12 peut passer une fois de Redis à Valkey | Choix de la version et, pour une autre version majeure de PostgreSQL, restauration d’une sauvegarde dans une nouvelle instance |
| Reprise après sinistre | Opfield conserve la définition de la ressource ; les données applicatives perdues ne reviennent que depuis une sauvegarde | Site de reprise indépendant, copies des données, clés, reprise DNS/réseau, RPO/RTO déclarés |
Les bases de données managées n’offrent pas de restauration à un instant donné, et le basculement automatique nécessite Business ou Enterprise. Une base qui a besoin d’une restauration à un instant donné peut s’exécuter sur une plateforme qui la fournit et être enregistrée dans Opfield comme connexion externe, avec les mêmes vérifications de santé, Explorer, Console et sauvegardes. Une ressource Opfield saine ne prouve pas à elle seule que les données sont disponibles.
Avant le provisionnement
Section intitulée « Avant le provisionnement »Vous avez besoin de la permission de créer la base et d’utiliser le nœud Storage sélectionné. Confirmez le moteur et sa version prise en charge, la disponibilité du nœud, les besoins en stockage et en mémoire, le plan de sauvegarde et la nécessité réelle d’un accès client externe. Choisissez la capacité avec prudence et laissez de la marge pour la surcharge du moteur, le travail temporaire et les opérations de reprise.
Laissez la publication directe désactivée, sauf si un client externe en a un besoin documenté. La connectivité applicative privée doit utiliser des liaisons. Activer la publication directe est une modification intentionnelle de l’exposition de l’instance et n’ouvre pas automatiquement de pare-feu sur l’hôte.
Consultez le catalogue des versions sélectionnées dans l’interface avant le provisionnement. Les versions prises en charge constituent un contrat d’exploitation : n’épinglez pas une version de correctif amont arbitraire et ne conservez pas un moteur obsolète simplement parce que son conteneur démarre encore. Pour des données de production, documentez le chemin de mise à niveau et la compatibilité de restauration avant de choisir une version. Chaque version du catalogue est épinglée sur une empreinte d’image. Le nœud Storage la récupère en priorité depuis le miroir d’Opfield sur GitHub Container Registry (ghcr.io) et se rabat sur Docker Hub, en vérifiant la même empreinte dans les deux cas.
Provisionner et vérifier
Section intitulée « Provisionner et vérifier »- Choisissez le moteur, la version prise en charge, le nœud Storage, la taille du stockage et le profil de mémoire.
- Examinez la posture réseau privée par défaut et tout paramètre de publication directe.
- Créez l’instance et suivez l’opération de provisionnement jusqu’au bout.
- Attendez que l’instance affiche Ready avant de créer une liaison applicative ou de vous appuyer sur l’Explorer, la Console ou les métriques.
- Vérifiez la santé du moteur, les journaux récents, le signalement du stockage et un chemin de connexion autorisé.
La première vérification doit inclure une écriture adaptée au moteur et une relecture via la même identité que celle qu’utilisera le vrai client. Pour PostgreSQL, vérifiez la base et le schéma prévus ; pour un stockage clé-valeur, vérifiez l’accès attendu aux clés et la politique de persistance ; pour ClickHouse, vérifiez le chemin de la base et de la table cibles ainsi que le comportement des requêtes et du stockage. Supprimez les données synthétiques après le test.
Les échecs de provisionnement résultent couramment de nœuds indisponibles, de limites de capacité, de la préparation du stockage, de paramètres de moteur non pris en charge ou du démarrage du moteur. Lisez le résultat de l’opération avant de réessayer. Des redémarrages ou des tentatives de recréation répétés peuvent masquer l’échec d’origine et ne remplacent pas la correction des prérequis de stockage ou de configuration.
Modifier une instance existante
Section intitulée « Modifier une instance existante »La mise en pause et la reprise contrôlent le calcul tout en conservant les données de la base. Attendez-vous à ce que les actions normales de santé, de métriques, d’Explorer et de Console soient indisponibles pendant la pause. Un redémarrage crée une brève interruption de service et doit être annoncé aux applications dépendantes lorsqu’elles ne peuvent pas se reconnecter automatiquement.
Ne redimensionnez que dans les limites du moteur et du stockage. Le stockage peut augmenter mais pas diminuer, et le redimensionnement ainsi que les changements de paramètres sont indisponibles pendant la pause. Une modification ne peut pas être enregistrée tant qu’une modification précédente est encore en cours d’application. L’historique de supervision survit à une période pendant laquelle la base ou son nœud était hors ligne. Effectuez une sauvegarde avant un changement de capacité important, suivez l’opération de redimensionnement, puis vérifiez le signalement du stockage et le comportement de l’application.
Pour PostgreSQL, Maximum connections dans Database Settings définit max_connections : 100 par défaut, de 20 à 10 000 (postgresConfig.maxConnections dans l’API et dans update de manage_managed_database). L’enregistrement d’une nouvelle valeur recrée le conteneur. La même valeur constitue la capacité des liens de la base ; voir Capacité des liens et pools de connexions.
Opfield garde l’identifiant du propriétaire dans le moteur en interne et ne le renvoie jamais aux utilisateurs. Reveal credentials et la rotation des identifiants s’appliquent à un utilisateur d’accès direct distinct qui existe tant que la publication TCP est activée ; la rotation affecte les clients directs qui l’utilisent. Les liaisons applicatives conservent leurs propres identités dans le moteur et ne sont pas affectées.
Pour un changement planifié, consignez un état initial : version du moteur, utilisation du stockage, nombre de connexions, liaisons actuelles, état de publication, dernière sauvegarde réussie et responsable de l’opération. Après le changement, comparez les mêmes signaux et exécutez une vraie requête client. Si l’opération échoue, conservez sa tâche et les journaux du moteur avant de réessayer ; des tentatives répétées à l’aveugle peuvent remplacer des éléments utiles par des échecs secondaires.
Publication et retrait
Section intitulée « Publication et retrait »La publication TCP directe est facultative et doit être traitée comme un contrat distinct avec des clients externes. Vous pouvez l’activer, la désactiver ou la modifier après le provisionnement ; Opfield recrée le conteneur de la base en conservant ses données, prévoyez donc une courte interruption. Vérifiez le client prévu, la confiance dans les certificats, les identifiants et le chemin réseau après l’avoir activée. Désactiver la publication supprime ce chemin direct, mais ne supprime ni l’instance ni les liaisons privées des charges de travail.
La suppression est destructive. Retirez ou migrez d’abord les liaisons dépendantes — Opfield refuse la suppression tant que des liaisons existent ou qu’une sauvegarde ou restauration de la base est en cours —, décidez de la durée de conservation des sauvegardes et confirmez qu’aucun client externe n’a encore besoin de la publication directe. La suppression de la base désactive et retire ses politiques de sauvegarde ; son historique de sauvegardes et les artefacts dans le stockage sont conservés, et Backups of deleted databases sur la page Databases permet de les restaurer dans une nouvelle base. Opfield retire ensuite l’instance managée ainsi que l’identité et l’état de stockage associés via son cycle de vie. Ne supprimez pas manuellement les utilisateurs du moteur, les objets réseau internes ou le stockage pour tenter d’accélérer la suppression ; laissez l’opération enregistrée se terminer afin que le nettoyage reste cohérent.
Détails pour l’opérateur : stockage et TLS direct
Section intitulée « Détails pour l’opérateur : stockage et TLS direct »Le nœud Storage doit réussir les mêmes contrôles préalables de stockage que ceux utilisés par l’exécution. Les bases de données gérées par Opfield utilisent des images ext4 préallouées de taille fixe plutôt qu’un volume Docker non borné. Les VM et les hôtes physiques fournissent normalement les capacités loop et de montage requises. Les hôtes conteneurisés nécessitent une prise en charge explicite des périphériques loop et des montages ; un hôte non pris en charge est refusé au lieu de se rabattre silencieusement sur une isolation de stockage plus faible. Chaque base managée occupe un périphérique loop tant qu’elle existe ; dimensionnez donc l’ensemble de périphériques loop d’un nœud Storage LXC pour chaque instance, chaque membre de stockage objet et chaque sauvegarde simultanée ; voir Prérequis des nœuds Storage et Docker. La suppression d’une instance libère son montage et son périphérique loop avant qu’Opfield ne signale la suppression, et le démon répare de lui-même les périphériques laissés par des versions antérieures.
C’est le démon Docker, et non la politique de redémarrage de Docker, qui démarre les moteurs managés sur un nœud Storage. Après un redémarrage de l’hôte, il monte d’abord l’image disque de chaque instance et ne démarre le moteur qu’ensuite ; un moteur n’écrit donc jamais dans le répertoire de montage vide du système de fichiers racine. Un moteur qui s’arrête de manière inattendue est redémarré avec un délai croissant jusqu’à une minute ; une instance que vous avez arrêtée reste arrêtée. Un nœud Storage démarre même lorsque l’un de ses conteneurs managés est manquant ; cette base apparaît comme arrêtée.
La publication directe utilise TLS natif. Opfield émet le certificat serveur depuis sa Database CA distincte et conserve la clé privée dans un stockage appartenant au démon, hors de l’image de la base. PostgreSQL et les stockages clé-valeur exposent un point de terminaison TLS ; ClickHouse expose HTTPS et son point de terminaison TLS natif. Les clients doivent faire confiance à la Database CA affichée et suivre la politique documentée de nom d’hôte ou d’empreinte de certificat plutôt que de désactiver la vérification.
Opfield renouvelle automatiquement le certificat serveur, en vérifiant toutes les heures : lorsque les deux tiers de sa durée de vie sont écoulés, qu’il reste 30 jours ou moins, qu’une adresse de service configurée manque ou que le certificat provient d’une autre CA. Le moteur recharge le nouveau certificat sur place — PostgreSQL, les stockages clé-valeur et ClickHouse continuent de servir — et Opfield ne bascule dessus qu’une fois que l’instance le sert. La Database CA ne change pas ; les clients qui lui font confiance continuent donc de fonctionner. Les Connection Details de la base affichent une ligne discrète TLS Certificate avec la date d’expiration et soit « renewed automatically », soit « needs attention ». Un avis n’apparaît sur la page que lorsqu’une intervention est nécessaire — renouvellement en échec, 7 jours ou moins restants, certificat renouvelé pas encore chargé, renouvellement en attente du démon du nœud, ou durée de vie limitée par la CA —, avec la raison, la date d’expiration et Rotate now lorsque vous êtes autorisé à effectuer la rotation. Le tableau de bord affiche aussi un avertissement listant chaque base de données et chaque stockage managés dont le certificat nécessite une intervention et que vous pouvez consulter.
Rotate TLS certificate le renouvelle immédiatement avec le même rechargement sur place. Un redémarrage n’est utilisé que si vous l’autorisez, s’il reste 7 jours ou moins, ou si le démon du nœud ne peut pas encore recharger les certificats. Tant que le renouvellement continue d’échouer, Opfield déclenche l’événement de notification Managed Service Certificate Renewal Failed. API : GET /api/databases/managed/{id}/certificate et POST /api/databases/managed/{id}/rotate-certificate avec allowRestart facultatif ; MCP et assistant : actions certificate_status et rotate_certificate de manage_managed_database.
Les connexions propres à Opfield pour l’Explorer, la Console, la supervision et les sauvegardes atteignent une instance managée via le tunnel Relay à authentification mutuelle. Pour PostgreSQL avec TLS, Opfield vérifie en plus le certificat serveur par rapport à l’Opfield Database CA et à l’identité émise pour cette instance. Les stockages clé-valeur et ClickHouse utilisent du texte en clair à l’intérieur du tunnel.
Les liaisons applicatives atteignent l’instance via le même tunnel. Pour PostgreSQL avec TLS, un client de liaison qui se connecte avec l’URI de liaison simple fonctionne toujours : le démon du nœud Storage ouvre la connexion TLS vers PostgreSQL et vérifie le certificat de l’instance, tandis qu’un client qui demande lui-même TLS conserve un TLS de bout en bout. Voir Liaisons applicatives aux bases de données.
Décisions de reprise
Section intitulée « Décisions de reprise »- Si le nœud est hors ligne, rétablissez le nœud et la connexion du démon avant de modifier la définition de la base.
- Si le provisionnement a échoué avant que le moteur ne soit prêt, corrigez le problème de stockage, de capacité ou de version signalé et utilisez l’action de nouvelle tentative ciblée.
- Si le moteur est prêt mais que les clients échouent, distinguez le TLS de la publication directe, l’état de la liaison, les identifiants et la configuration de l’application avant de redémarrer quoi que ce soit.
- Si le stockage est endommagé ou les données incohérentes, cessez toute expérimentation sur le cycle de vie et restaurez sur une cible distincte vérifiée à partir d’une sauvegarde au niveau du moteur.
La pause n’est pas une sauvegarde et le redémarrage n’est pas un retour arrière. Opfield peut réconcilier l’état de l’infrastructure, mais il ne peut pas annuler une migration de schéma applicative ni reconstituer des données qui n’ont jamais été sauvegardées.