

Publier une application de bout en bout
Ce parcours mène un artefact applicatif approuvé jusqu’à un point de terminaison HTTPS public : la charge de travail, sa vérification de santé, le domaine et le certificat TLS, la Route et le test de recette.
Le résultat visé est un service sain du point de vue de l’utilisateur, joignable via le domaine prévu, observable dans Opfield, protégé par la politique d’accès attendue et réversible sans reconstruire le plan de contrôle.
S’il s’agit de votre premier déploiement, préparez un nœud Docker, examinez les modèles de ressources Docker et gardez Publier votre première Route ouvert pour l’étape d’ingress.
Choisir le modèle de charge de travail
Section intitulée « Choisir le modèle de charge de travail »Choisissez la ressource qui correspond à la propriété du cycle de vie :
- Utilisez un Container pour un service autonome simple dont le remplacement est une opération de recréation explicite.
- Utilisez un Deployment lorsqu’un déploiement blue/green contrôlé par des vérifications de santé et un slot de retour arrière conservé sont nécessaires.
- Utilisez un projet Compose lorsque plusieurs services, réseaux et volumes forment une seule application et doivent suivre un même cycle de vie de révisions immuables.
Ne modélisez pas une application multiservice comme des conteneurs autonomes sans lien simplement pour rendre chaque enfant directement modifiable. Cela supprime la propriété du projet et rend le retour arrière, la dérive et les changements dépendants plus difficiles à maîtriser.
Avant de poursuivre, approuvez l’empreinte d’image ou le commit Git exacts, les limites de ressources prévues, les sources des secrets, la politique de sauvegarde des volumes, les dépendances aux bases de données, le point de terminaison de santé, le nom d’hôte public et la cible de retour arrière.
1. Préparer la capacité et la propriété
Section intitulée « 1. Préparer la capacité et la propriété »Enrôlez ou sélectionnez un nœud Docker en ligne pour la charge de travail et un nœud Ingress en ligne pour le trafic public. Vérifiez que chaque nœud a le bon rôle, une version compatible, les capacités requises et une marge suffisante. Un nœud au vert ne prouve pas qu’une image volumineuse tient sur le disque ni qu’un port demandé est disponible.
Attribuez les scopes avant la publication. Le développeur peut avoir besoin de la visibilité sur les sources et les builds, l’opérateur de plateforme d’un accès au cycle de vie des charges de travail, et l’opérateur ingress d’un accès aux Routes. Évitez d’accorder le rôle d’administrateur système simplement parce que le processus couvre plusieurs types de ressources.
Pour les charges de travail avec état, vérifiez où résident les données persistantes et comment elles sont restaurées. Un retour arrière de Deployment modifie l’exécution applicative ; il n’annule pas les écritures en base de données et ne répare pas un volume modifié par la nouvelle version.
2. Créer ou connecter la charge de travail
Section intitulée « 2. Créer ou connecter la charge de travail »Créez le Container, le Deployment ou le projet Compose choisi. Configurez l’empreinte d’image immuable ou la source Git approuvée, la commande, l’environnement, les secrets protégés, le comportement de redémarrage, les limites de ressources et les volumes managés.
Préférez les volumes managés ou un stockage externe explicitement approuvé. Les montages de répertoires de l’hôte lient la charge de travail à un seul hôte et ne sont pas portables via les processus normaux d’archive ou de migration. Ne placez pas de secrets dans des valeurs d’environnement ordinaires, la source Compose, les arguments de build ou les labels d’image.
Si l’application utilise une base de données, créez la liaison avant la validation finale de la publication afin de tester la même configuration d’exécution. Une liaison managée donne à la charge de travail une identité de base de données dédiée et peut nécessiter une recréation ou un déploiement normal pour appliquer son environnement et son réseau privé.
3. Prouver la santé de l’application avant le trafic public
Section intitulée « 3. Prouver la santé de l’application avant le trafic public »Définissez la santé en termes pertinents pour l’utilisateur. La présence d’un processus ou un port TCP qui accepte les connexions sont des preuves plus faibles qu’un point de terminaison HTTP confirmant que l’application et ses dépendances critiques sont prêtes.
Pour un Deployment, configurez le chemin de santé, la plage de codes de réponse attendue, la correspondance facultative du corps, le délai d’expiration, l’intervalle et le seuil de lenteur. Gardez le slot précédent disponible jusqu’à ce que le nouveau slot ait passé la vérification de santé et la vérification externe. Pour un Container ou un service Compose, examinez l’état d’exécution réel, les journaux et la réponse de l’application avant de créer la Route publique.
N’envoyez pas le trafic de production vers une application qui migre encore ses données, sauf si la stratégie de migration le prévoit explicitement. Les migrations longues ou destructives nécessitent leur propre plan de retour arrière et de compatibilité.
4. Préparer le domaine et TLS
Section intitulée « 4. Préparer le domaine et TLS »Créez ou sélectionnez le domaine, placez-le sur le nœud Ingress prévu et assurez-vous que le DNS faisant autorité pointe vers son adresse de service publique. Émettez, importez ou sélectionnez un certificat qui couvre le nom d’hôte exact ou un wildcard approprié.
La séparation des responsabilités aide ici : changer le DNS ne doit pas obliger à modifier la charge de travail, et revenir en arrière sur la charge de travail ne doit pas obliger à remplacer le certificat. Vérifiez qui renouvelle les certificats téléversés et qui reçoit les notifications d’expiration.
5. Créer la Route
Section intitulée « 5. Créer la Route »Créez une Route pour le domaine et sélectionnez la charge de travail gérée comme upstream. Pour un Container Docker, un service Compose ou un Deployment, Opfield peut établir un Secure Link afin que l’ingress atteigne la charge de travail via Relay, sans port applicatif publié sur l’hôte pour ce seul chemin.
Choisissez le port applicatif et le schéma d’upstream que la charge de travail sert réellement. Activez le TLS public et Force HTTPS selon les besoins. N’activez les WebSockets, le comportement de préfixe, les changements de mise en mémoire tampon, les délais personnalisés ou les modèles personnalisés que si le contrat de l’application l’exige ; chaque exception augmente la surface à tester.
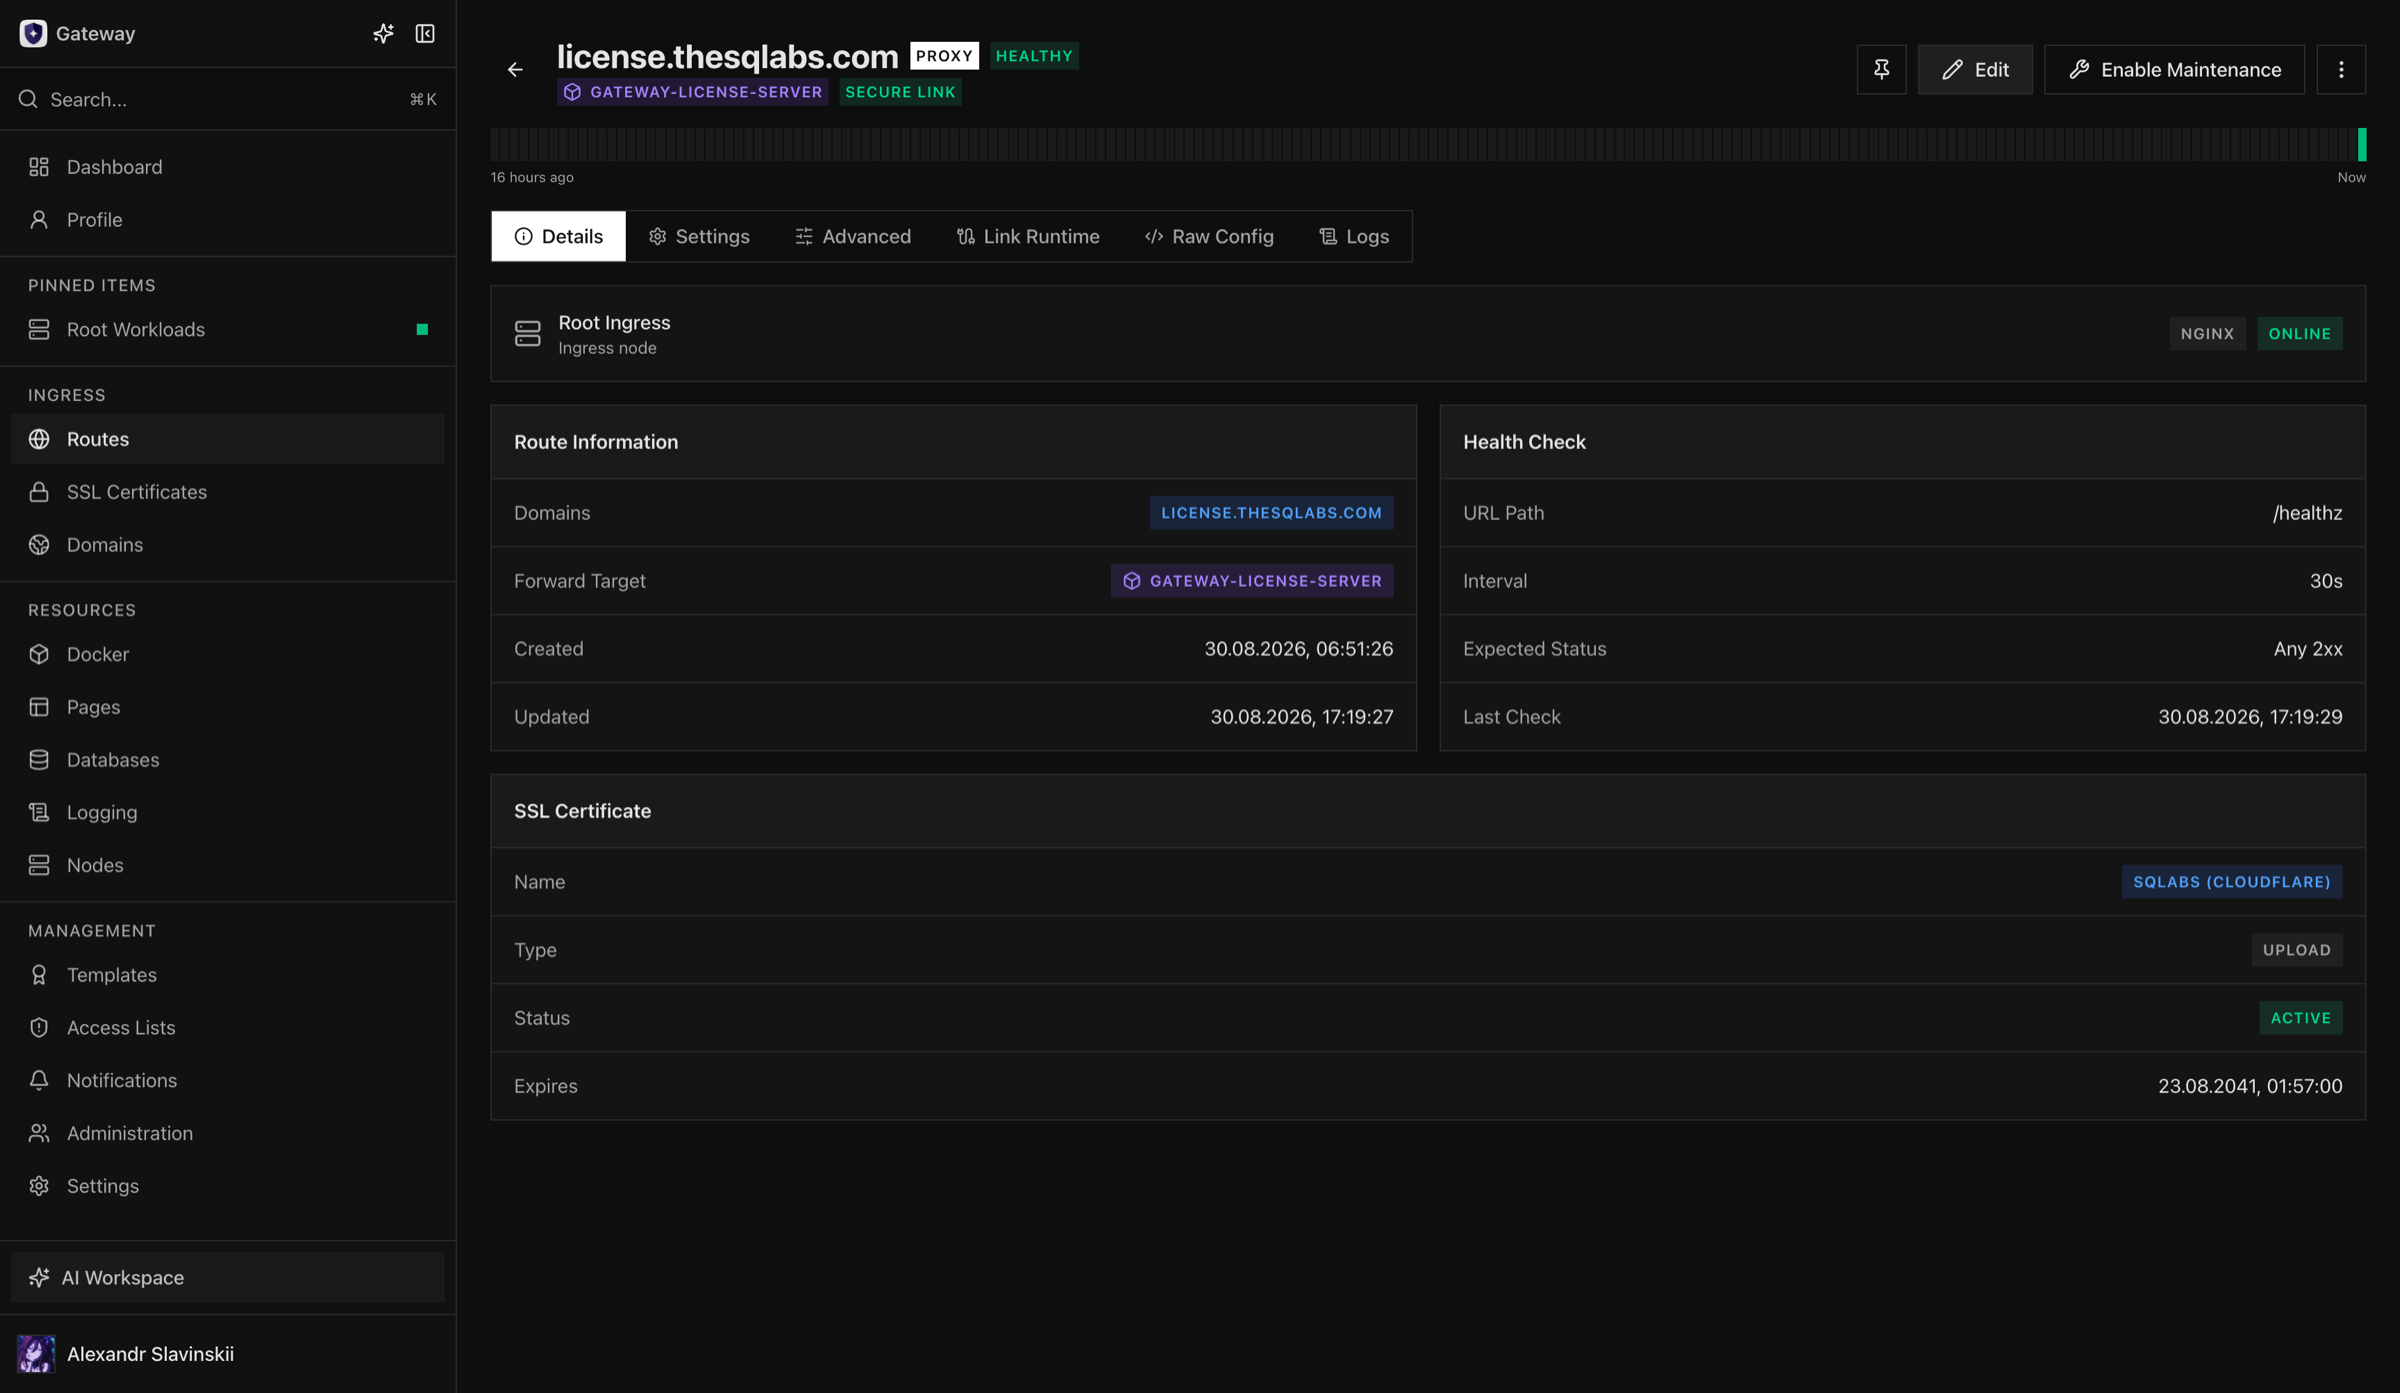
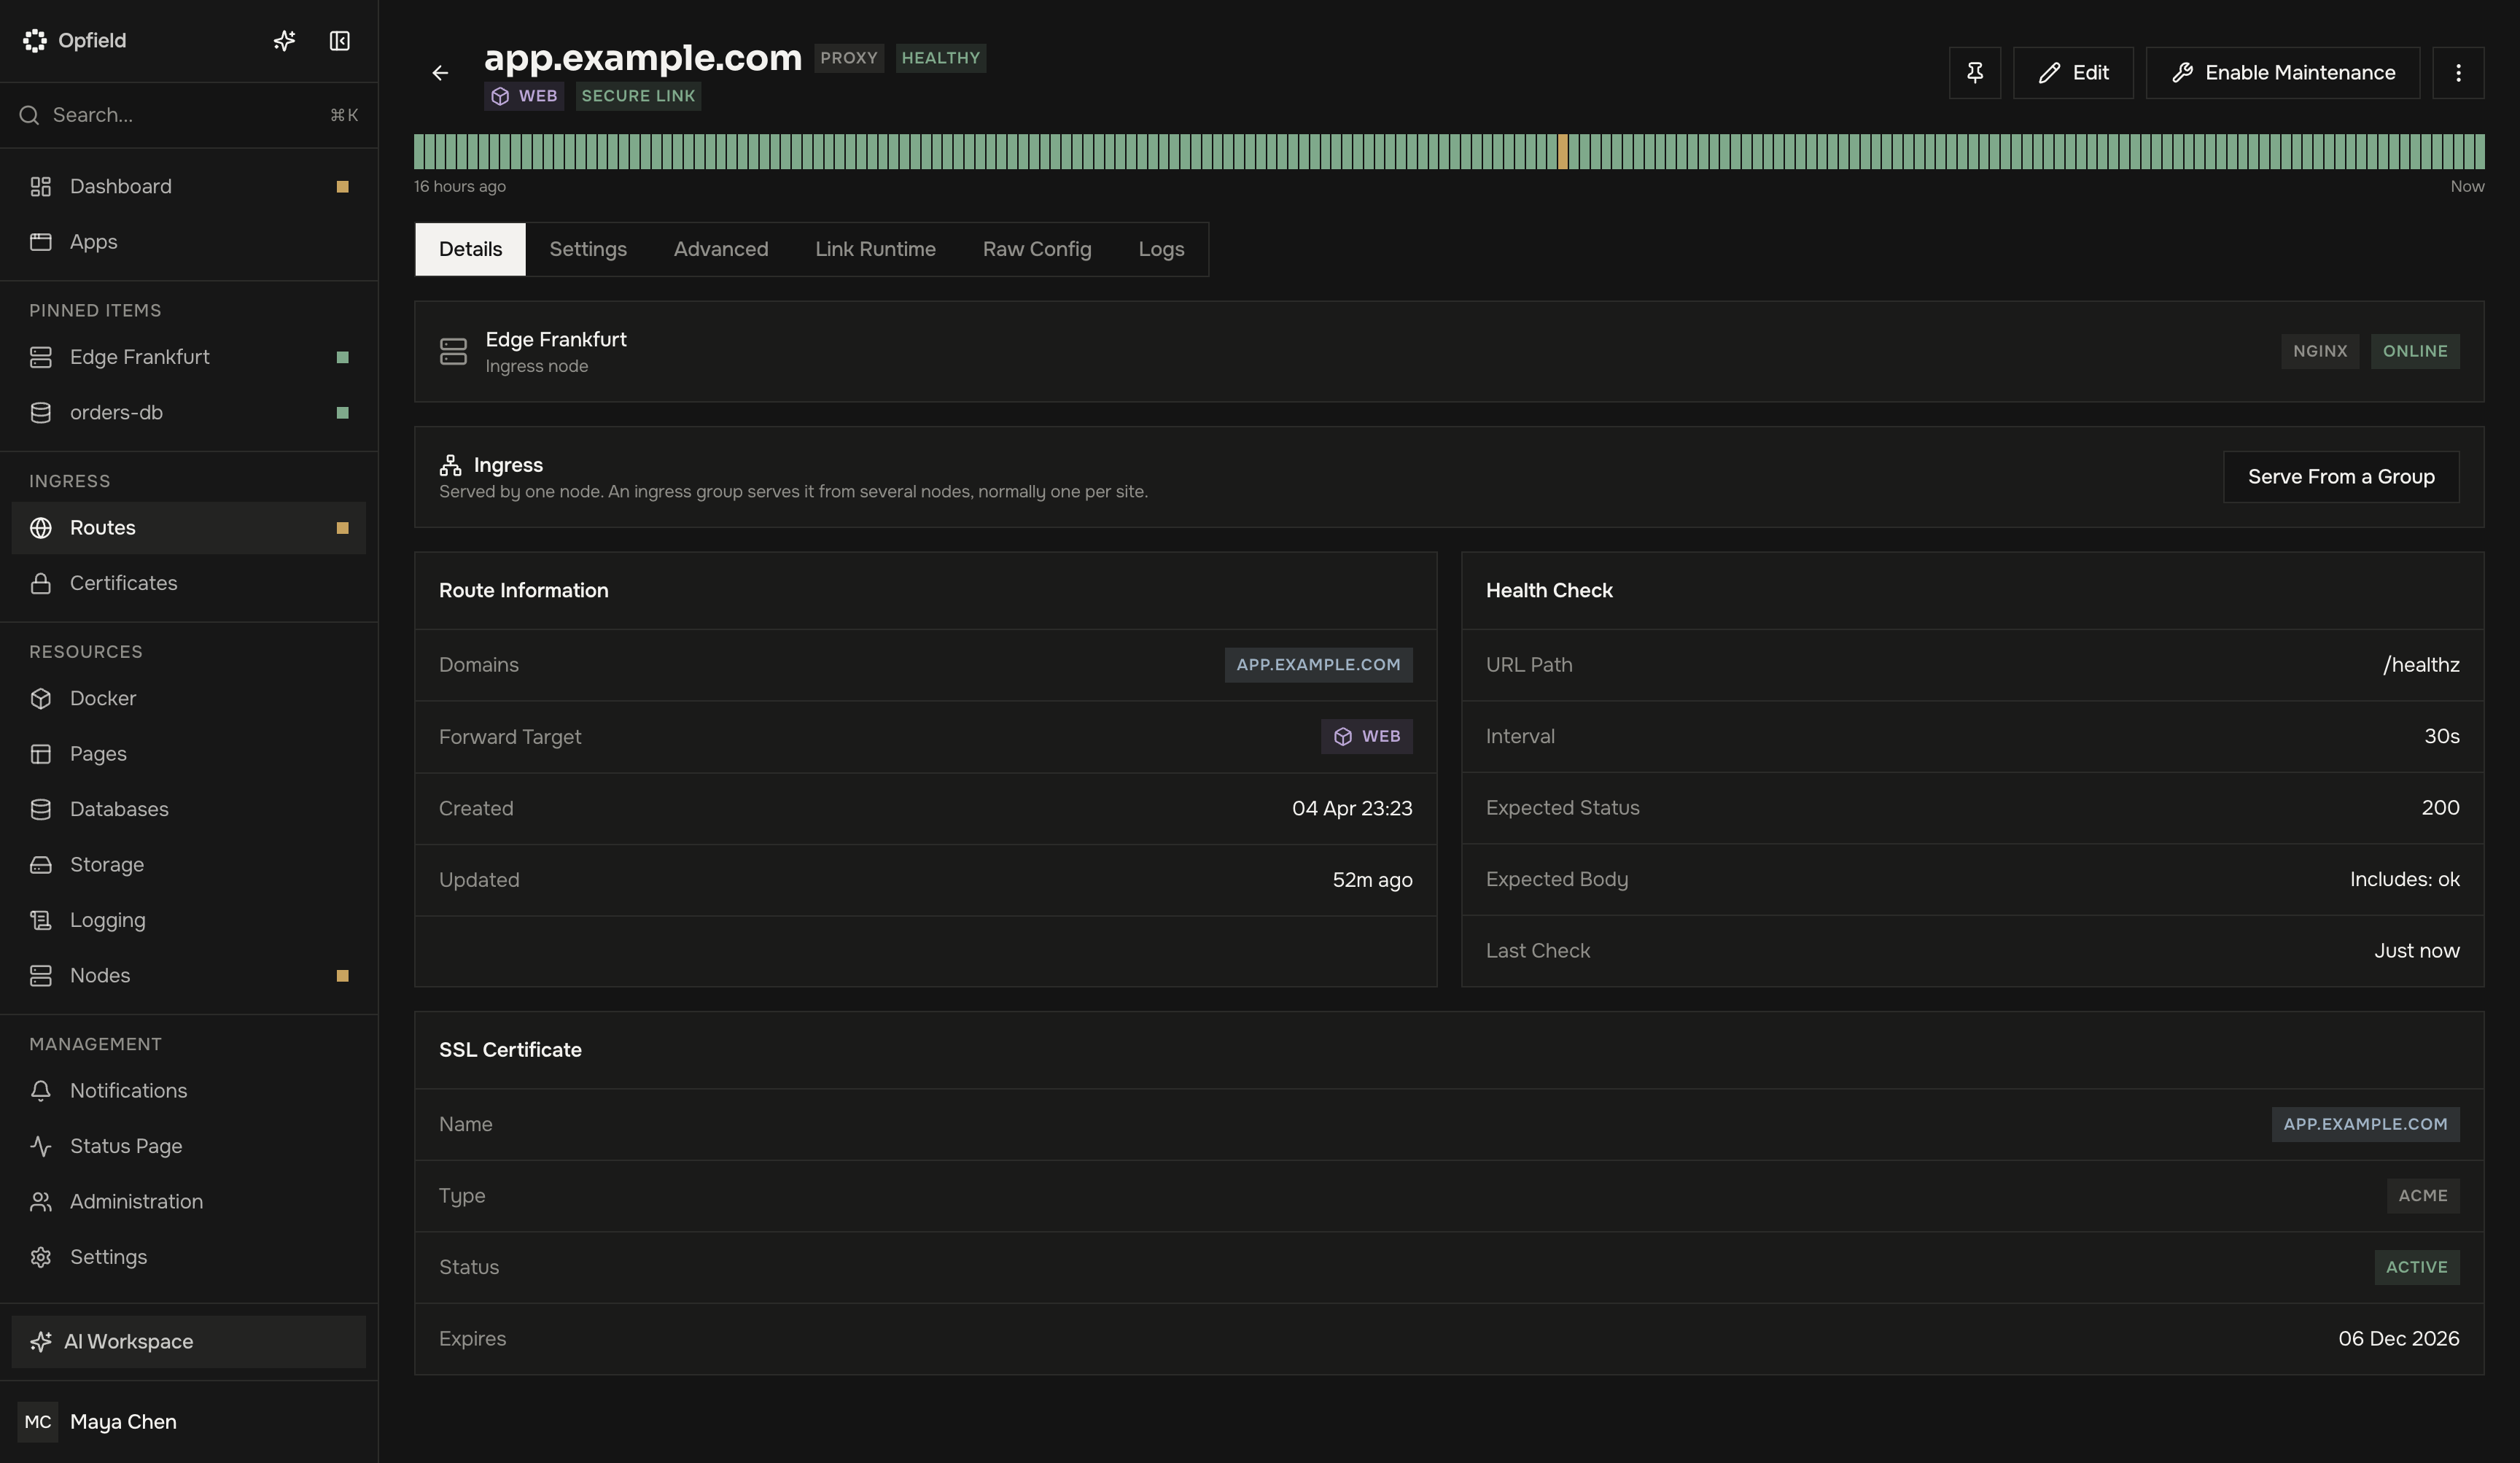
Attendez que la Route et la configuration de l’ingress soient réconciliées avec succès. Ne modifiez pas directement la configuration nginx générée : Opfield est la source de vérité et réconciliera l’état géré.
6. Test de recette
Section intitulée « 6. Test de recette »Côté utilisateur
Section intitulée « Côté utilisateur »- Le DNS se résout correctement depuis un réseau externe.
- TLS est de confiance et couvre le nom d’hôte.
- La page principale ou le point de terminaison d’API renvoie la version attendue.
- La connexion, les rappels, les téléversements, le streaming et les WebSockets fonctionnent le cas échéant.
- Les réponses de maintenance et de refus d’accès sont intentionnelles et ont l’apparence attendue.
Côté plateforme
Section intitulée « Côté plateforme »- La charge de travail signale l’empreinte ou le commit approuvés.
- La santé d’exécution, les journaux et l’utilisation des ressources sont stables.
- La santé de la Route et l’exécution du Secure Link sont saines.
- Les journaux d’accès et d’erreurs de l’ingress montrent les requêtes de recette sans échecs répétés de l’upstream.
- Un redémarrage de la charge de travail ne fait perdre ni les données persistantes ni la configuration de la liaison.
- Les notifications atteignent le responsable attendu lors d’un événement de test contrôlé.
Côté gouvernance
Section intitulée « Côté gouvernance »- Les utilisateurs à privilèges minimaux ne peuvent exploiter que les ressources qui leur sont attribuées.
- La publication, le changement de Route et les opérations associées apparaissent dans les tâches et l’activité récente, ainsi que dans l’historique d’audit.
- La couverture des sauvegardes inclut les volumes avec état et les dépendances externes, et pas seulement la définition du conteneur.
7. Retour arrière et frontière d’incident
Section intitulée « 7. Retour arrière et frontière d’incident »Consignez la dernière cible réputée saine avant la promotion. Pour un Deployment, vérifiez que le slot précédent reste sain. Pour un Container, conservez l’empreinte d’image immuable et la configuration précédentes. Pour Compose, conservez la révision immuable précédente. Pour la livraison Git, conservez le build approuvé et le commit source exact.
Si la publication échoue mais que l’ingress est sain, revenez en arrière sur la charge de travail plutôt que de supprimer le domaine, le certificat ou la Route. Utilisez la maintenance de la Route lorsque le trafic doit être arrêté tout en préservant la ressource et sa configuration. Si une migration a déjà modifié des données, le retour arrière applicatif seul peut être dangereux ; suivez le plan de restauration des données.
Après le retour arrière, répétez les tests côté utilisateur et examinez les journaux pour repérer les requêtes qui ont pu atteindre la révision défaillante. Conservez l’artefact défaillant et les éléments de l’opération jusqu’à la fin de l’analyse de l’incident.
Carte de diagnostic
Section intitulée « Carte de diagnostic »| Symptôme | À vérifier d’abord | Guide détaillé |
|---|---|---|
| La charge de travail ne devient jamais prête | Tâche propriétaire, journaux de l’application, port et vérification de santé | Vue d’ensemble de Docker |
| La Route ne se publie pas | DNS, TLS, application de nginx, santé de la Route et upstream | Dépannage de l’ingress |
| Le Secure Link est indisponible | Les deux nœuds, Relay, la charge de travail cible et l’opération du connecteur | Upstreams sécurisés |
| La nouvelle version n’est pas saine | Revenez en arrière sur la charge de travail propriétaire ; laissez la Route intacte | Deployments blue-green |
| Une migration a modifié des données | Arrêtez les écritures et suivez le plan distinct de restauration des données | Mises à jour et sauvegardes |