

Opfield Inference
Opfield Inference donne à une équipe un point de terminaison unique pour les modèles d’IA approuvés. Les administrateurs connectent des comptes de fournisseurs, regroupent des sources compatibles derrière des identifiants de modèles publics stables, décident qui peut utiliser chaque modèle et définissent des limites par utilisateur. Les utilisateurs et les agents de code reçoivent un seul jeton Opfield au lieu d’identifiants pour chaque fournisseur en amont.
C’est un plan de données distinct d’AI Workspace et du MCP distant. AI Workspace est l’assistant intégré à l’interface d’Opfield ; MCP expose des outils d’infrastructure à des agents externes ; Opfield Inference transporte les requêtes et réponses des modèles pour les clients d’IA compatibles. Activer l’un n’active pas silencieusement les autres, et leurs identifiants ne sont pas interchangeables.
Ce que résout Opfield Inference
Section intitulée « Ce que résout Opfield Inference »- Une seule configuration client : les clients conservent la même URL de base Opfield et le même identifiant de modèle public pendant que les administrateurs changent de sources en amont compatibles.
- Contrôle d’accès centralisé : les modèles publiés peuvent être réservés à certains utilisateurs et groupes.
- Isolation des fournisseurs : les utilisateurs finaux ne reçoivent jamais l’abonnement ni les identifiants d’API du fournisseur.
- Routage tenant compte de la capacité : Opfield prend en compte l’état des connexions, le quota découvert, les budgets, la compatibilité des sources et la disponibilité actuelle avant d’envoyer une requête.
- Comptabilité normalisée : la capacité des abonnements devient des crédits ; l’utilisation par clé d’API devient une dépense valorisée ; les deux restent attribuables à l’utilisateur Opfield.
- Traçabilité opérationnelle : les requêtes, tentatives, sources sélectionnées, consommations, échecs et états finaux sont enregistrés sans placer le corps des prompts et des réponses dans les journaux d’activité normaux.
Opfield ne crée pas de capacité chez les fournisseurs et ne remplace pas leurs conditions de confidentialité, de disponibilité, de résidence des données ou contractuelles. Une connexion saine signifie qu’Opfield peut l’utiliser actuellement, et non que le fournisseur garantit une capacité future.
Architecture et flux des requêtes
Section intitulée « Architecture et flux des requêtes »flowchart TD Client[Client d'IA<br/>Codex · Claude Code · SDK] --> API[API Opfield Inference<br/>identifiant de modèle stable] API --> Admission[Authentifier l'utilisateur<br/>vérifier les accès et les budgets] Admission --> Router[Routeur d'inférence<br/>classer les sources compatibles] Router --> Subscription[Source par abonnement] Router --> ApiKey[Source par clé d'API] Router --> Local[Autre source compatible] Subscription --> Provider[Fournisseur de modèle sélectionné] ApiKey --> Provider Local --> Provider Provider --> Response[Réponse en streaming ou complète] Response --> Ledger[Régler la consommation<br/>crédits ou dépense d'API] Ledger --> Client
L’application Opfield détient les utilisateurs, la publication des modèles, les permissions, les budgets et la consommation visible. Le cœur d’inférence supervisé détient la traduction des protocoles et l’exécution. Les connexions aux fournisseurs restent des dépendances externes, et le client détient le prompt, les identifiants de continuation et le traitement de la réponse finale.
Parcours de l’administrateur
Section intitulée « Parcours de l’administrateur »- Activez Inference dans Settings > General.
- Installez le cœur d’inférence supervisé et attendez qu’il se signale sain.
- Ajoutez une connexion de fournisseur et terminez son processus d’authentification.
- Attendez la découverte des modèles et des quotas ; ne publiez pas à partir de données de découverte périmées.
- Créez un modèle public et rattachez-y une ou plusieurs sources compatibles au niveau du protocole.
- Définissez avec exactitude le contexte, la sortie, les modalités, la tarification et les multiplicateurs d’abonnement.
- Configurez une politique de limites par défaut, puis ajoutez des remplacements par utilisateur plus restrictifs si nécessaire.
- N’accordez
feat:ai:usequ’aux utilisateurs ou groupes qui doivent appeler Inference. - Testez une requête normale, un flux, un modèle refusé, une limite épuisée et une panne de source sans danger.
N’ajoutez une source de secours que si son protocole, ses modalités, sa taille de contexte, son comportement avec les outils et la sémantique de sa sortie correspondent à ceux des autres sources du modèle.
Parcours de l’utilisateur et points de terminaison client
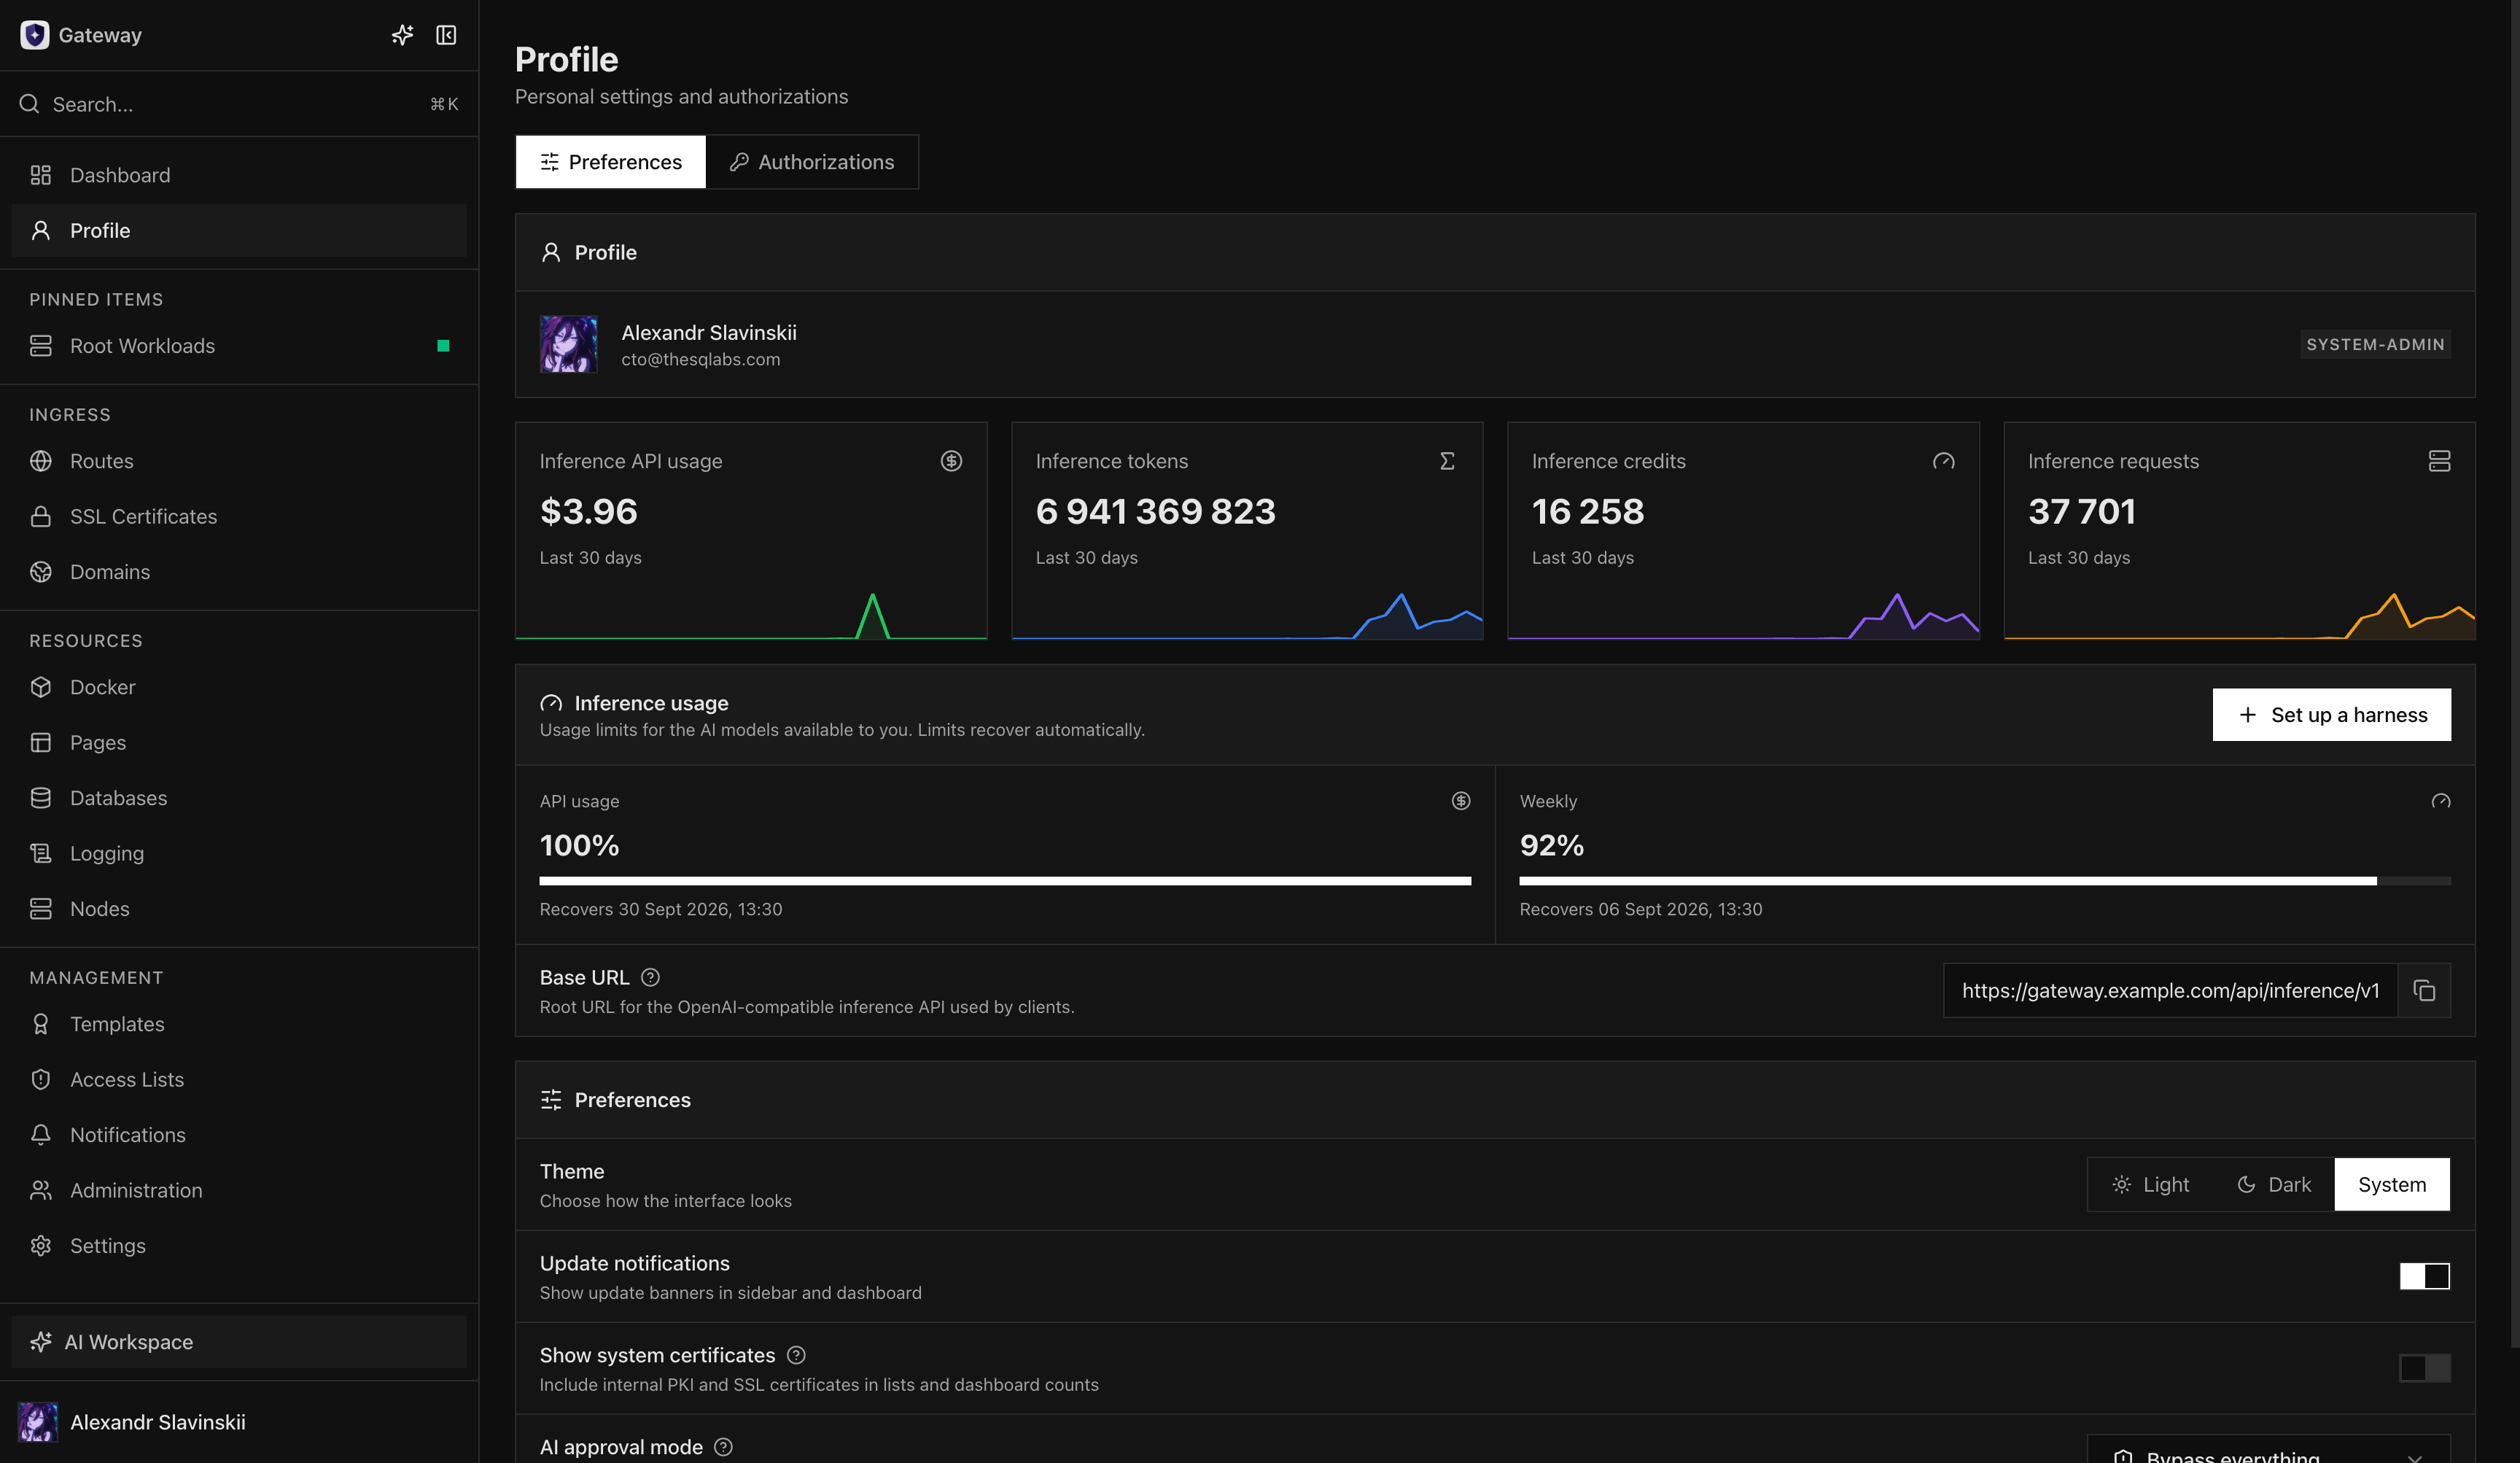
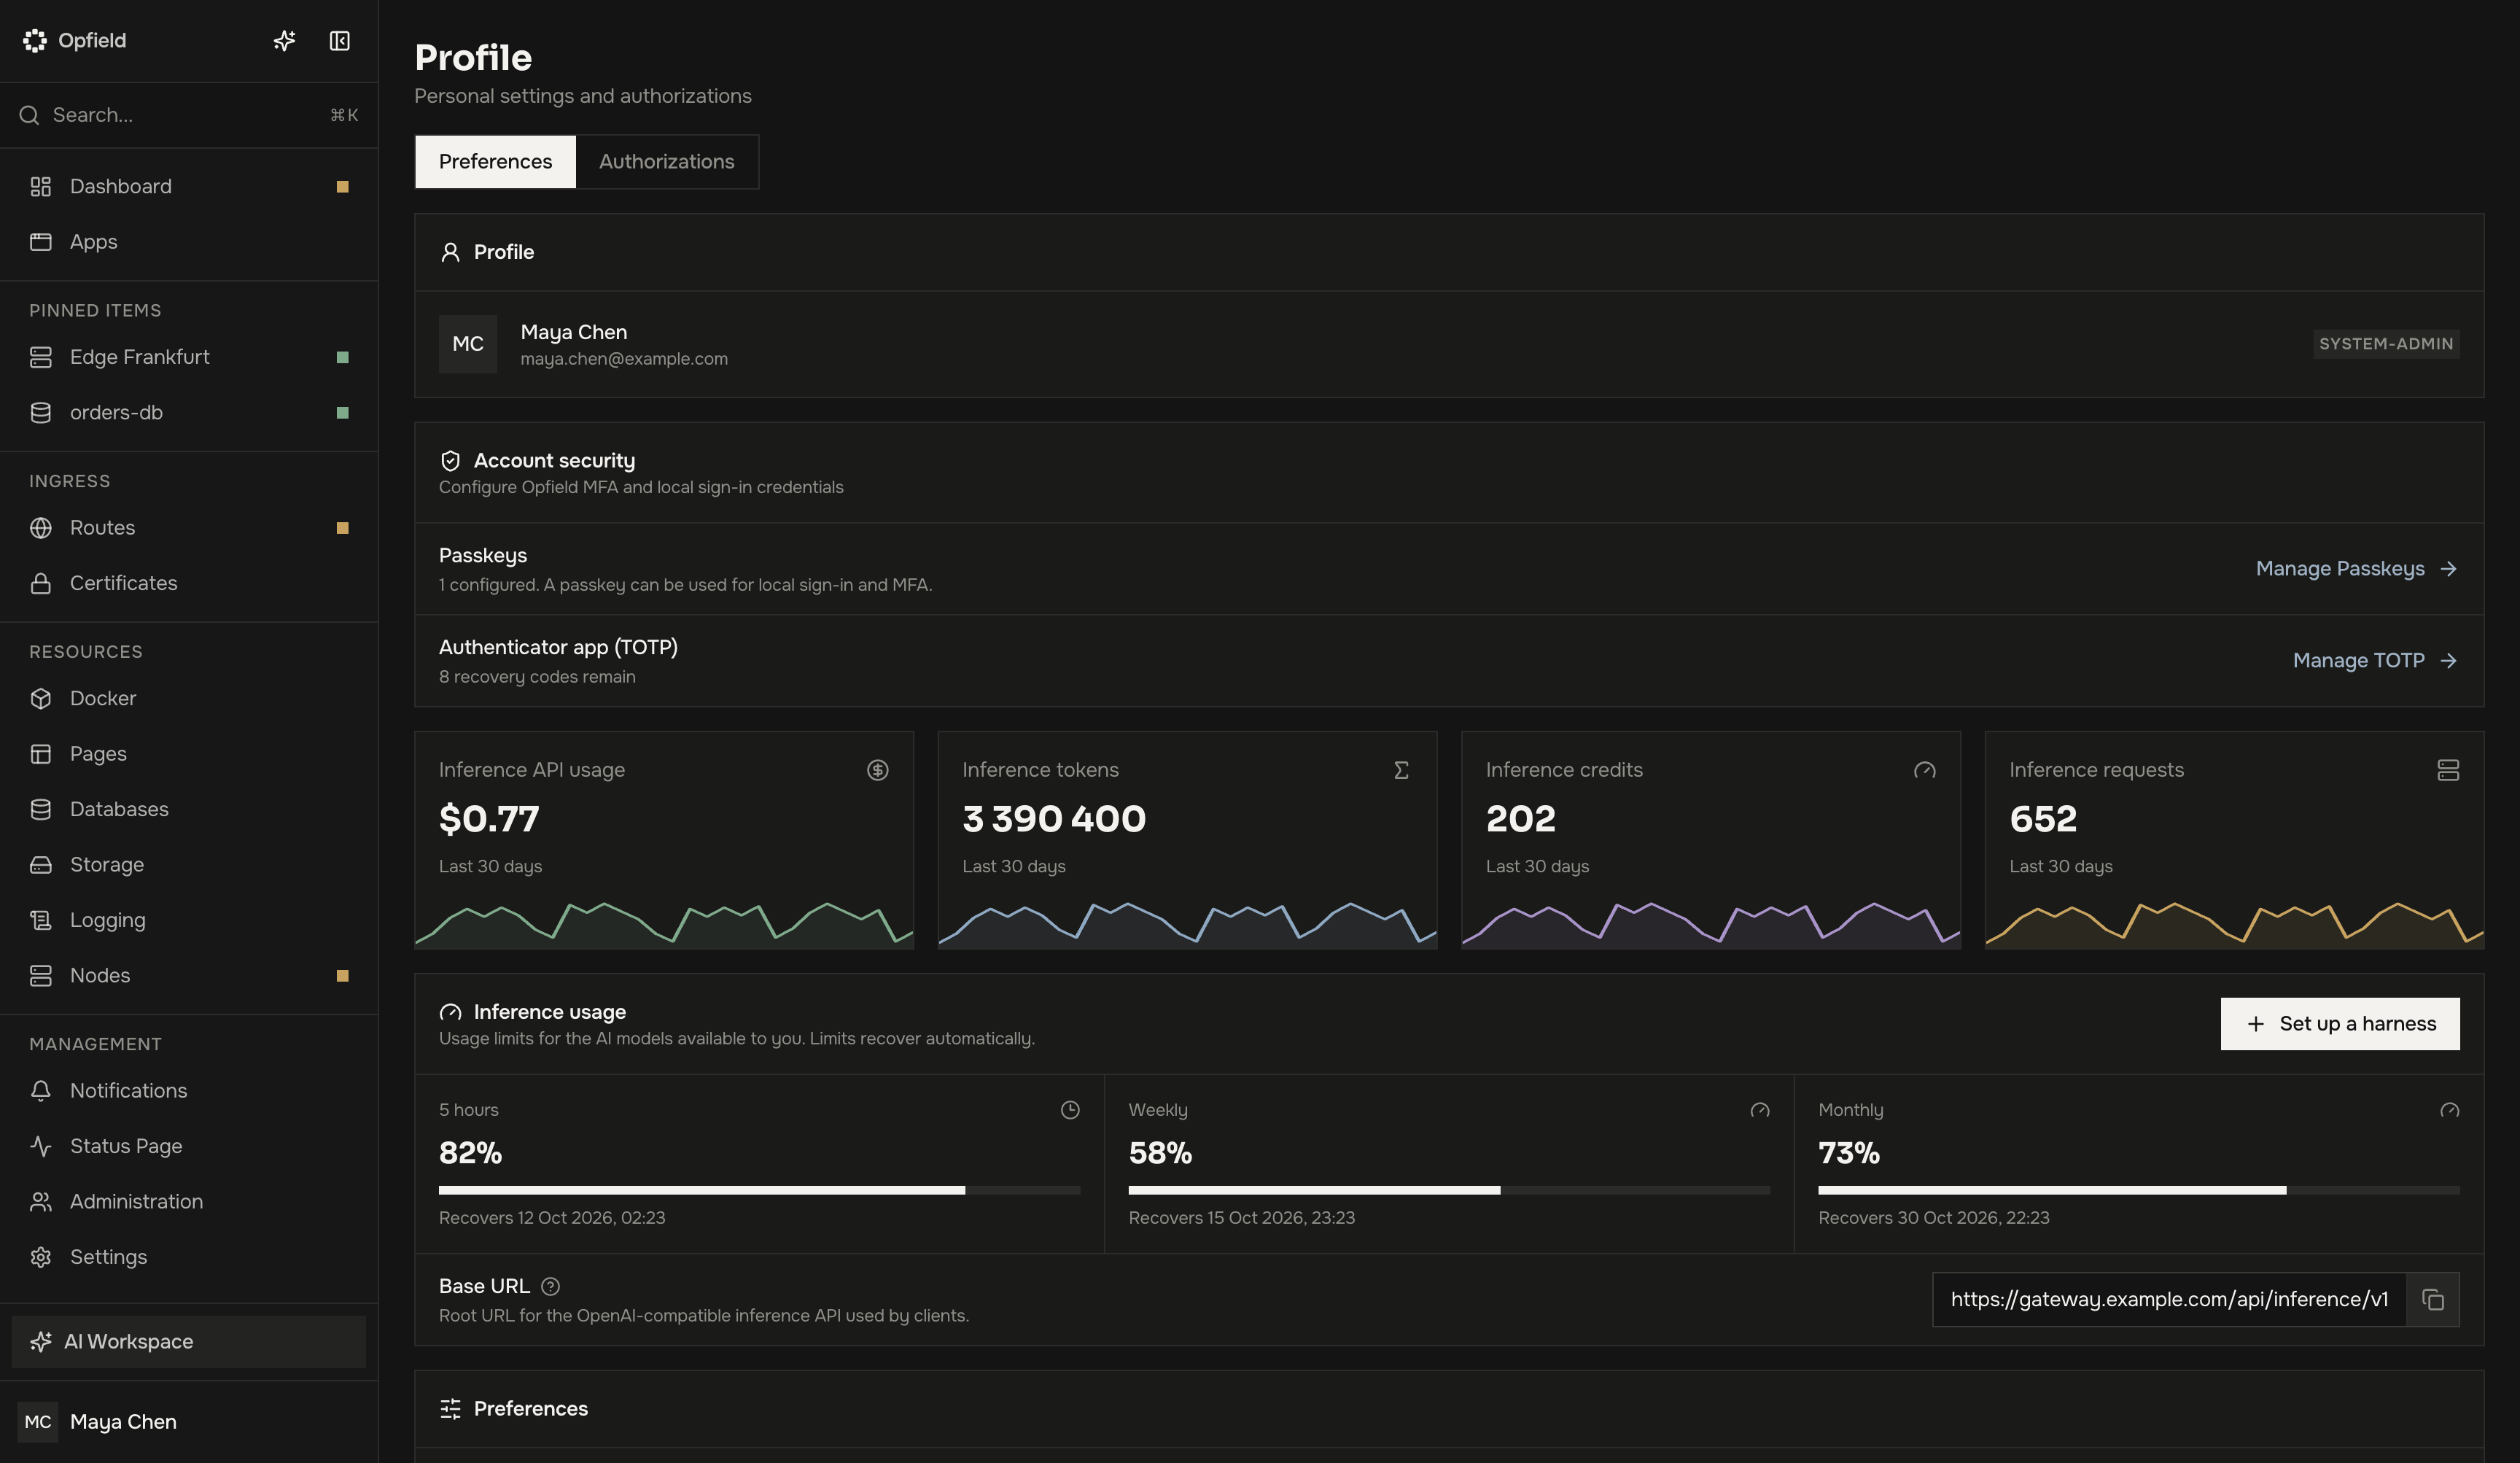
Section intitulée « Parcours de l’utilisateur et points de terminaison client »Les utilisateurs ont besoin de feat:ai:use. Pour connecter un harnais (harness), cliquez sur Set up a harness dans le panneau Inference usage de Profile (affiché lorsqu’au moins une limite s’applique à l’utilisateur) ou dans la ligne Inference endpoints de Settings > Inference. La boîte de dialogue Set Up an Inference Harness affiche les valeurs à coller dans les paramètres de fournisseur du harnais lui-même :
- URL de base compatible OpenAI :
https://opfield.example.com/api/inference/v1; - URL de base compatible Anthropic :
https://opfield.example.com/api/inference; les clients Anthropic ajoutent eux-mêmes/v1/messages; - Clé d’API : un nouveau jeton
gwi_que la boîte de dialogue crée pour l’utilisateur et n’affiche qu’une fois. Chaque ouverture révoque les clés des ouvertures précédentes qu’aucun client n’a utilisées ; - Modèle : tout modèle disponible pour l’utilisateur.
Le harnais recommandé est DeepSeek harness : ajoutez Opfield comme fournisseur dans ses paramètres avec ces valeurs. Tout autre harnais ou SDK qui accepte un fournisseur compatible OpenAI ou Anthropic se configure de la même manière.
Pour créer un jeton sans la boîte de dialogue, utilisez Profile > Authorizations > Inference API Tokens. Le jeton n’est affiché qu’une fois et appartient à cet utilisateur.
| Famille de clients | URL de base |
|---|---|
| Clients compatibles OpenAI | https://opfield.example.com/api/inference/v1 |
| SDK Anthropic et clients compatibles Claude | https://opfield.example.com/api/inference |
Utilisez l’identifiant de modèle public publié par l’administrateur, et non le nom de modèle d’un fournisseur en amont. GET /api/inference/v1/models liste les modèles qu’une clé gwi_ peut appeler ; la Console lit la même liste avec la session de l’utilisateur via GET /api/inference/catalog.
Fournisseurs, sources et modèles publics
Section intitulée « Fournisseurs, sources et modèles publics »Une connexion de fournisseur représente un compte ou un point de terminaison en amont authentifié. La découverte enregistre les modèles, les capacités techniques et les informations de quota actuellement signalés par cette connexion, et renseigne les limites des modèles, les niveaux de raisonnement et les modalités à partir de la liste en direct du fournisseur. Lorsque le cœur d’inférence ne peut pas lire le compte ou a besoin d’une nouvelle connexion, la synchronisation en signale la raison au lieu d’un succès, et un ancien relevé de quota n’est pas enregistré comme actuel. Lorsque le basculement épuise les comptes, les clients reçoivent l’erreur réelle du fournisseur, comme une erreur d’authentification, de quota ou un refus. Claude Fable 5.1, Mythos 5.1 et Opus 5.5 sont reconnus ; les modèles Fable 5.1 et Opus 5.5 publiés avant 2.11 ont les outils désactivés et doivent être enregistrés à nouveau.
Une source relie un modèle de fournisseur découvert à un modèle Opfield publié. Une source peut remplacer le multiplicateur d’abonnement lorsque son coût réel en capacité diffère de la valeur par défaut du modèle. Désactiver une source la retire du routage des nouvelles requêtes sans obliger les clients à changer d’identifiant de modèle public.
Un modèle publié est le contrat stable exposé aux utilisateurs. Il définit l’identifiant public, les limites de contexte et de sortie, les capacités, les règles d’accès et les sources compatibles. Des noms en amont similaires ne suffisent pas : deux sources ne sont des alternatives sûres que si leur protocole de requête et leur comportement visible par l’utilisateur sont compatibles.
Les sources de fournisseurs utilisent normalement l’un de deux modes de comptabilité :
| Type de source | Ce qu’Opfield limite |
|---|---|
| Abonnement | Crédits sur des fenêtres activées de 5 heures, 7 jours et 30 jours |
| Clé d’API | Consommation valorisée imputée sur un budget de dépenses par mois calendaire |
Les points de terminaison locaux ou hébergés en privé nécessitent tout de même une politique de tarification et de source explicite s’ils participent à l’application des budgets. Ne publiez pas une source dont les capacités ou la tarification sont inconnues simplement parce qu’une vérification de santé réussit.
Un modèle publié peut aussi porter un System prompt pour le harnais Codex. Append to harness default conserve les instructions par défaut de Codex, y compris ses règles d’outils et de format de patch, et ajoute le prompt après elles ; Replace harness default les remplace entièrement : un remplacement doit donc reformuler toutes les règles dont le modèle a encore besoin. Le prompt atteint un appareil lors de la prochaine actualisation du catalogue de modèles et du redémarrage de Codex.
Cycle de vie des requêtes et basculement
Section intitulée « Cycle de vie des requêtes et basculement »Pour chaque requête, Opfield :
- valide le jeton
gwi_et résout son utilisateur ; - résout le modèle public et vérifie l’accès de l’utilisateur ;
- construit un ensemble de sources éligibles à partir des modèles, sources et connexions activés, de la compatibilité des protocoles, du quota et de l’état des budgets ;
- réserve une quantité prudente de capacité avant de contacter un fournisseur ;
- envoie la requête via le cœur d’inférence et normalise le streaming, la consommation et les erreurs ;
- ne réessaie avec une autre source compatible que lorsque l’échec est classé comme relançable et qu’une autre source éligible existe ;
- règle la réservation avec la consommation réelle du fournisseur, ou avec une estimation bornée lorsque la consommation exacte n’arrive jamais ;
- écrit un état final de la requête et une entrée dans le registre de consommation.
Certains protocoles exigent une affinité de source pour les continuations. Opfield préserve cette affinité tant qu’elle reste valide et l’efface lorsque le cycle de vie permet une relance sûre. Les clients ne doivent pas supposer que tout échec peut passer chez un autre fournisseur : une entrée invalide, un accès refusé, un identifiant de continuation invalide et un budget utilisateur épuisé ne sont pas des événements de basculement de capacité.
Les requêtes en streaming et sans streaming doivent atteindre un état final unique. Après une interruption réseau, examinez la requête enregistrée avant de soumettre un doublon potentiellement coûteux.
Pendant les longues réponses SSE silencieuses, y compris la compaction, Opfield envoie un commentaire keepalive initial et vérifie toutes les 15 secondes si un autre est nécessaire. Les commentaires ne sont émis qu’entre des événements complets et lorsque le consommateur peut accepter des données. Ce ne sont ni des sorties du modèle ni des événements de fin ; c’est toujours le véritable événement final qui détermine la comptabilité. Cela protège le flux HTTP contre les délais d’inactivité des intermédiaires.
Crédits et comptabilité de la consommation
Section intitulée « Crédits et comptabilité de la consommation »Les crédits sont une mesure normalisée de la consommation auprès des fournisseurs par abonnement. Ce ne sont pas de l’argent, et ils ne sont volontairement pas identiques aux totaux bruts de tokens. Opfield pondère les catégories de tokens, puis applique les multiplicateurs effectifs de la source.
Formule des crédits
Section intitulée « Formule des crédits »weighted tokens = uncached input tokens + cached input tokens × 0.10 + cache-write tokens × 1.25 + output tokens + reasoning tokens
public credits = weighted tokens ÷ 1,000,000 × model multiplier × burn multiplier × service-tier multiplierAvec un multiplicateur total de 1×, un crédit public représente un million de tokens pondérés.
| Composante | Poids | Pourquoi elle diffère |
|---|---|---|
| Entrée hors cache | 1.00 |
Traitement complet du prompt |
| Lecture d’entrée en cache | 0.10 |
Réutiliser un cache existant du fournisseur coûte moins cher |
| Écriture en cache | 1.25 |
La création d’un état de cache consomme une capacité supplémentaire |
| Sortie | 1.00 |
Les tokens générés comptent intégralement |
| Raisonnement | 1.00 |
Les tokens de raisonnement signalés comptent intégralement |
Les multiplicateurs signifient :
- Multiplicateur du modèle : le coût d’abonnement du modèle publié, éventuellement remplacé par une source précise.
- Multiplicateur de consommation (burn) : protège la capacité d’abonnement partagée lorsque le quota du fournisseur est consommé plus vite que le temps restant ne le permet. Il vaut normalement
1×, peut augmenter dynamiquement et est plafonné à8×. Les requêtes de compaction utilisent1×. - Multiplicateur de niveau de service : les requêtes d’abonnement OpenAI utilisant le niveau
Fast/priorityconsomment2×crédits. Les autres combinaisons actuelles utilisent1×.
Le multiplicateur de consommation compare le quota d’abonnement restant au temps restant dans chaque fenêtre découverte du fournisseur. Sous une forme simplifiée :
burn multiplier = min(8, max( 1, time remaining fraction ÷ quota remaining fraction, 0.30 ÷ quota remaining fraction))Opfield calcule le multiplicateur par modèle, sur l’ensemble des comptes d’abonnement de ce modèle. Une fenêtre de quota qu’un fournisseur limite à une famille de modèles ne compte que pour cette famille. L’absence de données de quota laisse le multiplicateur à 1× ; un quota découvert périmé, vide ou épuisé peut imposer la valeur protectrice de 8×.
Exemple chiffré
Section intitulée « Exemple chiffré »Supposons qu’une semaine comprenne :
- 600 millions de tokens d’entrée hors cache ;
- 1,5 milliard de tokens d’entrée en cache ;
- 100 millions de tokens d’écriture en cache ;
- 300 millions de tokens de sortie ;
- 50 millions de tokens de raisonnement.
Le total pondéré est :
600M + 1,500M × 0.10 + 100M × 1.25 + 300M + 50M= 1,225M weighted tokensAvec un multiplicateur de modèle de 2×, un multiplicateur de consommation de 1.25× et le niveau de service normal 1× :
1,225M ÷ 1M × 2 × 1.25 × 1 = 3,062.5 creditsC’est pourquoi deux utilisateurs ayant des totaux bruts de tokens similaires peuvent consommer des crédits différents : le comportement du cache, le choix du modèle, la pression sur le quota du fournisseur et le niveau de service comptent tous.
Limites hebdomadaires de crédits suggérées
Section intitulée « Limites hebdomadaires de crédits suggérées »La limite sur 7 jours est une fenêtre de consommation qui commence avec la première requête de l’utilisateur adossée à un abonnement, et non une allocation par semaine calendaire. Ces valeurs sont des points de départ approximatifs pour un utilisateur qui exécute des agents de code ou d’autres charges de travail à contexte long :
| Limite hebdomadaire | Profil d’utilisation | Interprétation pratique |
|---|---|---|
2,500 crédits |
Léger | Sessions d’agent occasionnelles et travail quotidien court |
5,000 crédits |
Régulier | Développement quotidien avec un contexte et un usage d’outils modérés |
7,500 crédits |
Intensif | Longues sessions fréquentes, plusieurs dépôts ou travail répété à grand contexte |
10,000 crédits |
Lourd | Usage quotidien soutenu d’agents avec un renouvellement important du contexte |
15,000 crédits |
Très lourd | Charges de travail quasi continues d’utilisateurs avancés ou multi-agents |
Considérez ce tableau comme une base de politique, et non comme la promesse d’un nombre fixe de requêtes ou de tokens. Commencez par le profil le plus proche, observez au moins une fenêtre complète de 7 jours, puis ajustez en fonction des multiplicateurs réels du modèle et de consommation. Utilisez des politiques par utilisateur au lieu de multiplier une limite partagée par la taille de l’équipe.
Fenêtres de consommation et marge de sécurité
Section intitulée « Fenêtres de consommation et marge de sécurité »La consommation par abonnement peut être limitée indépendamment sur 5 heures, 7 jours et 30 jours. Une consommation est comptée dans chaque fenêtre activée. Chaque fenêtre commence avec la première requête de l’utilisateur adossée à un abonnement après la fin de la fenêtre précédente, et se réinitialise complètement à son expiration ; la fenêtre suivante commence avec la requête suivante de ce type. L’interface indique l’heure de réinitialisation de chaque fenêtre.
Opfield réserve de la capacité avant d’envoyer une requête, et la totalité de la limite d’abonnement configurée peut être consommée. Une requête admise alors que l’utilisateur dispose encore d’un solde positif s’exécute toujours jusqu’au bout ; le dernier échange peut donc se régler légèrement au-delà de la limite ; Opfield n’écourte jamais une requête admise. La requête suivante, une fois le solde épuisé, est refusée avec l’heure de rétablissement de la fenêtre.
Les sources par clé d’API ne consomment pas de crédits d’abonnement. Opfield valorise l’entrée hors cache, l’entrée en cache, les écritures en cache, la sortie, le raisonnement et les facturations unitaires prises en charge à l’aide de l’instantané de tarification actuel de la source, puis applique la limite de dépenses mensuelle configurée. Rapprochez cette estimation opérationnelle du relevé du fournisseur avant de prendre des décisions financières.
Visibilité de la consommation et administration
Section intitulée « Visibilité de la consommation et administration »Les utilisateurs peuvent voir leur consommation Inference actuelle et leurs fenêtres de rétablissement dans Profile. Le tableau de bord peut signaler les fenêtres presque épuisées ou épuisées. Les administrateurs disposant de l’accès à la consommation peuvent examiner les totaux du système, les politiques par utilisateur, l’activité des requêtes, les catégories de tokens, les crédits, les dépenses d’API, les modèles sélectionnés et les états finaux.
Configurez d’abord les valeurs par défaut du système. Une politique par utilisateur peut restreindre la valeur par défaut, mais ne doit pas rouvrir silencieusement une dimension désactivée globalement. Ne réinitialisez la consommation que pour une raison opérationnelle explicite ; augmenter une limite est généralement plus clair que d’effacer l’historique qui sert à expliquer un incident.
Confidentialité et frontières des identifiants
Section intitulée « Confidentialité et frontières des identifiants »Opfield ne place pas le corps des prompts ou des sorties des modèles dans les enregistrements d’activité normaux. Il stocke des métadonnées normalisées, les catégories de tokens, le coût, la source sélectionnée, les tentatives, les erreurs et l’état final. Le fournisseur sélectionné reçoit toujours le contenu de la requête ; examinez donc les conditions de conservation, d’entraînement, de résidence et de traitement des données de ce fournisseur avant de le publier.
Les jetons gwi_ ne sont valables que pour Opfield Inference. Les sessions de navigateur, les jetons d’API REST gw_, les jetons OAuth gwo_, les jetons de journalisation gwl_ et l’autorisation MCP ne peuvent pas les remplacer. Utilisez des jetons distincts pour des clients distincts et révoquez un jeton lorsque son client ou son propriétaire change.
Les adresses en amont privées sont refusées par défaut. Ne les autorisez que lorsque l’administrateur accepte intentionnellement la frontière de confiance réseau et a protégé le chemin contre la falsification de requêtes côté serveur (SSRF) et les accès internes non souhaités.
Diagnostic des échecs
Section intitulée « Diagnostic des échecs »| Symptôme | À vérifier d’abord |
|---|---|
401 |
Le jeton gwi_ existe, n’est pas révoqué et est envoyé à l’URL de base d’Inference |
| Modèle introuvable ou refusé | Identifiant de modèle public, accès du groupe, activation des sources et capacités publiées |
| Capacité indisponible | Découverte actuelle, quota du fournisseur, état de la connexion, sources de secours éligibles |
| Budget épuisé | Crédits 5h/7j/30j de l’utilisateur ou limite de dépenses d’API mensuelle, et heure de rétablissement |
| Continuation refusée | Affinité avec la source d’origine, identifiant de continuation et compatibilité du fournisseur |
| Le flux s’arrête sans se terminer | Déconnexion du client, événement final du fournisseur, état de la tentative et réconciliation |
| La consommation semble anormalement élevée | Classification du cache, multiplicateur du modèle, multiplicateur de consommation dynamique et niveau Fast/priority |
| Les dépenses d’API diffèrent de la facture | Instantané de tarification, niveau de contexte long, facturations unitaires hors tokens et relevé du fournisseur |
Examinez dans cet ordre l’état du cœur d’inférence, l’état de la connexion au fournisseur, les modèles et quotas découverts, les règles de publication, l’accès du jeton, les limites de l’utilisateur, les candidats éligibles et la compatibilité des protocoles. Redémarrer le cœur ne remplace pas la correction d’un contrat de fournisseur ou de modèle invalide.
Déploiement et retour arrière
Section intitulée « Déploiement et retour arrière »Pour chaque nouveau modèle, testez les deux protocoles annoncés, la fin d’un streaming, l’épuisement du budget, un modèle refusé, des jetons révoqués et un basculement de source sans danger. Définissez les limites hebdomadaires à partir des valeurs suggérées et comparez la consommation dans Opfield avec la capacité ou la facturation du fournisseur.
Pour retirer un modèle, cessez d’accorder de nouveaux accès, identifiez les clients qui utilisent son identifiant public et fournissez un remplaçant testé. Si une source devient dangereuse ou indisponible, désactivez-la et vérifiez le routage des candidats avant de réactiver le modèle public. Ne faites pas pointer un identifiant public existant vers un modèle sensiblement différent simplement pour que les requêtes continuent de renvoyer 200.