

Bases de données et stockage sur plusieurs serveurs
En Business et Enterprise, une base PostgreSQL, un stockage clé-valeur, une base ClickHouse ou un stockage SeaweedFS managés peuvent s’exécuter sur 2 à 5 nœuds Storage, chacun sur son propre hôte. Un serveur est le primaire et reçoit toutes les lectures et écritures ; les autres sont des copies qui le suivent. Lorsque le primaire est perdu, une copie prend le relais. En production, exécutez aussi au moins deux relais sur des hôtes autres que l’hôte Opfield, dans des domaines de panne différents, afin que les liens vers la base ne dépendent pas de l’hôte Opfield ; voir Combien de relais.
Les liens, les liaisons et les outils propres à Opfield atteignent toujours le primaire. Les copies ne servent qu’au basculement et aux sauvegardes, pas aux lectures.
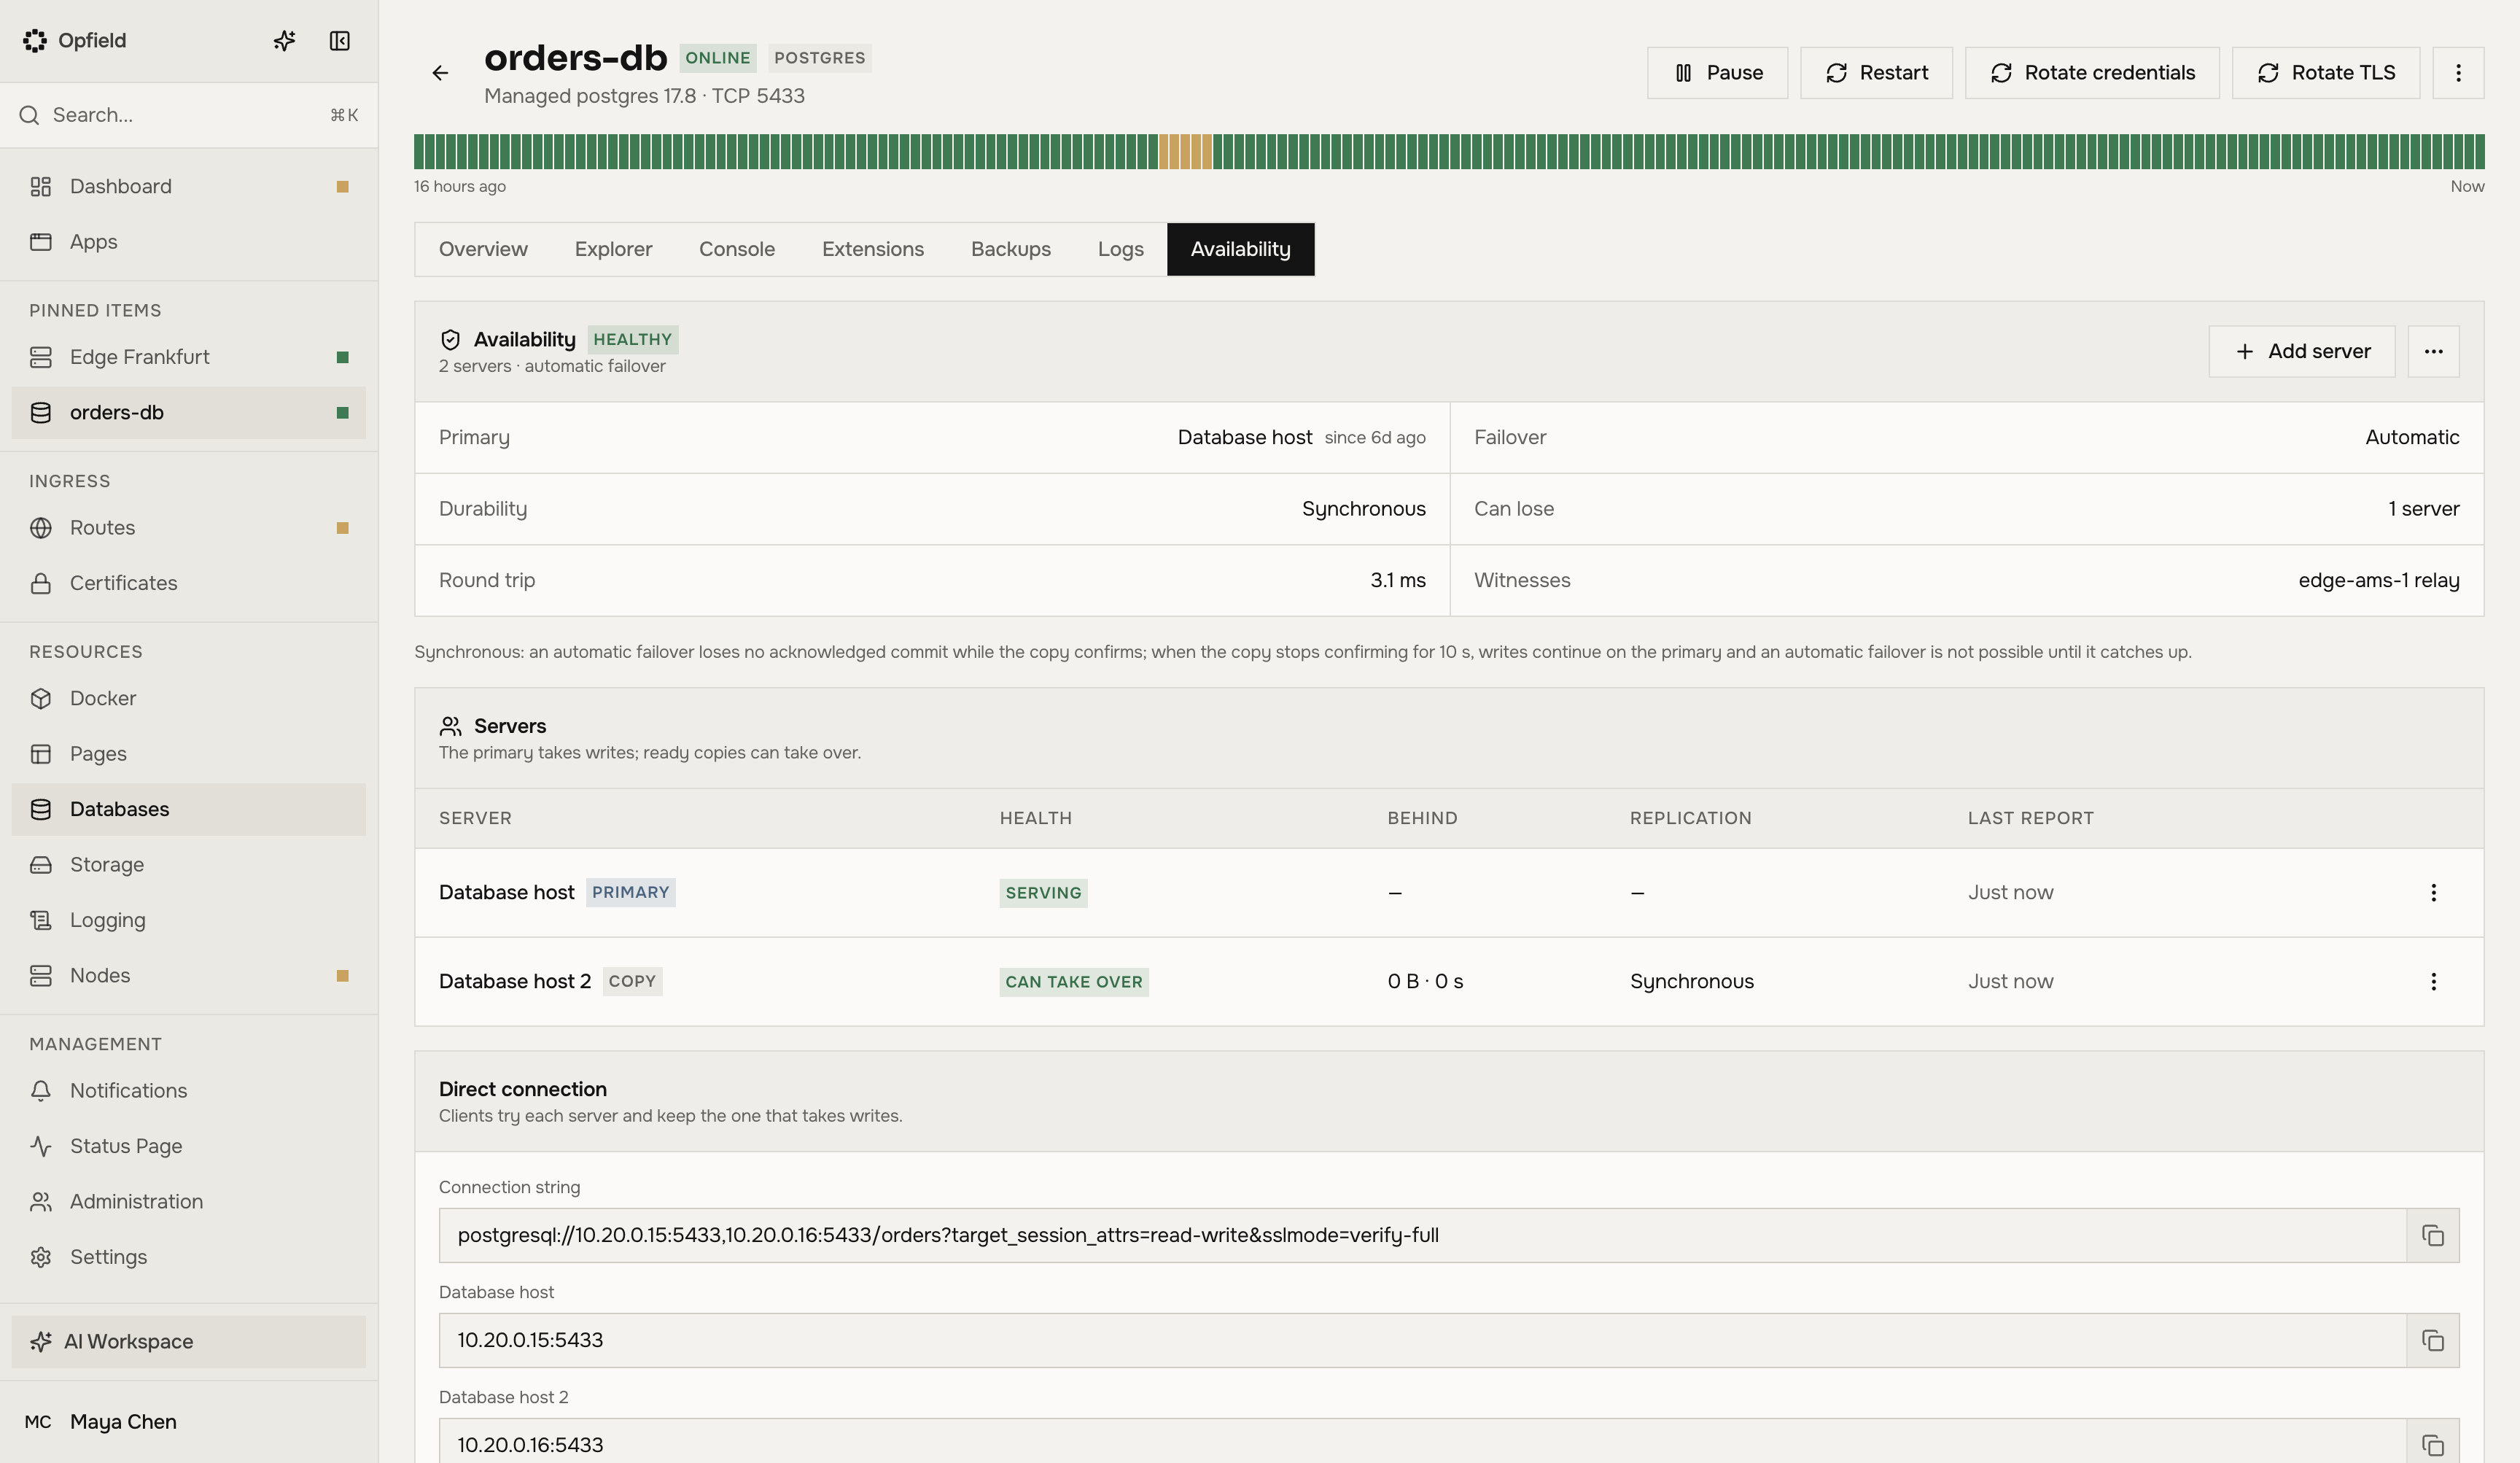
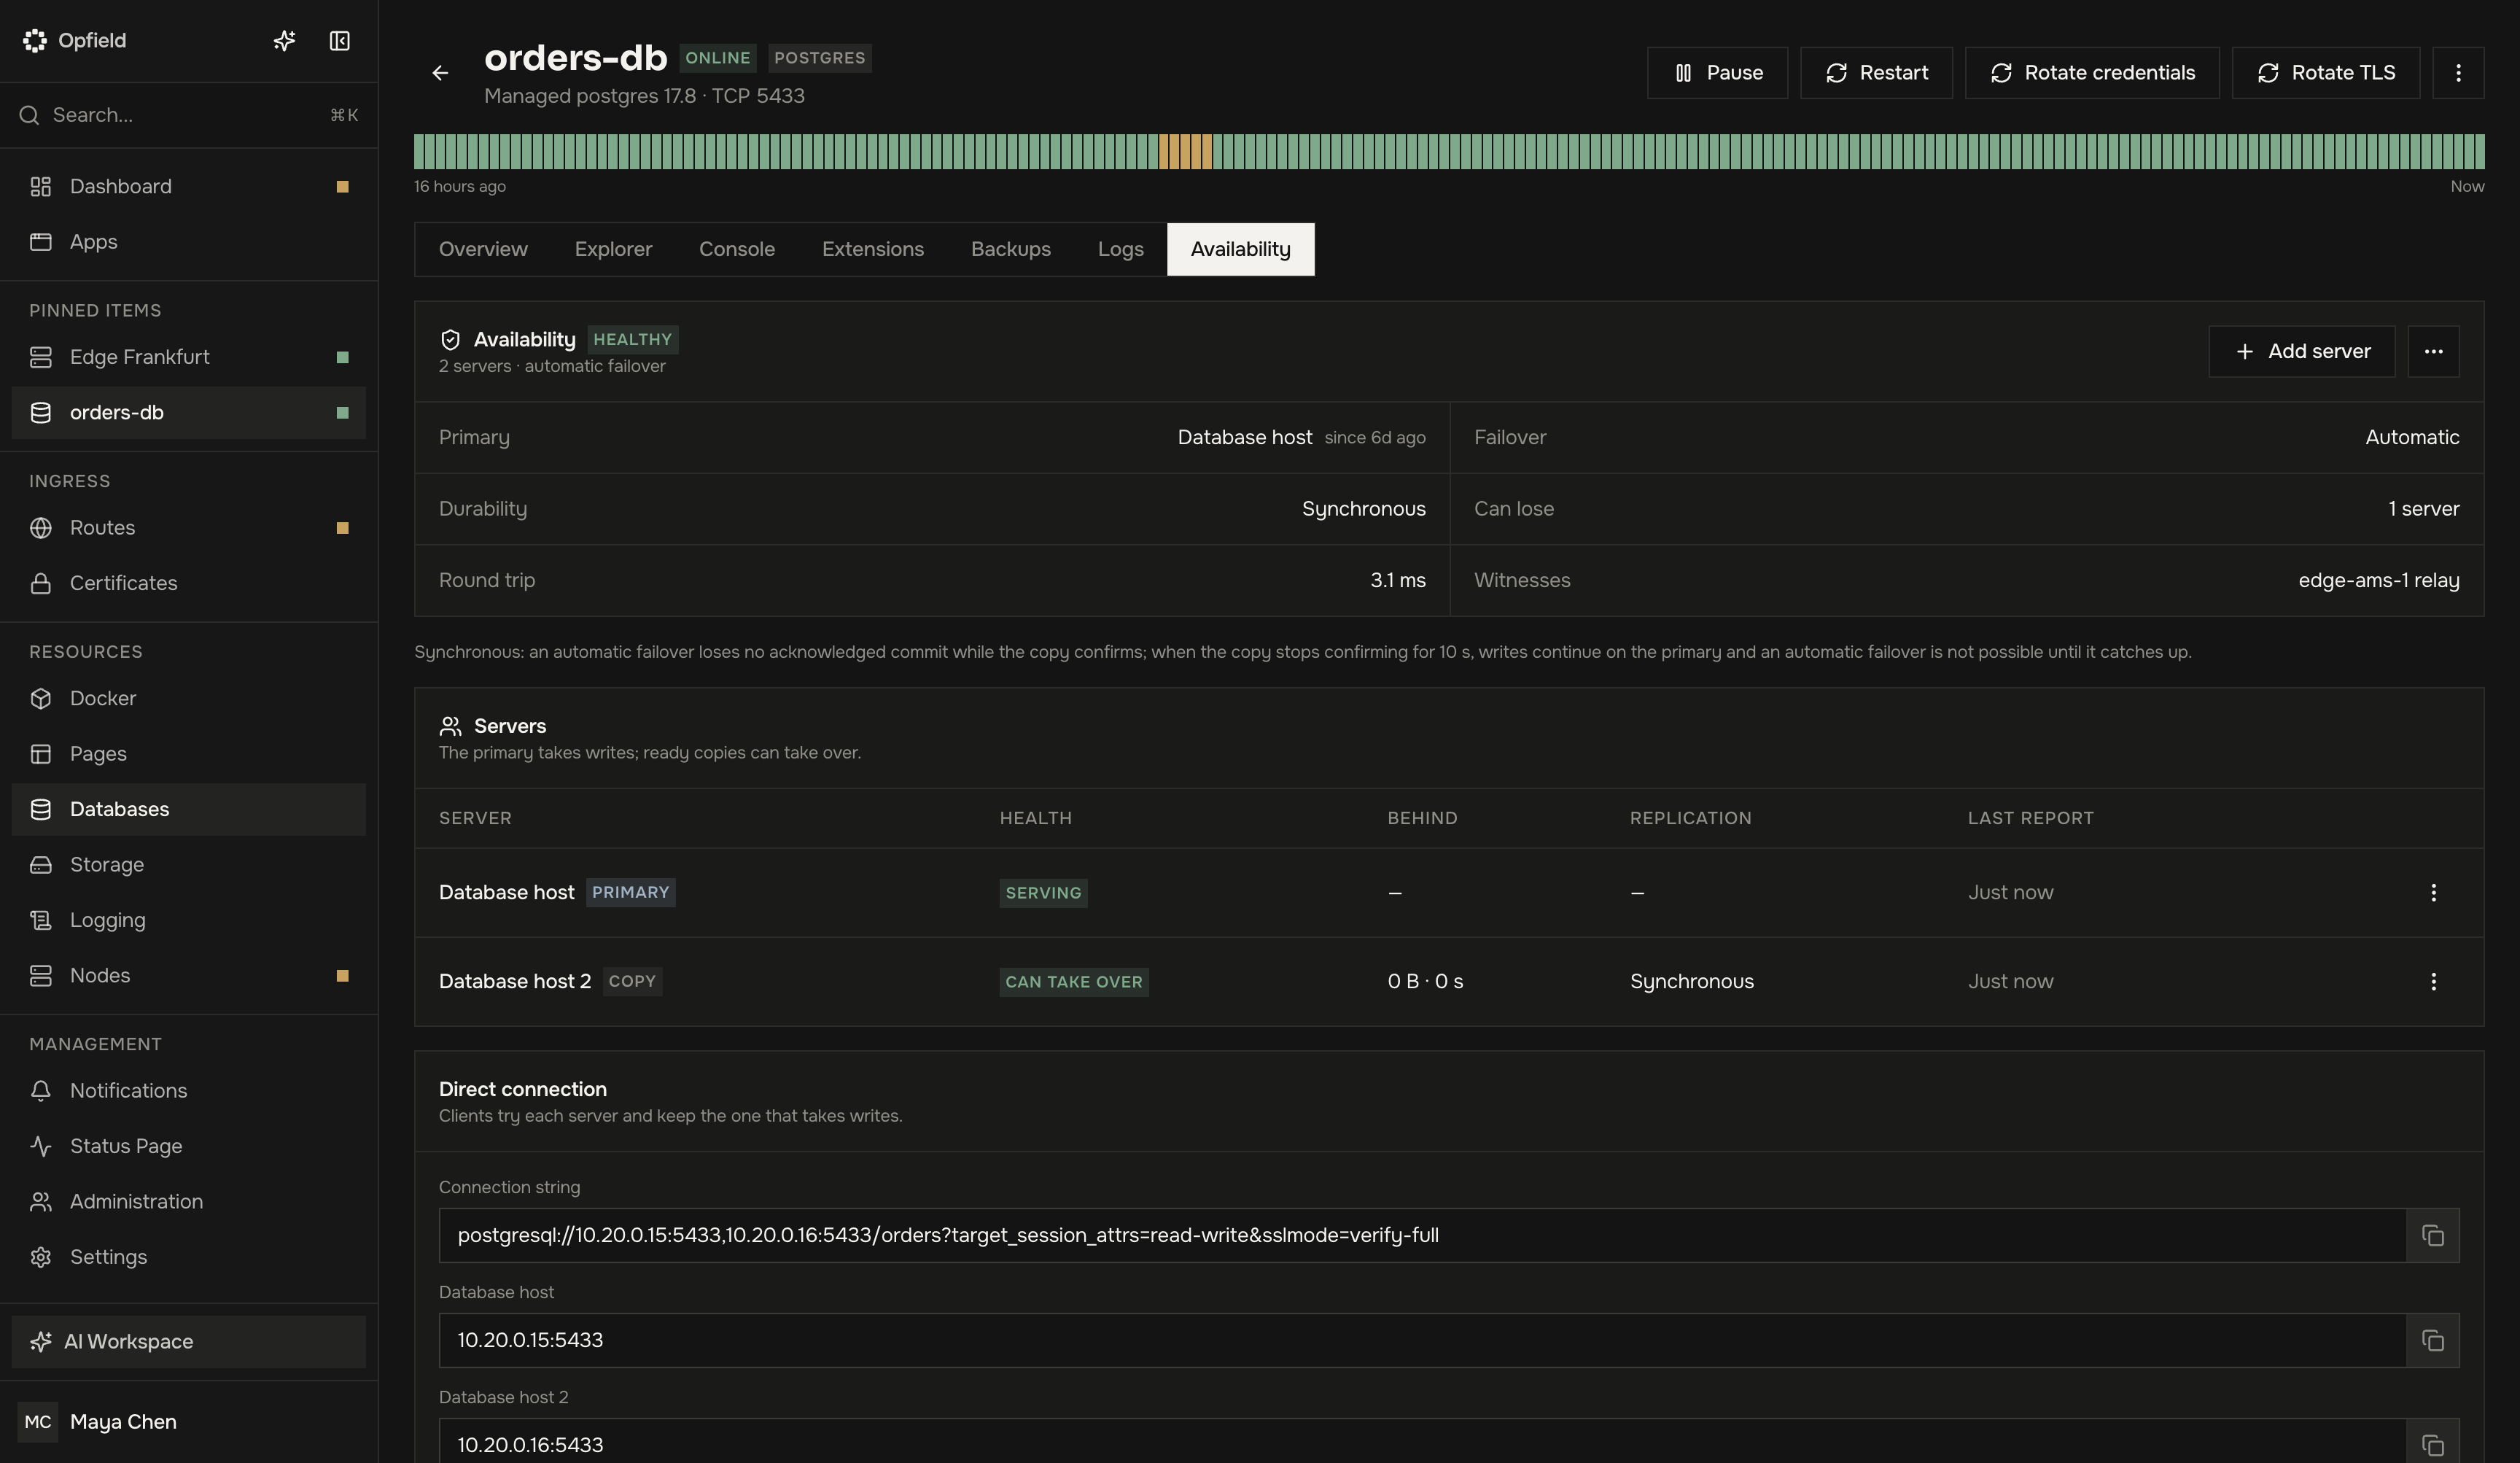
L’activer
Section intitulée « L’activer »- Pour une nouvelle ressource, utilisez Availability dans le formulaire de création.
- Pour une ressource existante, utilisez Make available… sur sa page.
Avant toute modification, la vérification préalable affiche le mode, les serveurs et les témoins, le temps d’aller-retour mesuré entre les serveurs, la durabilité et ce qu’un basculement peut faire perdre. L’activation sur une ressource existante la redémarre une fois ; elle conserve ses données et sert depuis son serveur pendant le remplissage des copies.
L’onglet Availability de la base ou du stockage affiche ensuite les serveurs avec leur rôle, leur santé et leur retard, les témoins, les paramètres et les événements.
Basculement automatique et témoins
Section intitulée « Basculement automatique et témoins »Le basculement automatique nécessite une majorité de votants sur des hôtes distincts. Les votants sont les serveurs de données plus des témoins. Un témoin vote pour désigner le serveur primaire et ne détient aucune donnée. Avec deux serveurs de données, Opfield ajoute un ou trois témoins ; un serveur de données, ou un serveur de données et un témoin, peuvent donc tomber en panne.
Un témoin s’exécute sur :
- un relais qu’un administrateur a autorisé à héberger des témoins, dans Settings → Relay, colonne Witnesses (
PATCH /api/system/relay/instances/{id}, MCPmanage_relay_poolset_witness_hosting) ; Opfield privilégie les relais autorisés ; - ou un nœud Docker sur un autre hôte.
Un relais protégé n’héberge des témoins qu’après autorisation de son propriétaire dans la configuration locale du relais ; d’ici là, Settings → Relay affiche « Protected relay: needs local opt-in ». Pour ClickHouse, les témoins sont des votants ClickHouse Keeper qui ne détiennent aucune donnée.
Deux serveurs sans témoin : basculement manuel
Section intitulée « Deux serveurs sans témoin : basculement manuel »Lorsqu’il n’existe pas de troisième hôte pour un témoin, deux serveurs forment une paire répliquée avec basculement manuel : la copie suit le primaire, mais rien ne bascule de soi-même. Lorsque le primaire est perdu, basculez sur la copie avec Make this copy primary.
Pour garantir que deux primaires ne reçoivent jamais d’écritures, un primaire cesse d’accepter des écritures lorsqu’il ne peut joindre ni Opfield ni sa copie pendant 30 secondes.
Lorsqu’Opfield est en panne
Section intitulée « Lorsqu’Opfield est en panne »Le basculement fonctionne sans Opfield. Les serveurs et les relais décident entre eux quel serveur est primaire, tant que la politique signée des relais est valide : le bail de politique des relais, de 72 heures par défaut, que la vérification préalable propose de porter à 7 jours (Settings → Relay, Policy lease). Voir Les relais sans Opfield.
Ce qui s’est passé entre-temps parvient à Opfield à son retour, avec l’heure à laquelle cela s’est produit, dans le journal d’audit et dans les alertes. Les sauvegardes attendent Opfield, car c’est Opfield qui les planifie. Une paire répliquée sans témoins ne peut toujours être basculée que via Opfield.
Ce qu’un basculement peut faire perdre
Section intitulée « Ce qu’un basculement peut faire perdre »« Acquitté » signifie que le client a reçu une confirmation de succès.
| Moteur et état | Ce qu’un basculement non planifié peut faire perdre |
|---|---|
| PostgreSQL, synchrone, sain | Rien d’acquitté. Un commit dont le client a cessé d’attendre la confirmation peut être perdu si le primaire meurt dans les 5 secondes environ ; Opfield l’enregistre. |
| PostgreSQL, synchrone, copie en retard | Aucun basculement automatique. Une copie qui cesse de confirmer pendant 10 secondes est retirée de la réplication synchrone et les écritures continuent ; un basculement manuel fait alors perdre les écritures effectuées depuis, et Opfield indique l’heure et une estimation. |
| PostgreSQL, asynchrone | Jusqu’à la limite de retard (1 Mio par défaut) plus environ 1 seconde d’écritures. Une copie plus en retard ne peut pas prendre le relais. |
| Stockage clé-valeur (toujours asynchrone) | Jusqu’à la limite de retard (1 Mio par défaut, généralement moins d’une seconde). |
| Objets SeaweedFS | Rien tant que les deux copies sont accessibles en écriture : chaque écriture est acquittée une fois stockée sur les deux serveurs. Tant qu’un serveur est en panne depuis plus de 10 secondes, les nouveaux objets ne sont stockés qu’une fois jusqu’à son retour, et ne sont perdus que si le disque du serveur restant est perdu. |
| Métadonnées des objets et des buckets SeaweedFS | Jusqu’à environ 1 seconde de modifications. |
| ClickHouse, serveurs proches | Rien d’acquitté tant que l’état est sain. |
| ClickHouse, serveurs éloignés ou dégradés | Les insertions que la copie n’avait pas encore récupérées ; elles reviennent lorsque l’ancien serveur revient avec son disque. |
Durabilité
Section intitulée « Durabilité »La durabilité est synchrone par défaut lorsque les serveurs sont proches (aller-retour jusqu’à 10 ms) : un commit ne revient qu’une fois que la copie le détient. Elle est asynchrone lorsqu’ils sont éloignés : un commit revient immédiatement, et un basculement peut faire perdre les écritures les plus récentes. Modifiez-la dans l’onglet Availability. Une durabilité synchrone sur des serveurs éloignés fait attendre l’aller-retour à chaque commit.
Opfield mesure le temps d’aller-retour toutes les 10 minutes et déclenche une alerte lorsqu’un ensemble synchrone est devenu trop éloigné, sans modifier sa durabilité.
Basculer à la main
Section intitulée « Basculer à la main »Make this copy primary est un basculement planifié sans perte lorsque le primaire sert et que la copie est à jour. Lorsque le primaire a disparu ou que la copie est en retard, le basculement peut faire perdre des écritures récentes : la boîte de dialogue affiche l’estimation et vous demande de la confirmer (API et MCP : acceptDataLoss: true). L’ancien primaire revient en tant que copie.
Connexion des clients
Section intitulée « Connexion des clients »Les liens et les liaisons suivent d’eux-mêmes le primaire. Pour les connexions directes à une ressource publiée, utilisez la chaîne de connexion indiquée sur la page de la ressource : elle nomme chaque serveur, et un client qui essaie chacun d’eux conserve celui qui accepte les écritures. Une copie refuse les connexions des clients.
Opérations courantes
Section intitulée « Opérations courantes »Lorsqu’une ressource s’exécute sur plusieurs serveurs, ses actions habituelles couvrent chaque serveur :
- La modification des paramètres ou de la version et le redémarrage s’effectuent un serveur à la fois, les copies en premier. Lorsque le primaire doit redémarrer, il passe d’abord la main sans perte à une copie mise à jour ; la ressource continue donc de servir.
- La mise en pause, y compris lorsque l’app à laquelle elle appartient est arrêtée, arrête d’abord les copies puis le primaire, qui conserve son rôle ; rien ne bascule donc. La reprise démarre d’abord le primaire.
- Avant la mise à jour du démon d’un nœud, un primaire situé sur ce nœud passe la main à une copie saine.
- Les sauvegardes lisent depuis une copie à jour lorsqu’il en existe une, sinon depuis le primaire.
- Une copie peut être reconstruite : ses données sont recopiées depuis le primaire, et elle ne peut pas prendre le relais tant que ce n’est pas terminé. Des serveurs peuvent être ajoutés et retirés ; un ensemble conserve au moins deux serveurs.
- Activer ou désactiver TLS sur une base de données est refusé tant qu’Availability est activée.
- Turn off availability conserve le primaire comme serveur unique et retire les copies. La suppression de la ressource désactive d’abord Availability.
Alertes et avis
Section intitulée « Alertes et avis »Les catégories d’alertes des bases de données et Managed storage proposent des événements pour le basculement, la bascule manuelle, l’état dégradé, l’absence de basculement automatique, le rétablissement, un serveur qui ne signale plus rien, une copie qui n’est plus synchrone, des serveurs désormais éloignés, un témoin perdu ou déplacé, ainsi que la réintégration et la reconstruction, et des métriques pour le retard de réplication (en octets et en secondes) et le temps d’aller-retour. L’onglet Availability liste les mêmes événements. Le tableau de bord affiche un avis tant qu’un ensemble ne peut pas basculer, tant que le primaire d’une paire répliquée ne signale rien, tant qu’un témoin est perdu, tant qu’un ensemble est dégradé, et pendant une journée après un basculement.
Plan et licence
Section intitulée « Plan et licence »L’exécution sur plusieurs serveurs est une fonctionnalité de Business et Enterprise, y compris les paires répliquées avec basculement manuel. Après la période de grâce de la licence, tout ce qui s’exécute continue de s’exécuter : basculement, isolation (fencing), réintégration des copies, Make this copy primary, reconstruction d’une copie, retrait d’un serveur, désactivation d’Availability et déplacements de témoins. L’activation, l’ajout d’un serveur et la modification des paramètres sont refusés jusqu’au renouvellement de la licence. Voir Plans et droits.
API et MCP
Section intitulée « API et MCP »REST : /api/databases/managed/{id}/availability et /api/managed-storage/{id}/availability (vérification préalable, activation, paramètres, membres, promotion en primaire, reconstruction, événements, désactivation). Le scope de modification de la ressource (databases:edit ou storage:edit) est nécessaire pour les modifications, son scope de consultation pour les lectures. MCP : les actions d’availability de manage_managed_database et manage_managed_storage, et set_witness_hosting de manage_relay_pool.