

Visión general de la observabilidad
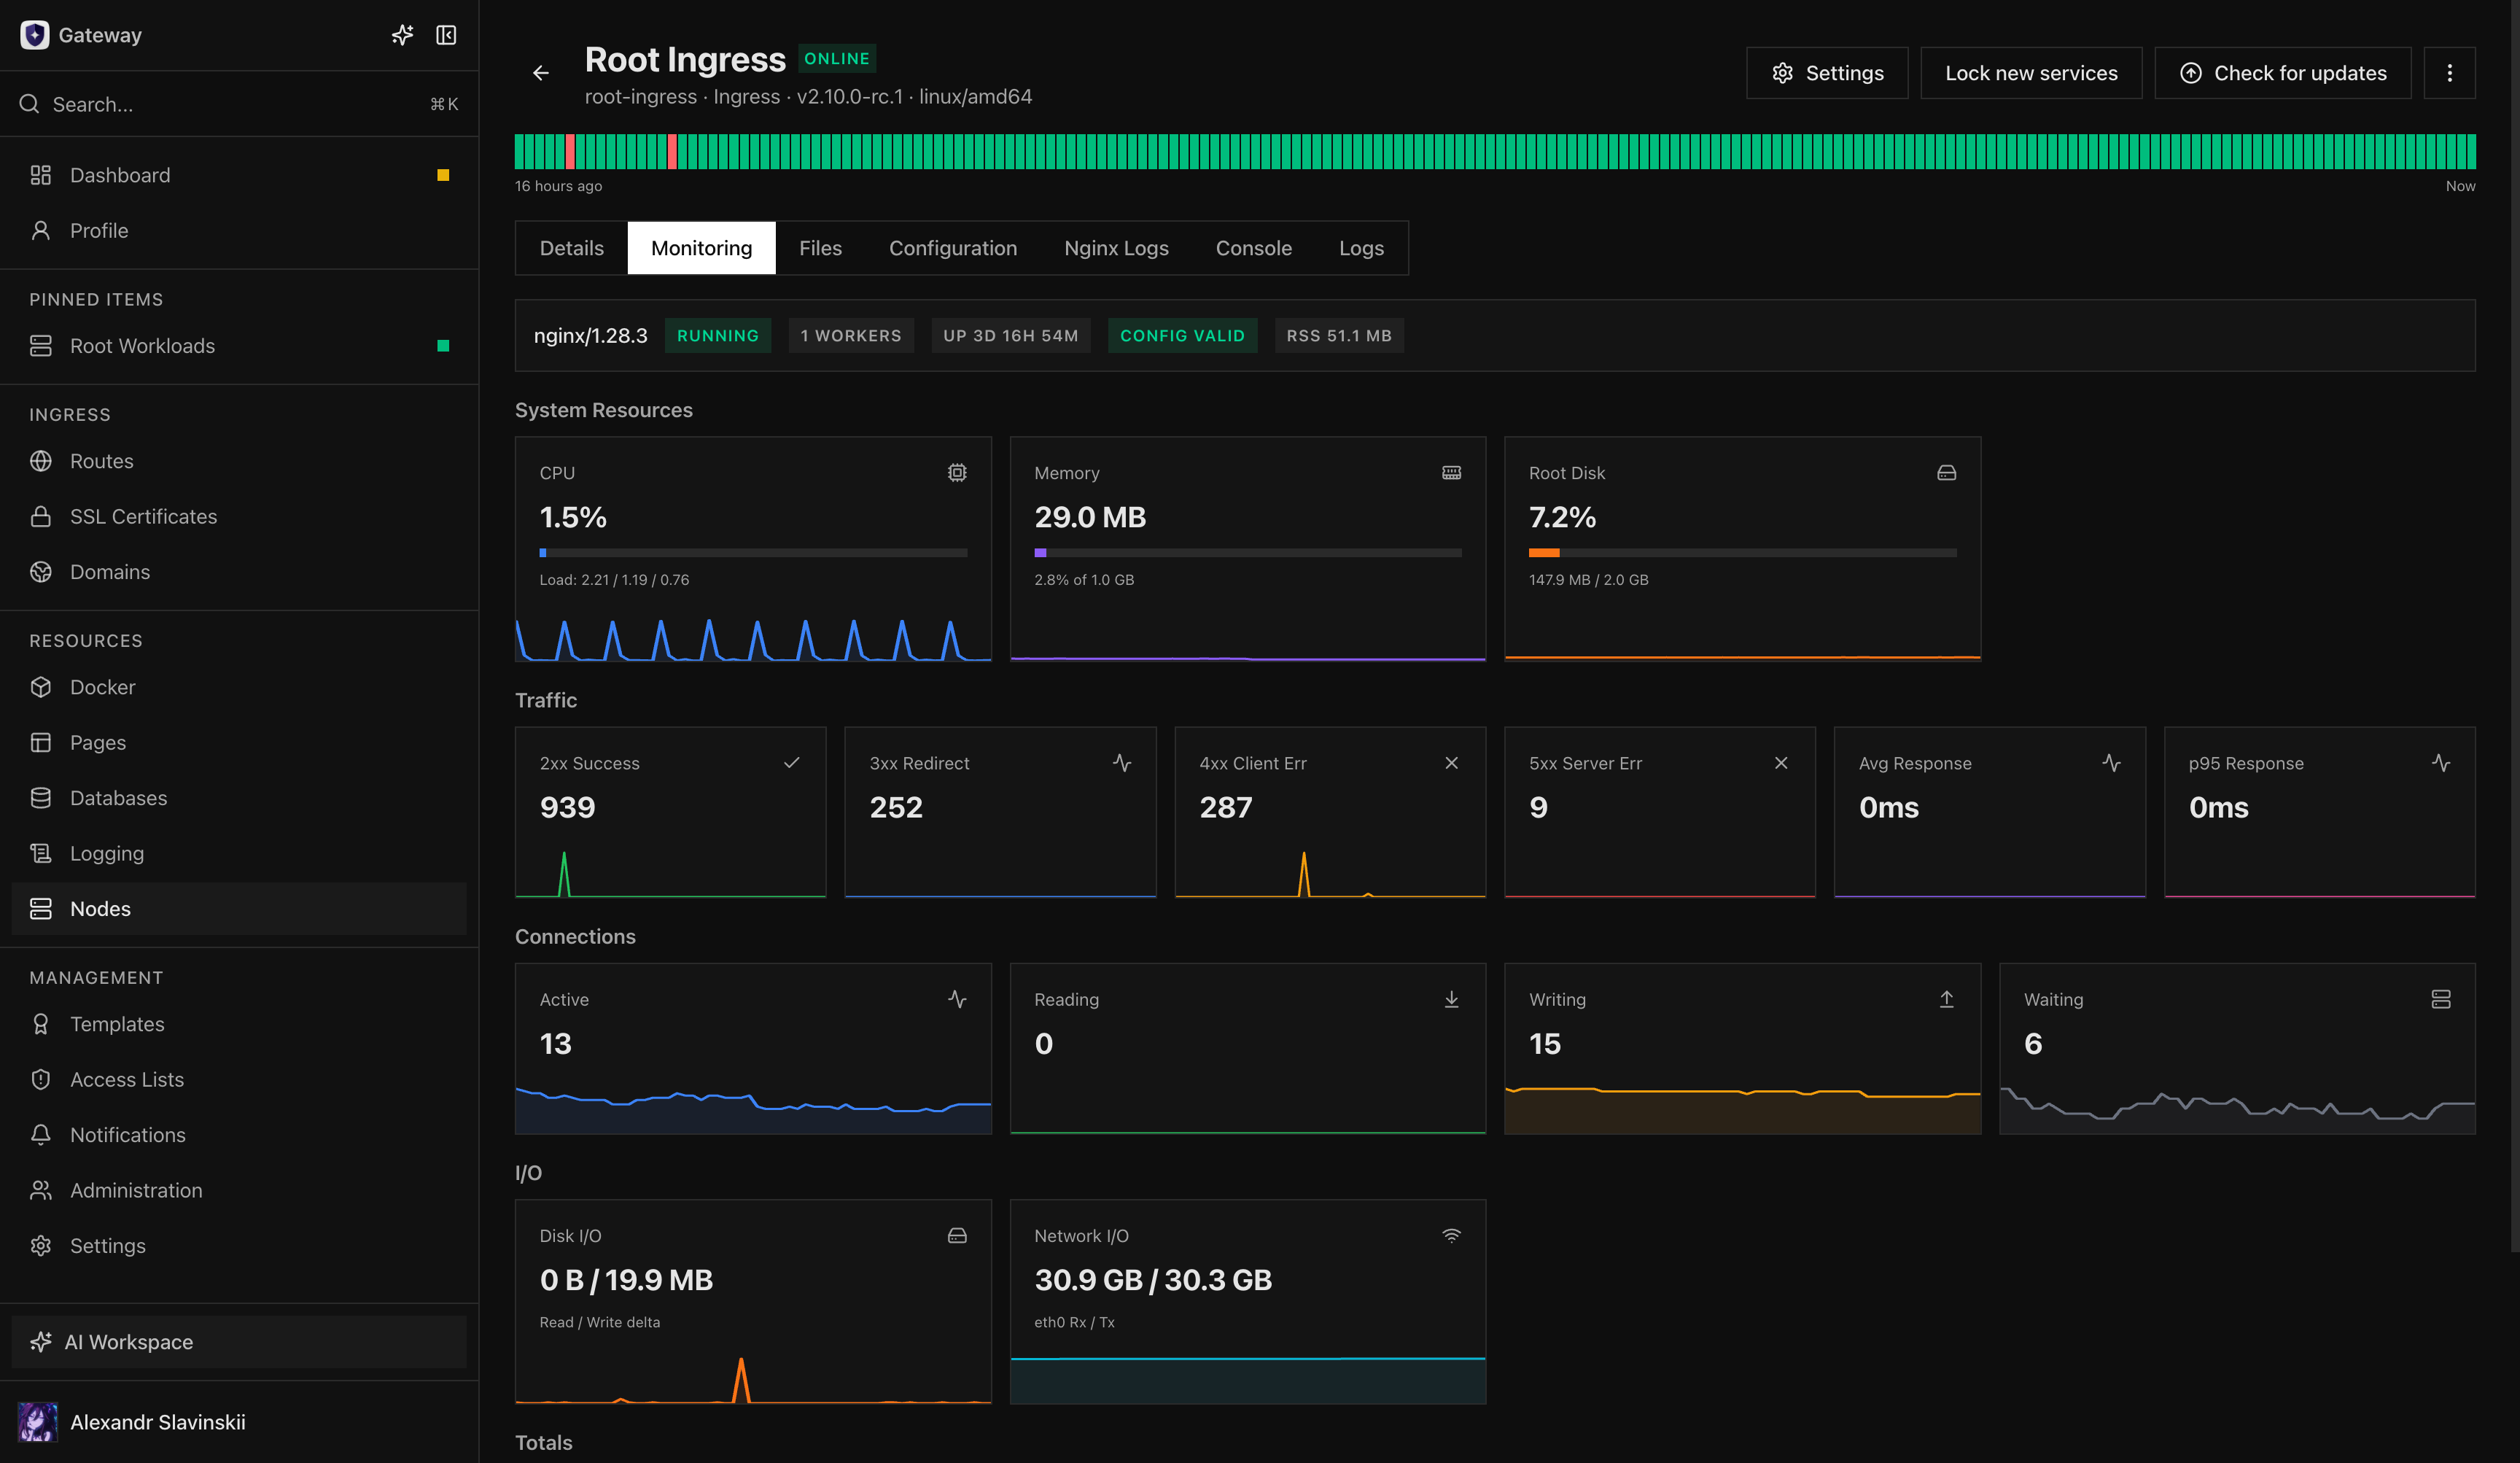
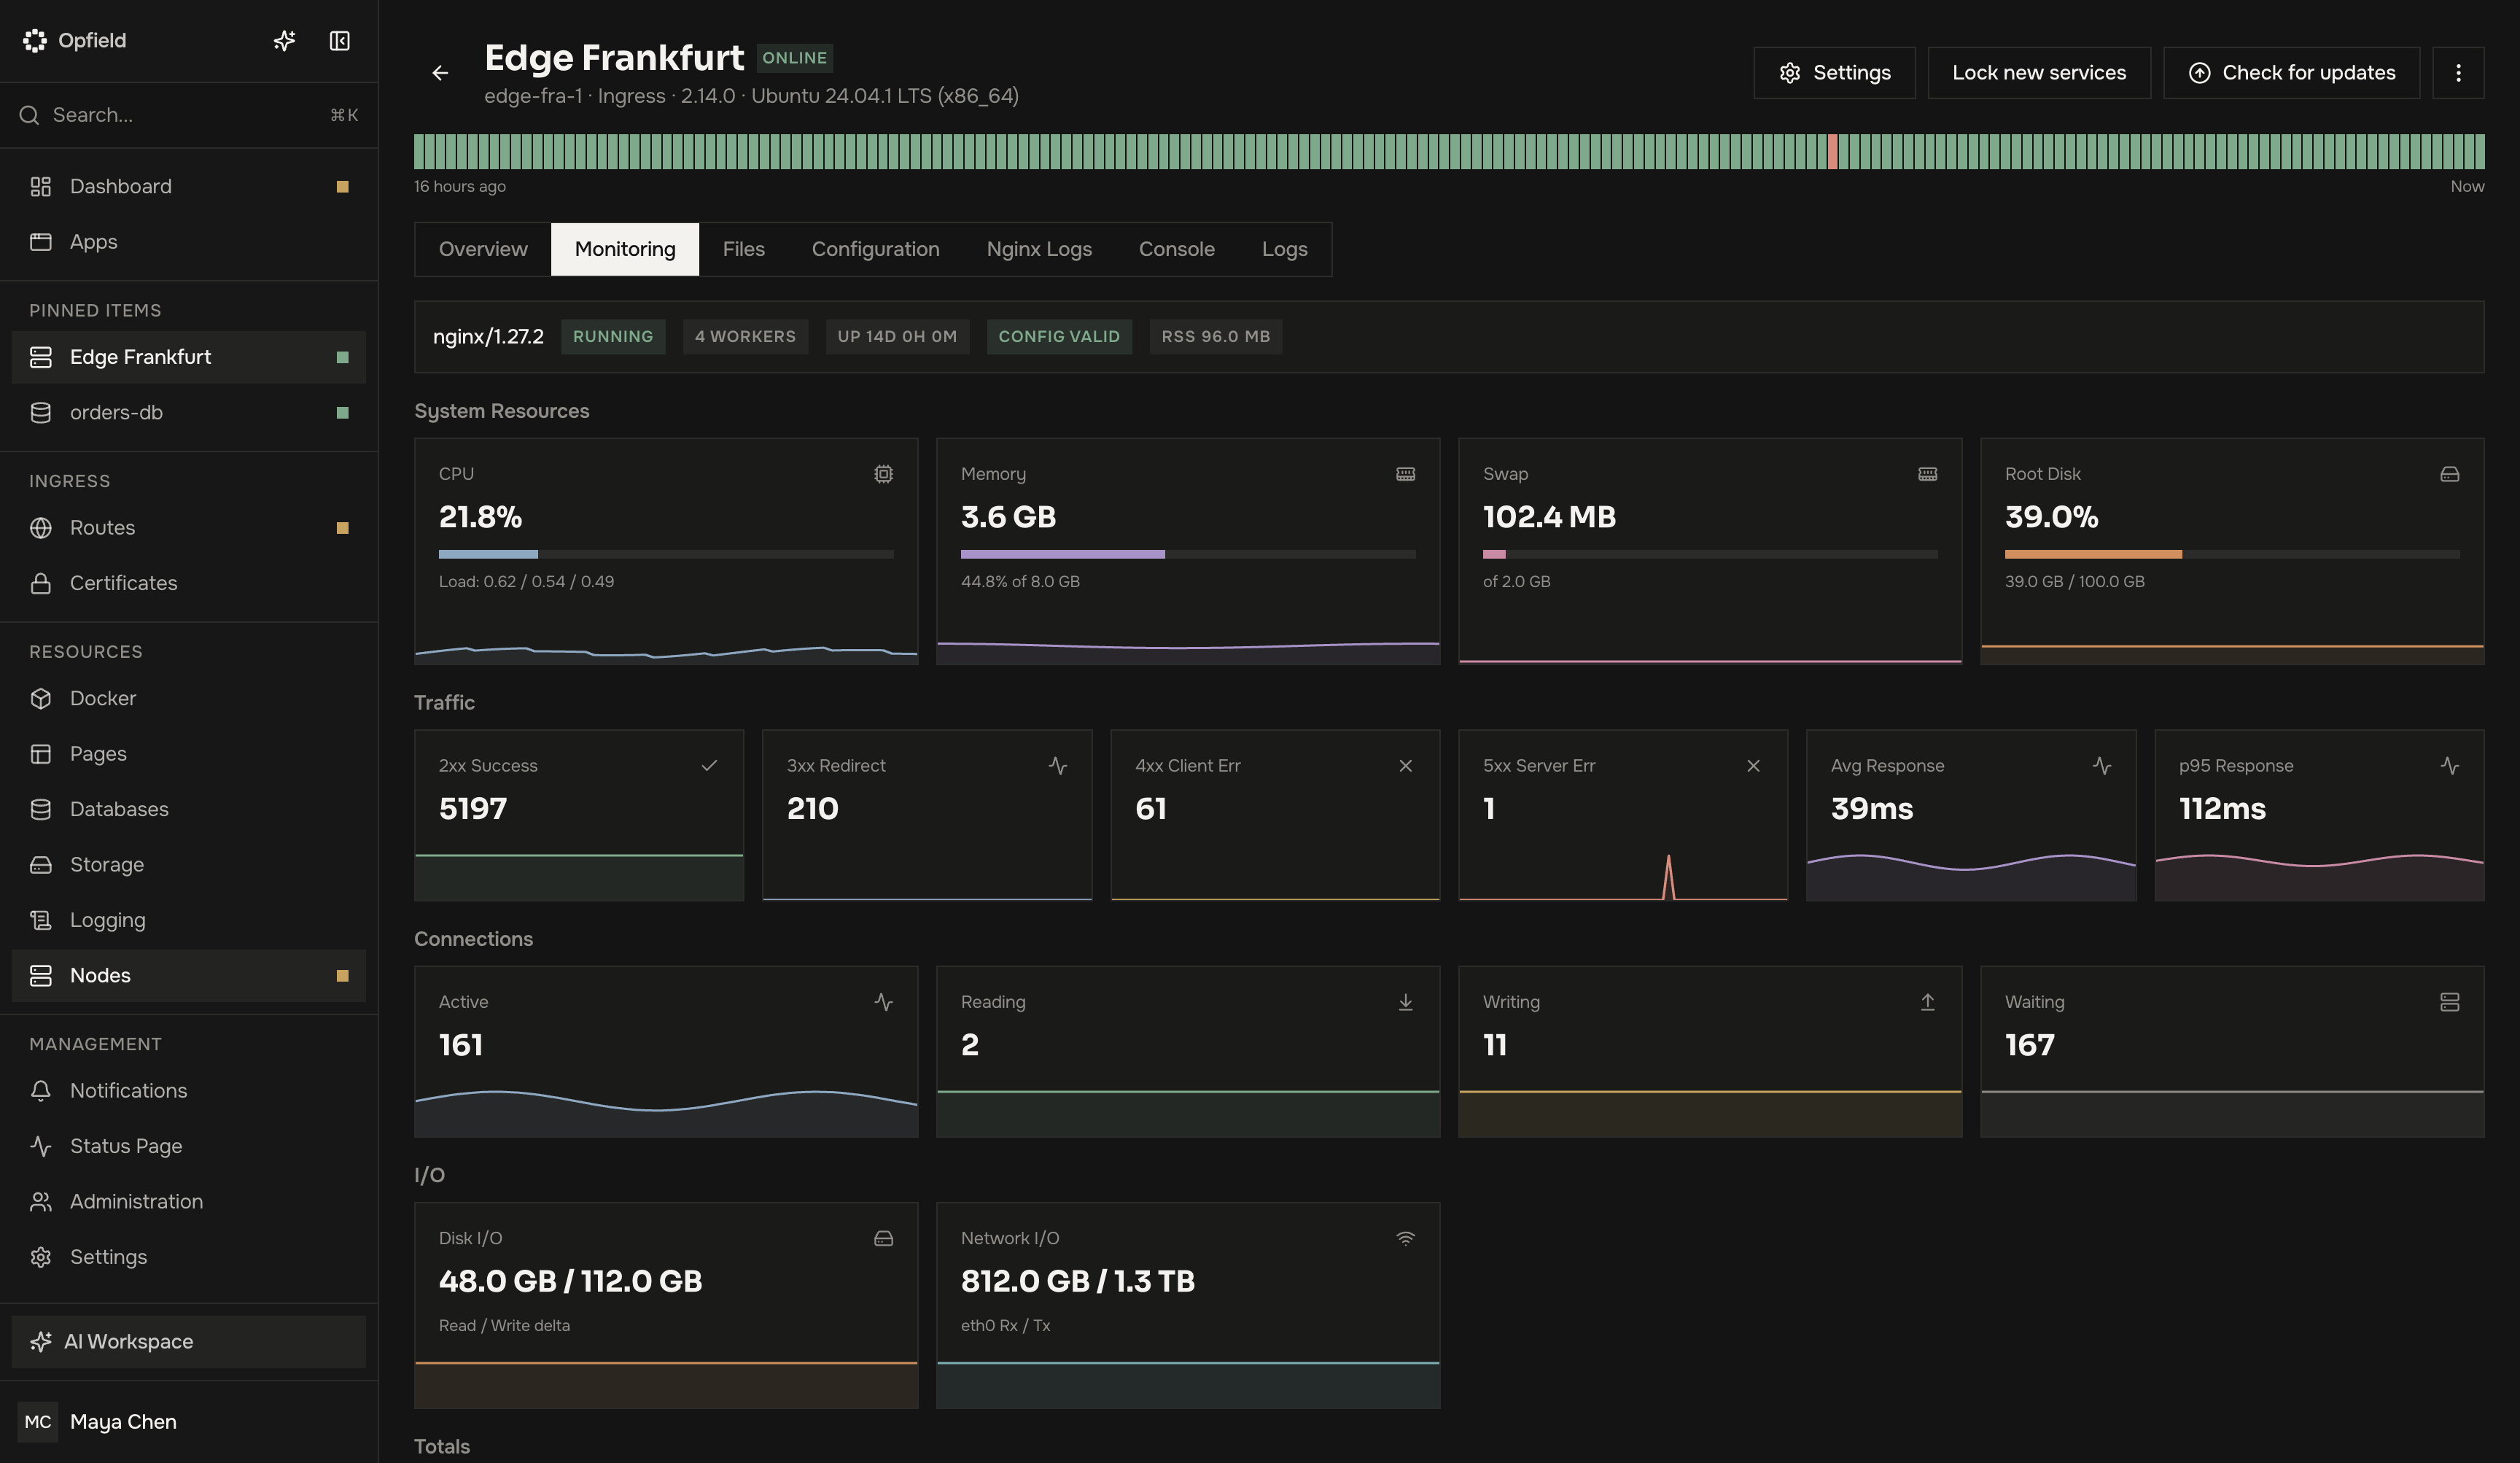
Opfield sustituye el stack de monitorización autoalojado. Las métricas de nodos y contenedores, los logs de contenedores y Routes, los logs estructurados de las aplicaciones, las reglas de alerta, las notificaciones y las páginas de estado públicas vienen integrados. No hay que desplegar Prometheus, Grafana, Loki ni Alertmanager, no hay paneles que construir ni un Statuspage o Uptime Kuma aparte que mantener sincronizado: cada métrica, cada log y cada componente de estado ya están ligados al recurso al que pertenecen.
Opfield vigila el estado del plano de control, el estado de los nodos y de las cargas de trabajo, el tráfico entrante, el estado de las bases de datos, la actividad de los builds, el uso de la inferencia y los eventos de seguridad. Cada señal está en el Dashboard y en la página del recurso que describe: nodos, Routes, cargas de trabajo, bases de datos, builds, Tasks, notificaciones, auditoría y páginas de estado. Durante un incidente, las señales responden a tres preguntas: ¿están afectados los clientes?, ¿quién debe actuar? y ¿cómo se verifica la recuperación?
Opfield no tiene trazado distribuido. Cuando tu equipo de seguridad analiza los eventos de auditoría en su propio SIEM, Opfield los exporta allí; consulta Logging estructurado y SIEM.
Aspira a un conjunto pequeño de señales fiables con responsables con nombre, una retención útil y un camino probado desde la detección hasta la recuperación de cara a los clientes. Tú defines qué significa el éxito para el negocio: los objetivos de nivel de servicio (SLO), el escalado y las comprobaciones de las dependencias externas.
Usa el estado de los recursos para la situación inmediata, las métricas para las tendencias, los logs para el diagnóstico, los Tasks duraderos para el progreso de las operaciones, las notificaciones para actuar, las páginas de estado para comunicarte con los clientes, la auditoría para la atribución y el SIEM para el análisis de seguridad externo.
Diseña las alertas en torno a un impacto sostenido en los clientes y a transiciones de estado significativas. Evita duplicar cada evento de bajo nivel en un canal de notificaciones.
Define la propiedad y el éxito
Sección titulada «Define la propiedad y el éxito»Para cada servicio importante, nombra al responsable de negocio, al responsable técnico, el destino de guardia y al responsable de la comunicación con los clientes. Define qué significa disponible desde el punto de vista del usuario, no solo según la insignia de un proceso interno. Una Route puede estar en buen estado mientras su aplicación o su base de datos devuelven respuestas inservibles; un nodo puede estar en línea mientras un recorrido de los clientes está roto.
Usa un SLO (un objetivo de fiabilidad medible a lo largo del tiempo) para decidir qué condiciones merecen alertas y cuáles corresponden solo a paneles o informes. Registra en la propia alerta la comprobación de recuperación esperada. El éxito se alcanza cuando el recorrido del cliente vuelve a funcionar, la señal se ha recuperado y se ha retirado cualquier mitigación temporal.
Tipos de señales
Sección titulada «Tipos de señales»| Señal | Mejor uso | Error habitual |
|---|---|---|
| Estado | Preparación actual del servicio | Tomar una insignia verde como prueba de disponibilidad de principio a fin |
| Métricas | Capacidad y tendencias | Avisar ante cada pico breve |
| Logs | Diagnóstico detallado | Enviar secretos o payloads sin límite |
| Tasks | Progreso duradero de las operaciones | Suponer que un Task aceptado ya ha terminado |
| Eventos | Transiciones de estado de los recursos | Usar el volumen de eventos como métrica de estado |
| Auditoría | Quién cambió qué | Sustituir los logs operativos por registros de auditoría |
| Notificaciones | Acción del operador | Reenviar cada evento informativo |
| Páginas de estado | Comunicación con los clientes | Publicar la topología privada o errores en bruto |
Construye una vista operativa
Sección titulada «Construye una vista operativa»- Empieza por las Routes de cara a los clientes y los servicios de negocio.
- Asocia cada servicio a su tráfico entrante, su carga de trabajo, su base de datos, su almacenamiento y sus dependencias externas.
- Define la señal de estado y el SLO que representan el impacto en los clientes.
- Añade alertas de capacidad de los recursos con ventanas sostenidas.
- Dirige los eventos urgentes a un destino de notificación con responsable.
- Crea un componente de estado público solo para la información que deban ver los clientes.
- Prueba el fallo y la recuperación, no solo la entrega de notificaciones.
Flujo de diagnóstico
Sección titulada «Flujo de diagnóstico»Usa el Dashboard para el triaje y abre después el recurso afectado. Compara el estado en vivo con las métricas, los Tasks, los eventos y los logs recientes. Correlaciona por ID de recurso estable, ID de operación, ID de petición y marca de tiempo. Si el estado mostrado se basa en una instantánea en caché, restablece la conexión del nodo propietario antes de modificar el recurso.
En la monitorización de bases de datos, la recopilación empieza en segundo plano tras el arranque de Opfield y cuando una base de datos gestionada está lista; no hace falta abrir la página de la base de datos. La primera visita a la página puede esperar brevemente al historial o a la primera instantánea real, pero no debe fabricar un estado correcto a partir de datos ausentes.
Durante un incidente, empieza por el recorrido de los clientes afectado y avanza hacia dentro: DNS público y TLS, Route e Ingress, carga de trabajo, dependencias privadas, almacenamiento y servicios externos. Usa los Tasks para distinguir una operación aceptada de una terminada. Usa la auditoría para entender los cambios de configuración, no como sustituto de los logs de ejecución.
Diagnóstico de Opfield
Sección titulada «Diagnóstico de Opfield»Opfield también informa de su propio estado. El asistente de IA y los clientes MCP lo leen con manage_opfield_diagnostics:
snapshot: la CPU, la memoria, la carga y el disco del volumen de datos del host; la memoria, la CPU y el retraso del bucle de eventos del proceso del backend; la accesibilidad, la latencia, el pool de conexiones, el tamaño y las consultas largas de PostgreSQL y Redis; los contenedores del stack (app,postgres,redis,relay,registry) con su estado, su salud, sus reinicios, su CPU y su memoria; los trabajos en segundo plano que fallan; y la latencia y los 5xx de la API;history: muestras de un minuto conservadas durante 48 horas;requestsyjobs: recuentos, p95 y 5xx por ruta, y la última ejecución y los errores de cada trabajo en segundo plano;logs: los logs de los contenedores de la aplicación, PostgreSQL, Redis, Relay y el registro, y de la última ejecución de actualización de Opfield.
Leer el estado requiere diagnostics:view; leer los logs requiere diagnostics:logs, que lo incluye. Los grupos de administración integrados tienen ambos; los grupos personalizados necesitan que se les concedan. Las cifras de CPU cubren las CPU que Opfield puede usar realmente, con kernelCpuCount como el recuento del kernel. La memoria es el límite del cgroup del contenedor cuando hay uno (memoryScope: "cgroup") y, si no, la vista del kernel ("kernel"), como dentro de un invitado LXC, cuyo propio límite no es visible desde el contenedor de la aplicación.
Las reglas de alerta de la categoría Opfield vigilan las mismas señales: CPU, memoria y disco del host, memoria del backend, retraso del bucle de eventos, la tasa de 5xx y la latencia p95 de la API, la latencia y las esperas del pool de PostgreSQL y la latencia de Redis. También se disparan cuando PostgreSQL o Redis no están disponibles, cuando un contenedor del stack está caído o en mal estado y cuando un trabajo en segundo plano sigue fallando. Una alerta de caída de PostgreSQL se envía directamente a los webhooks de sus reglas mientras PostgreSQL está caído y se registra cuando vuelve. /health comprueba PostgreSQL a través de una conexión propia, de modo que un pool de conexiones ocupado no se interpreta como una caída.
Verifica la propia observabilidad
Sección titulada «Verifica la propia observabilidad»Supervisa el camino de la monitorización: la actualidad de los datos de los nodos, el estado de ClickHouse, la entrega de la cola de notificaciones, la publicación de las páginas de estado, la antigüedad de la outbox de SIEM y la retención del almacenamiento. Un sistema de observabilidad que deja de recopilar en silencio debe generar una advertencia de plataforma aparte.
Conserva la telemetría el tiempo suficiente para reconstruir los incidentes, pero aplica presupuestos explícitos de retención y tamaño. No uses los logs como un archivo de datos sin control.
Detalles para operadores: señales desactualizadas y contradictorias
Sección titulada «Detalles para operadores: señales desactualizadas y contradictorias»Cada decisión sobre el estado tiene una marca de tiempo y un responsable. Si un nodo se desconecta, su última instantánea puede quedar desactualizada; restablece el nodo propietario antes de modificar recursos basándote en información antigua. Si la advertencia de la barra lateral y una página de detalle no coinciden, compara su origen, su marca de tiempo y su regla de agregación en lugar de suponer que cualquiera de los dos colores es el autoritativo.
Trata los datos que faltan como desconocidos, no como correctos. Verifica que la recopilación avanza, que la muestra más reciente avanza, que ClickHouse está disponible donde se esperan logs estructurados, que las colas de notificaciones se vacían y que se publican las actualizaciones de estado públicas. Tras la reparación, ejecuta la comprobación original de principio a fin y documenta cualquier punto ciego que haya retrasado la detección.