

Bases de datos y almacenamiento en varios servidores
En Business y Enterprise, una base de datos PostgreSQL gestionada, un almacén clave-valor, una base de datos ClickHouse o un almacenamiento SeaweedFS pueden ejecutarse en 2 a 5 nodos Storage, cada uno en su propio host. Un servidor es el primario y atiende todas las lecturas y escrituras; los demás son copias que lo siguen. Cuando se pierde el primario, una copia toma el relevo. En producción, ejecuta además al menos dos Relays en hosts distintos del host de Opfield, en dominios de fallo diferentes, para que los enlaces a la base de datos no dependan del host de Opfield; consulta Cuántos Relays.
Los enlaces, las vinculaciones y las herramientas propias de Opfield siempre llegan al primario. Las copias solo sirven para la conmutación por error y las copias de seguridad, no para lecturas.
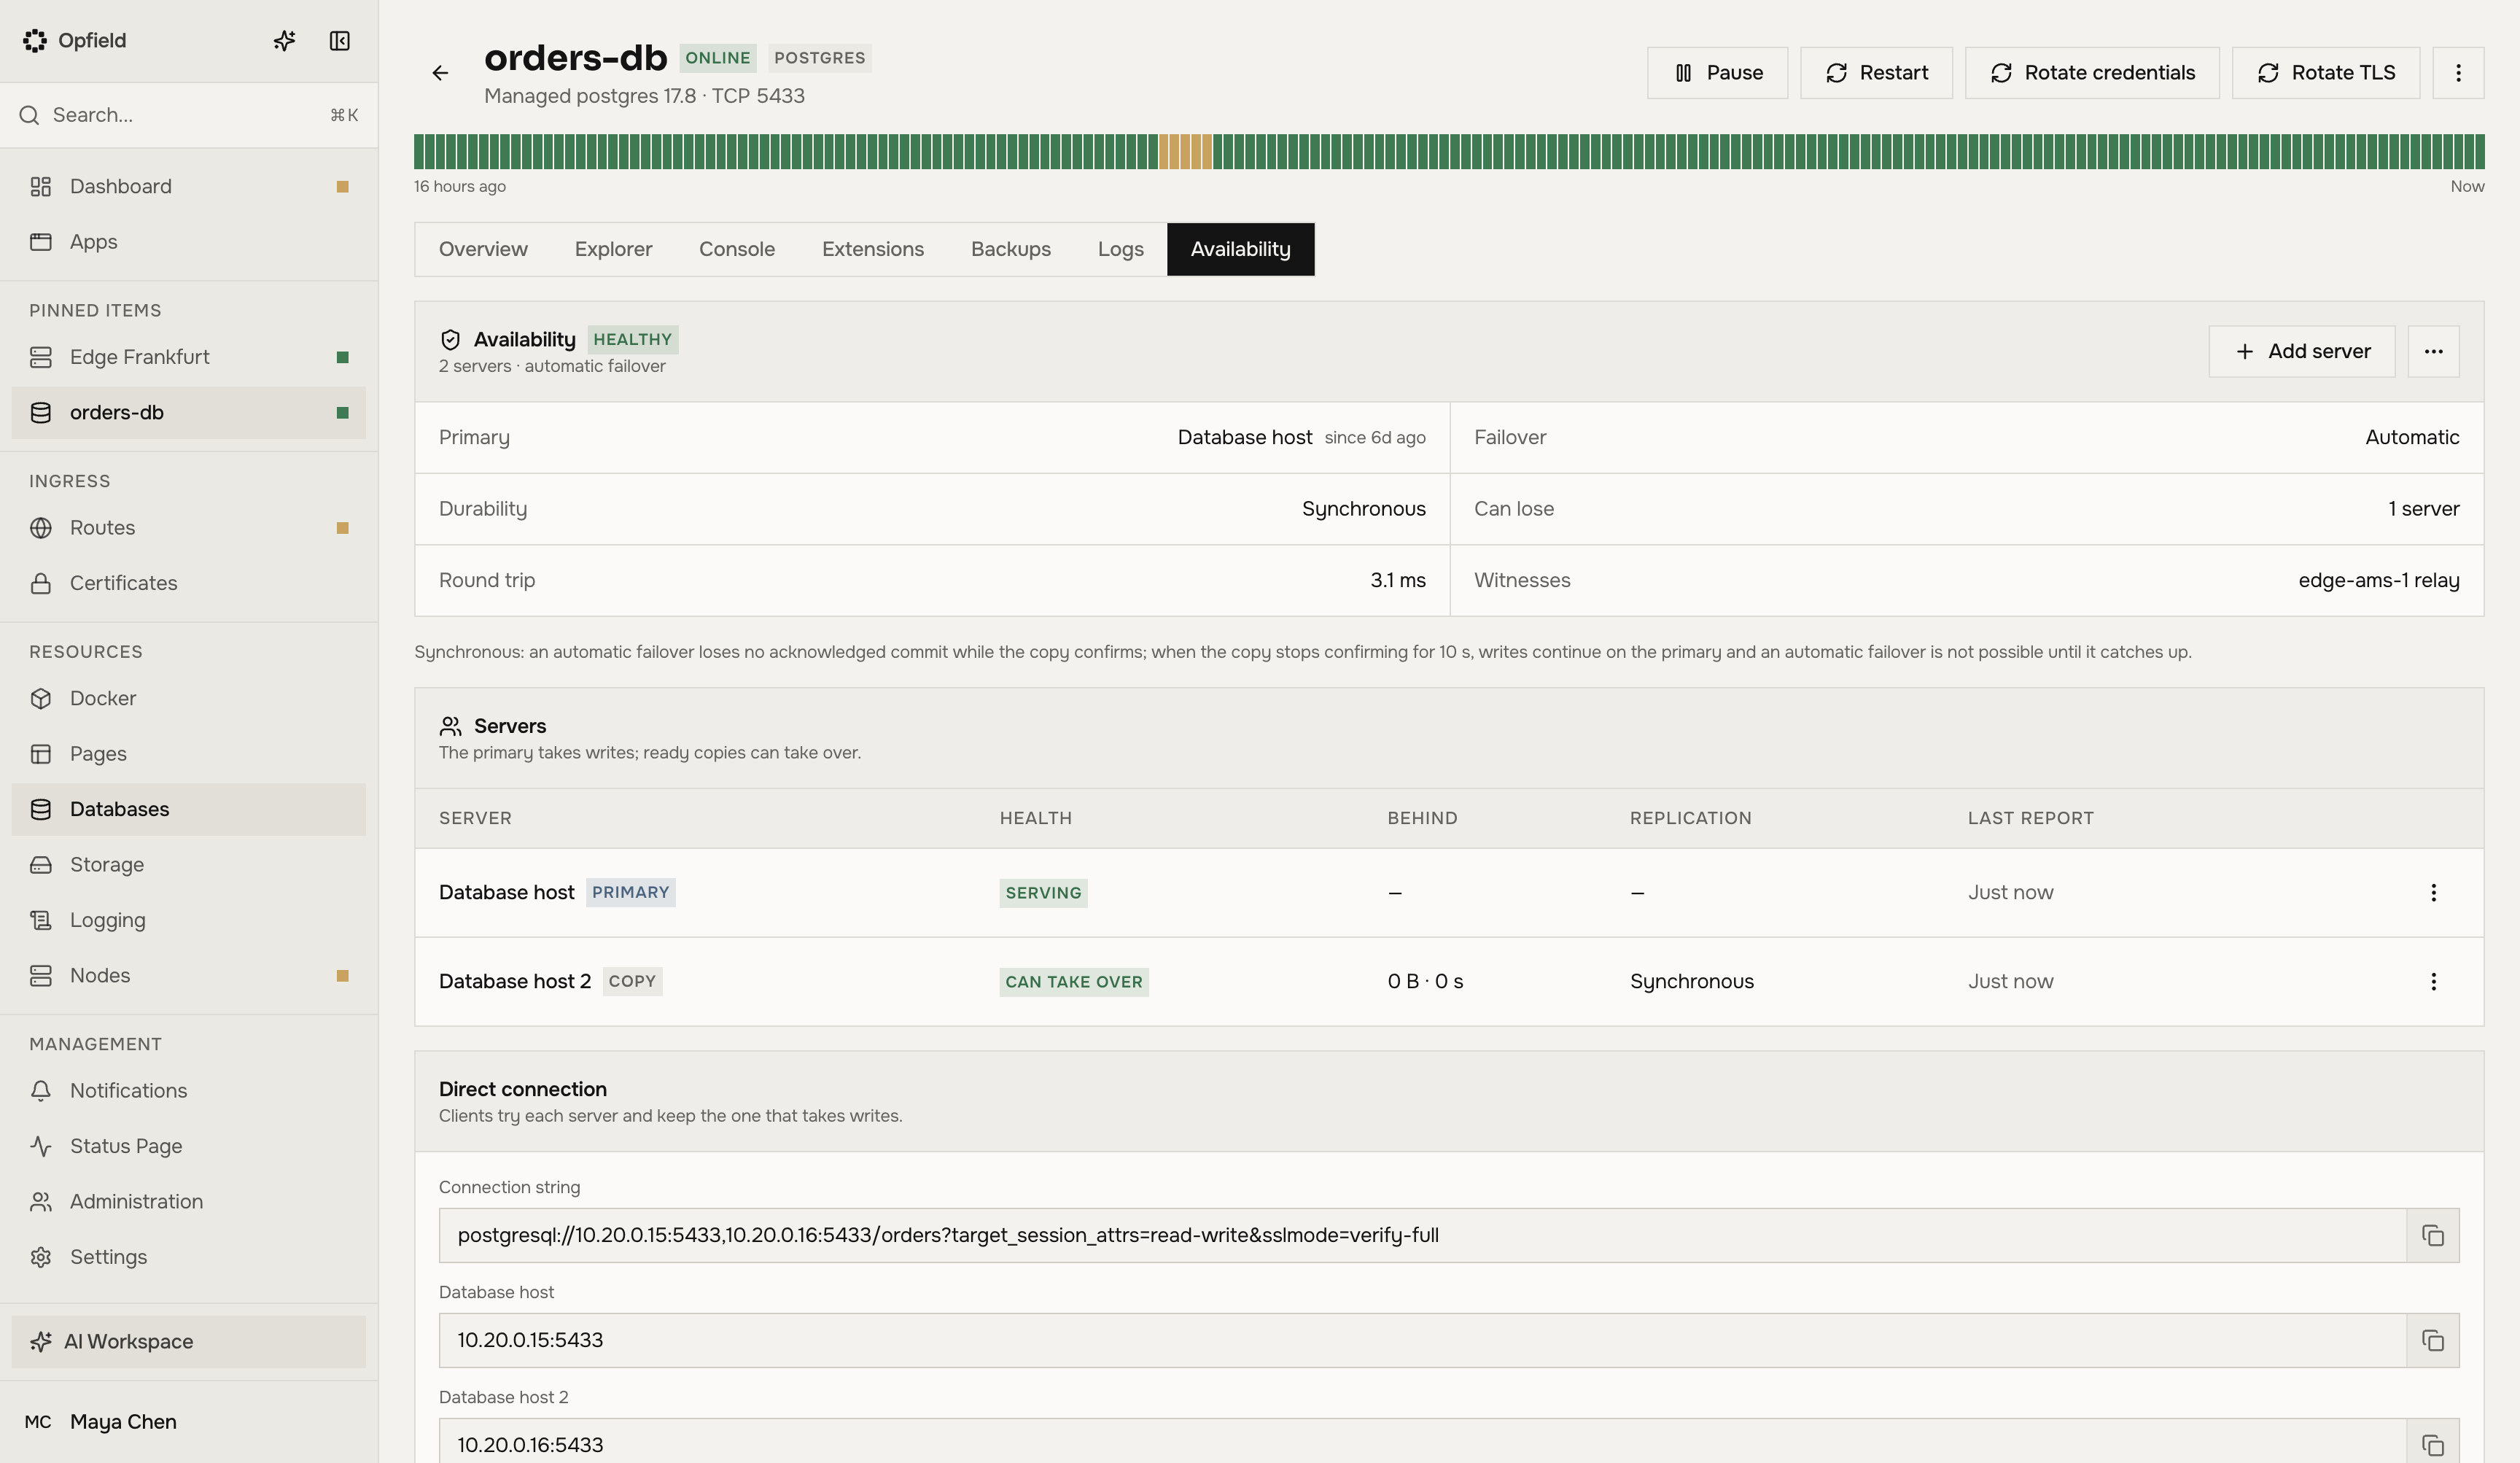
Actívalo
Sección titulada «Actívalo»- Para un recurso nuevo, usa Availability en el formulario de creación.
- Para uno existente, usa Make available… en su página.
Antes de que cambie nada, la comprobación previa muestra el modo, los servidores y los testigos, el tiempo de ida y vuelta medido entre los servidores, la durabilidad y lo que puede perder una conmutación por error. Activarlo en un recurso existente lo reinicia una vez; conserva sus datos y sigue sirviendo desde su servidor mientras se rellenan las copias.
La pestaña Availability de la base de datos o del almacenamiento muestra entonces los servidores con su rol, su estado y su retraso, los testigos, los ajustes y los eventos.
Conmutación por error automática y testigos
Sección titulada «Conmutación por error automática y testigos»La conmutación por error automática necesita una mayoría de votantes en hosts separados. Los votantes son los servidores de datos más los testigos. Un testigo vota qué servidor es el primario y no guarda datos. Con dos servidores de datos, Opfield añade uno o tres testigos, de modo que puede fallar un servidor de datos, o un servidor de datos y un testigo.
Un testigo se ejecuta en:
- un relay al que un administrador ha permitido alojar testigos, en Settings → Relay, columna Witnesses (
PATCH /api/system/relay/instances/{id}, MCPmanage_relay_poolset_witness_hosting); Opfield prefiere los relays permitidos; - o un nodo Docker en otro host.
Un relay protegido solo aloja testigos cuando su propietario lo ha permitido en la configuración local del relay; hasta entonces, Settings → Relay muestra “Protected relay: needs local opt-in”. Para ClickHouse, los testigos son votantes de ClickHouse Keeper que no guardan datos.
Dos servidores sin testigo: conmutación por error manual
Sección titulada «Dos servidores sin testigo: conmutación por error manual»Cuando no hay un tercer host para un testigo, dos servidores forman un par replicado con conmutación por error manual: la copia sigue al primario, pero nada cambia por sí solo. Cuando se pierde el primario, cambia a la copia con Make this copy primary.
Para garantizar que nunca haya dos primarios aceptando escrituras, un primario deja de aceptar escrituras cuando no puede llegar ni a Opfield ni a su copia durante 30 segundos.
Cuando Opfield está caído
Sección titulada «Cuando Opfield está caído»La conmutación por error funciona sin Opfield. Los servidores y los relays deciden entre sí qué servidor es el primario mientras la política firmada de los relays sea válida: el lease de la política de los relays, de 72 horas por defecto, que la comprobación previa ofrece ampliar a 7 días (Settings → Relay, Policy lease). Consulta Relays sin Opfield.
Lo que ocurrió entretanto llega a Opfield cuando vuelve, con la hora en que ocurrió, en el registro de auditoría y en las alertas. Las copias de seguridad esperan a Opfield, porque es Opfield quien las programa. Un par replicado sin testigos solo se puede cambiar a través de Opfield.
Lo que puede perder una conmutación por error
Sección titulada «Lo que puede perder una conmutación por error»“Confirmado” significa que el cliente recibió una respuesta de éxito.
| Motor y estado | Lo que puede perder una conmutación por error no planificada |
|---|---|
| PostgreSQL, síncrono, en buen estado | Nada confirmado. Un commit cuyo cliente dejó de esperarlo puede perderse si el primario cae en unos 5 segundos; Opfield lo registra. |
| PostgreSQL, síncrono, copia retrasada | Ninguna conmutación por error automática. Una copia que deja de confirmar durante 10 segundos se saca de la replicación síncrona y las escrituras continúan; un cambio manual pierde entonces las escrituras desde ese momento, y Opfield muestra la hora y una estimación. |
| PostgreSQL, asíncrono | Hasta el límite de retraso (1 MiB por defecto) más aproximadamente 1 segundo de escrituras. Una copia más retrasada no puede tomar el relevo. |
| Almacén clave-valor (siempre asíncrono) | Hasta el límite de retraso (1 MiB por defecto, normalmente menos de 1 segundo). |
| Objetos de SeaweedFS | Nada mientras ambas copias admiten escritura: cada escritura se confirma cuando ambos servidores la han guardado. Mientras un servidor está caído más de 10 segundos, los objetos nuevos se guardan una sola vez hasta que vuelve, y solo se pierden si se pierde el disco del servidor restante. |
| Metadatos de objetos y buckets de SeaweedFS | Hasta aproximadamente 1 segundo de cambios. |
| ClickHouse, servidores cercanos | Nada confirmado mientras está en buen estado. |
| ClickHouse, lejanos o degradados | Las inserciones que la copia aún no había obtenido; vuelven cuando el servidor antiguo regresa con su disco. |
Durabilidad
Sección titulada «Durabilidad»La durabilidad es síncrona por defecto cuando los servidores están cerca (tiempo de ida y vuelta de hasta 10 ms): un commit vuelve cuando la copia lo tiene. Es asíncrona cuando están lejos: un commit vuelve de inmediato, y una conmutación por error puede perder las escrituras más recientes. Cámbiala en la pestaña Availability. La durabilidad síncrona en servidores lejanos hace que cada commit espere el tiempo de ida y vuelta.
Opfield mide el tiempo de ida y vuelta cada 10 minutos y avisa cuando un conjunto síncrono se ha alejado, sin cambiar su durabilidad.
Cambio manual
Sección titulada «Cambio manual»Make this copy primary es un cambio planificado sin pérdida cuando el primario está sirviendo y la copia está al día. Cuando el primario ha desaparecido o la copia está retrasada, el cambio puede perder escrituras recientes: el diálogo muestra la estimación y te pide que la confirmes (API y MCP: acceptDataLoss: true). El primario antiguo vuelve como copia.
Conexión de los clientes
Sección titulada «Conexión de los clientes»Los enlaces y las vinculaciones siguen al primario por sí solos. Para conexiones directas a un recurso publicado, usa la cadena de conexión de la página del recurso: incluye todos los servidores, y un cliente que pruebe cada uno se queda con el que acepta escrituras. Una copia rechaza las conexiones de clientes.
Operaciones diarias
Sección titulada «Operaciones diarias»Mientras un recurso se ejecuta en varios servidores, sus acciones habituales abarcan todos los servidores:
- Cambiar los ajustes o la versión y reiniciar se hace servidor a servidor, primero las copias. Cuando el primario necesita reiniciarse, primero cede el rol a una copia actualizada sin pérdida, de modo que el recurso sigue sirviendo.
- Pausar, también cuando se apaga la app a la que pertenece, detiene primero las copias y después el primario, que conserva su rol, de modo que no hay conmutación por error. Reanudar arranca primero el primario.
- Antes de actualizar el daemon de un nodo, un primario en ese nodo cede el rol a una copia en buen estado.
- Las copias de seguridad leen de una copia al día cuando la hay y, si no, del primario.
- Una copia se puede reconstruir: sus datos se copian de nuevo desde el primario, y no puede tomar el relevo hasta que termine. Se pueden añadir y quitar servidores; un conjunto conserva al menos dos servidores.
- Activar o desactivar el TLS de una base de datos se rechaza mientras la disponibilidad está activada.
- Turn off availability conserva el primario como único servidor y elimina las copias. Eliminar el recurso desactiva primero la disponibilidad.
Alertas y avisos
Sección titulada «Alertas y avisos»Las categorías de alertas de bases de datos y Managed storage ofrecen eventos de conmutación por error, cambio, degradado, sin conmutación por error automática, restaurado, servidor que no informa, copia que ya no es síncrona, servidores que se han alejado, testigo perdido o movido, y reincorporación y reconstrucción, y métricas de retraso de replicación (bytes y segundos) y de tiempo de ida y vuelta. La pestaña Availability enumera los mismos eventos. El Dashboard muestra un aviso mientras un conjunto no puede conmutar por error, mientras el primario de un par replicado no informa, mientras se ha perdido un testigo, mientras un conjunto está degradado y durante un día después de una conmutación por error.
Plan y licencia
Sección titulada «Plan y licencia»La ejecución en varios servidores es una función de Business y Enterprise, incluidos los pares replicados con conmutación por error manual. Tras el periodo de gracia de la licencia, todo lo que se ejecuta sigue funcionando: la conmutación por error, el aislamiento (fencing), la reincorporación de copias, Make this copy primary, la reconstrucción de una copia, la eliminación de un servidor, la desactivación de la disponibilidad y los movimientos de testigos. Activarla, añadir un servidor y cambiar los ajustes se rechazan hasta que se renueva la licencia. Consulta Planes y derechos.
API y MCP
Sección titulada «API y MCP»REST: /api/databases/managed/{id}/availability y /api/managed-storage/{id}/availability (comprobación previa, activar, ajustes, miembros, hacer primario, reconstruir, eventos, desactivar). Se necesita el ámbito de edición del recurso (databases:edit o storage:edit) para los cambios y su ámbito de visualización para las lecturas. MCP: las acciones de disponibilidad de manage_managed_database y manage_managed_storage, y set_witness_hosting de manage_relay_pool.