

Opfield Inference
Opfield Inference da a un equipo un único endpoint para los modelos de IA aprobados. Los administradores conectan las cuentas de los proveedores, combinan fuentes compatibles detrás de ID de modelos públicos estables, deciden quién puede usar cada modelo y fijan límites por usuario. Los usuarios y los agentes de programación reciben un único token de Opfield en lugar de credenciales para cada proveedor upstream.
Es un plano de datos separado de AI Workspace y de MCP remoto. AI Workspace es el asistente integrado en la interfaz de Opfield; MCP expone herramientas de infraestructura a agentes externos; Opfield Inference transporta las peticiones y las respuestas de los modelos para los clientes de IA compatibles. Activar uno no activa silenciosamente los demás, y sus credenciales no son intercambiables.
Qué resuelve Opfield Inference
Sección titulada «Qué resuelve Opfield Inference»- Una única configuración de cliente: los clientes mantienen la misma URL base de Opfield y el mismo ID de modelo público mientras los administradores cambian las fuentes upstream compatibles.
- Control de acceso central: los modelos publicados se pueden restringir a usuarios y grupos seleccionados.
- Aislamiento de los proveedores: los usuarios finales nunca reciben las credenciales de la suscripción ni de la API del proveedor.
- Enrutamiento según la capacidad: Opfield tiene en cuenta el estado de la conexión, la cuota descubierta, los presupuestos, la compatibilidad de las fuentes y la disponibilidad actual antes de enviar una petición.
- Contabilidad normalizada: la capacidad de las suscripciones se convierte en créditos; el uso con claves de API se convierte en gasto con precio; ambos siguen siendo atribuibles al usuario de Opfield.
- Pruebas operativas: las peticiones, los intentos, las fuentes seleccionadas, el uso, los fallos y el estado final se registran sin poner el cuerpo de los prompts ni de las respuestas en los logs de actividad normales.
Opfield no crea capacidad en los proveedores ni sustituye las condiciones de privacidad, disponibilidad, residencia o contractuales del proveedor. Una conexión en buen estado significa que Opfield puede usarla en este momento, no que el proveedor garantice capacidad futura.
Arquitectura y flujo de las peticiones
Sección titulada «Arquitectura y flujo de las peticiones»flowchart TD Client[Cliente de IA<br/>Codex · Claude Code · SDK] --> API[API de Opfield Inference<br/>ID de modelo estable] API --> Admission[Autenticar al usuario<br/>comprobar acceso y presupuestos] Admission --> Router[Router de inferencia<br/>ordenar las fuentes compatibles] Router --> Subscription[Fuente de suscripción] Router --> ApiKey[Fuente con clave de API] Router --> Local[Otra fuente compatible] Subscription --> Provider[Proveedor de modelos seleccionado] ApiKey --> Provider Local --> Provider Provider --> Response[Respuesta en streaming o completa] Response --> Ledger[Liquidar el uso<br/>créditos o gasto de API] Ledger --> Client
La aplicación Opfield es responsable de los usuarios, la publicación de modelos, los permisos, los presupuestos y el uso visible. El inference core supervisado es responsable de la traducción de protocolos y de la ejecución. Las conexiones con los proveedores siguen siendo dependencias externas, y el cliente es responsable del prompt, de los identificadores de continuación y del tratamiento de la respuesta final.
Camino del administrador
Sección titulada «Camino del administrador»- Activa Inference en Settings > General.
- Instala el inference core supervisado y espera a que informe de que está en buen estado.
- Añade una conexión con un proveedor y completa su flujo de autenticación.
- Espera al descubrimiento de modelos y cuotas; no publiques a partir de datos de descubrimiento desactualizados.
- Crea un modelo público y asocia una o varias fuentes compatibles con el protocolo.
- Fija con precisión el contexto, la salida, las modalidades, los precios y los multiplicadores de suscripción.
- Configura una política de límites predeterminada y añade después sustituciones por usuario más restrictivas donde haga falta.
- Concede
feat:ai:usesolo a los usuarios o grupos que deban llamar a Inference. - Prueba una petición normal, un stream, un modelo denegado, un límite agotado y un fallo seguro de una fuente.
Añade una fuente alternativa solo cuando su protocolo, sus modalidades, su tamaño de contexto, su comportamiento con herramientas y la semántica de su salida coincidan con las demás fuentes del modelo.
Camino del usuario y endpoints de cliente
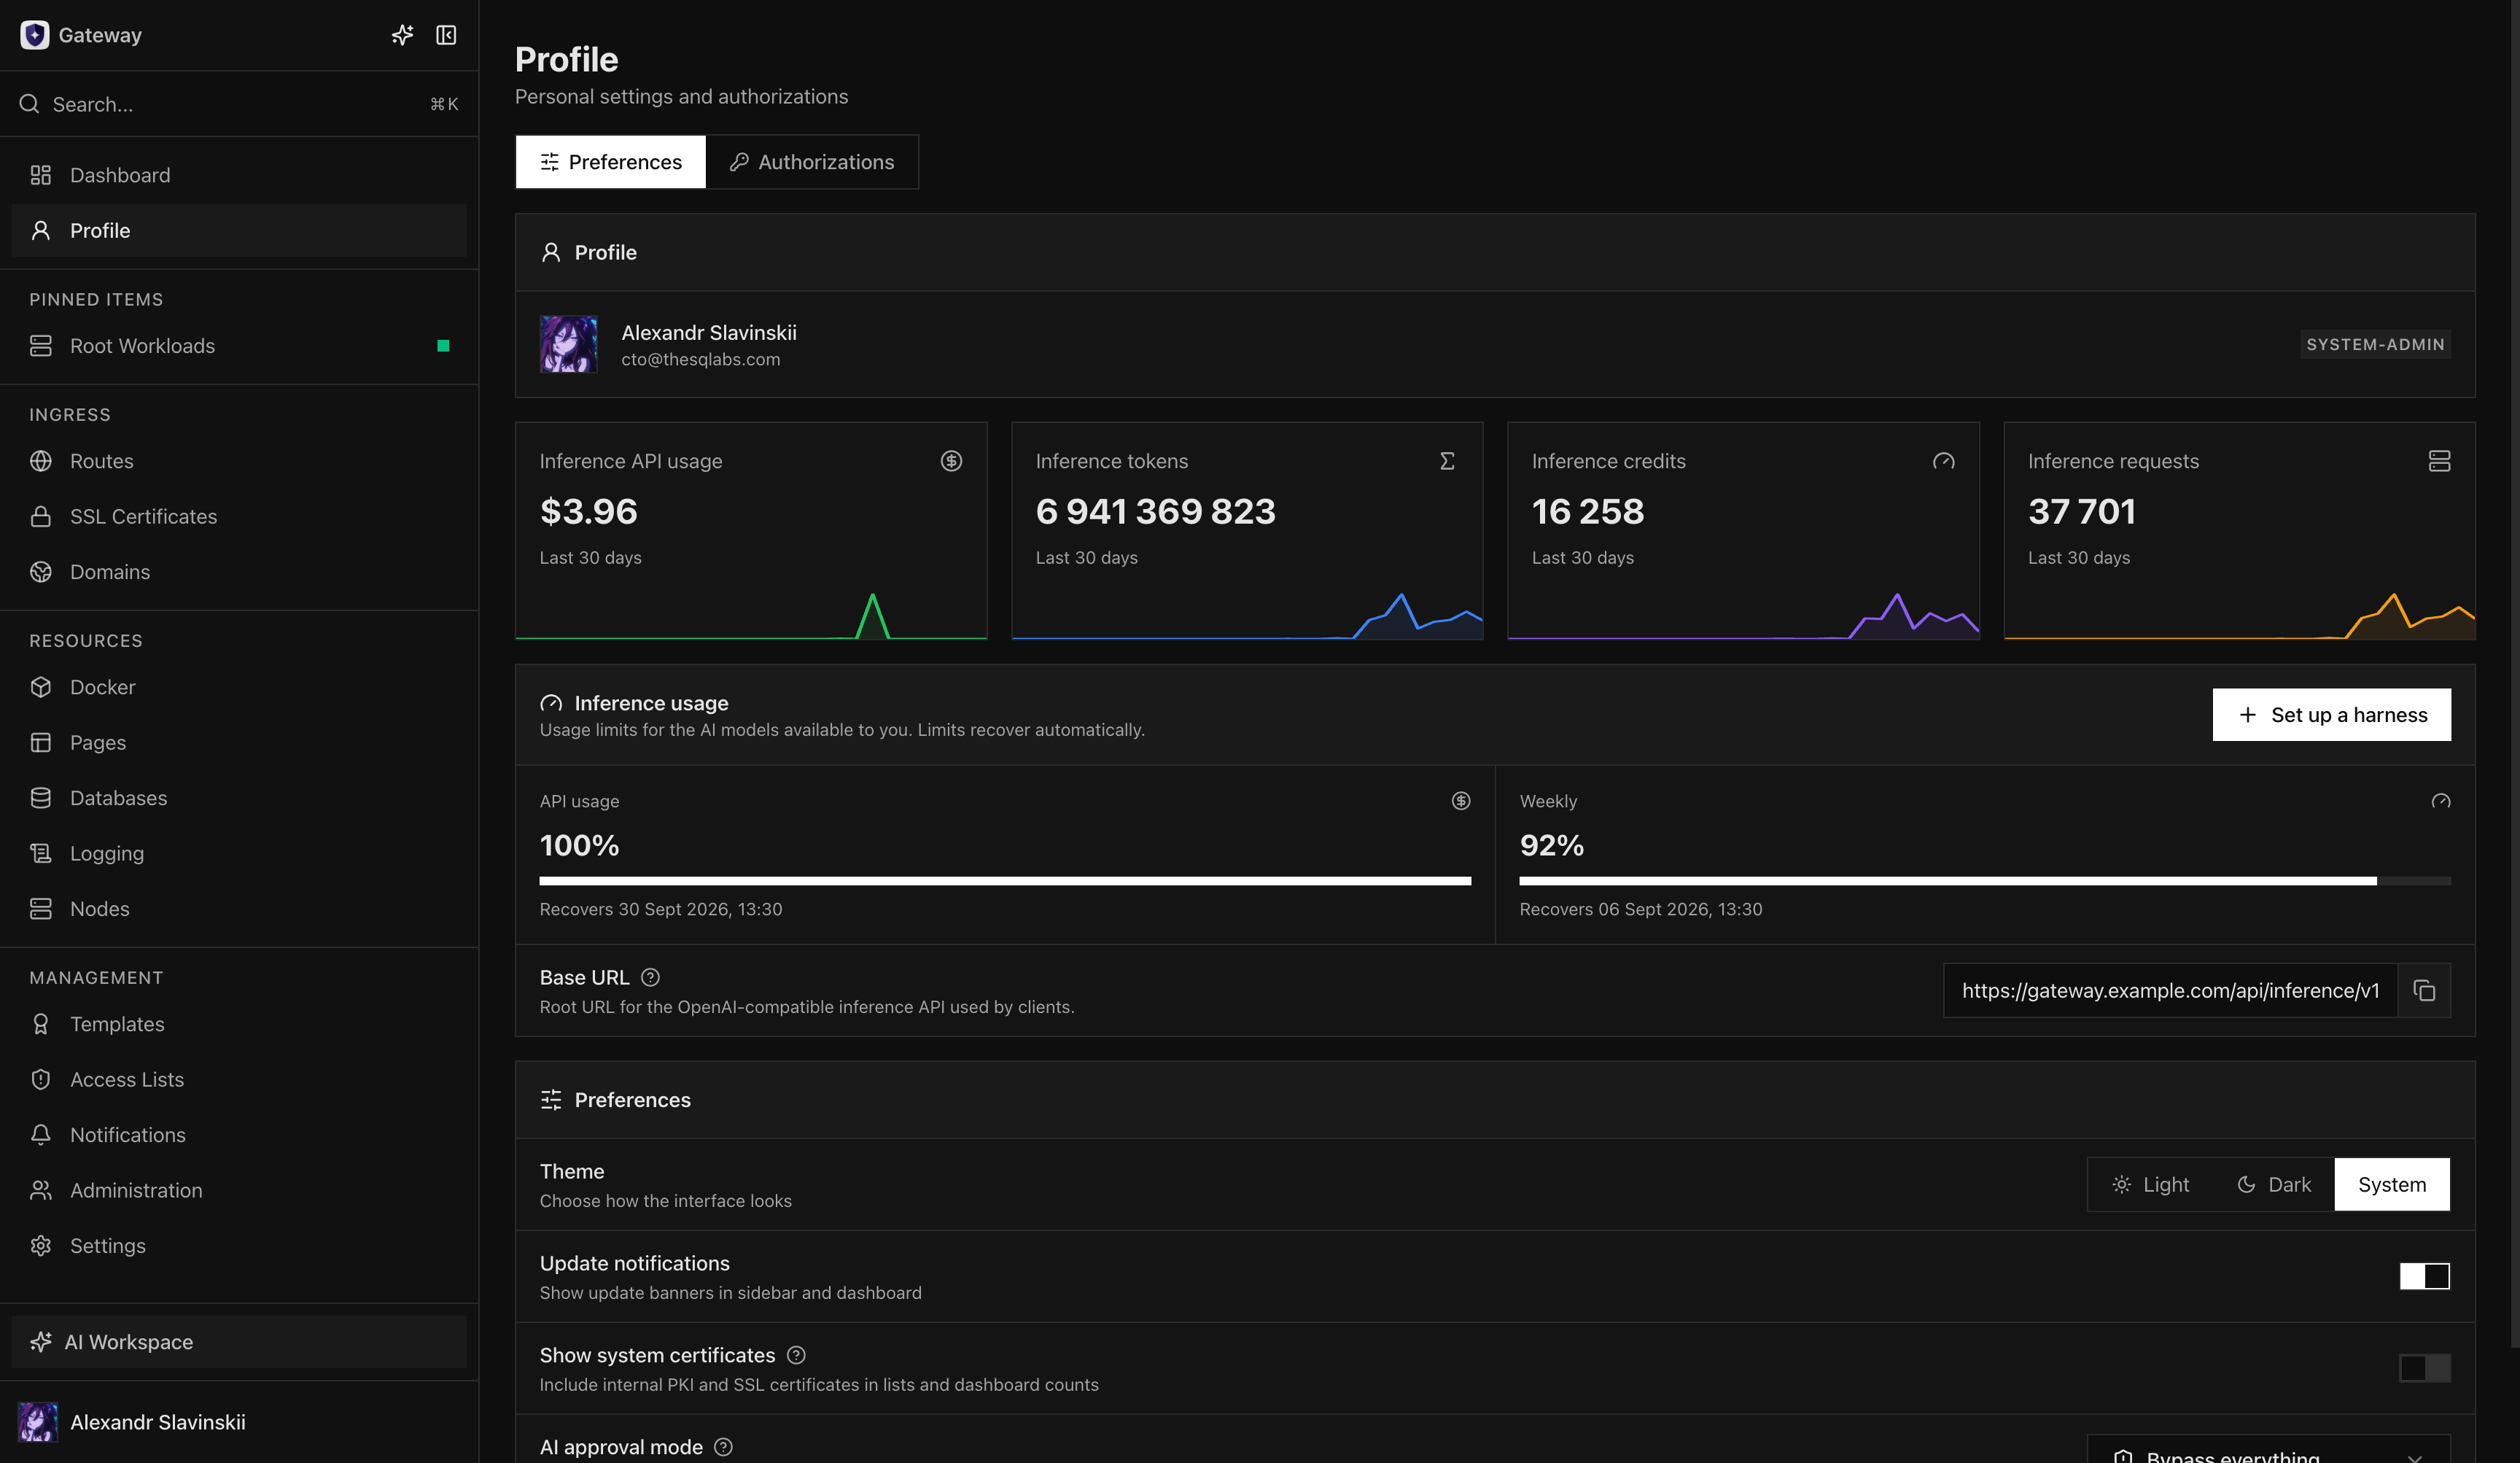
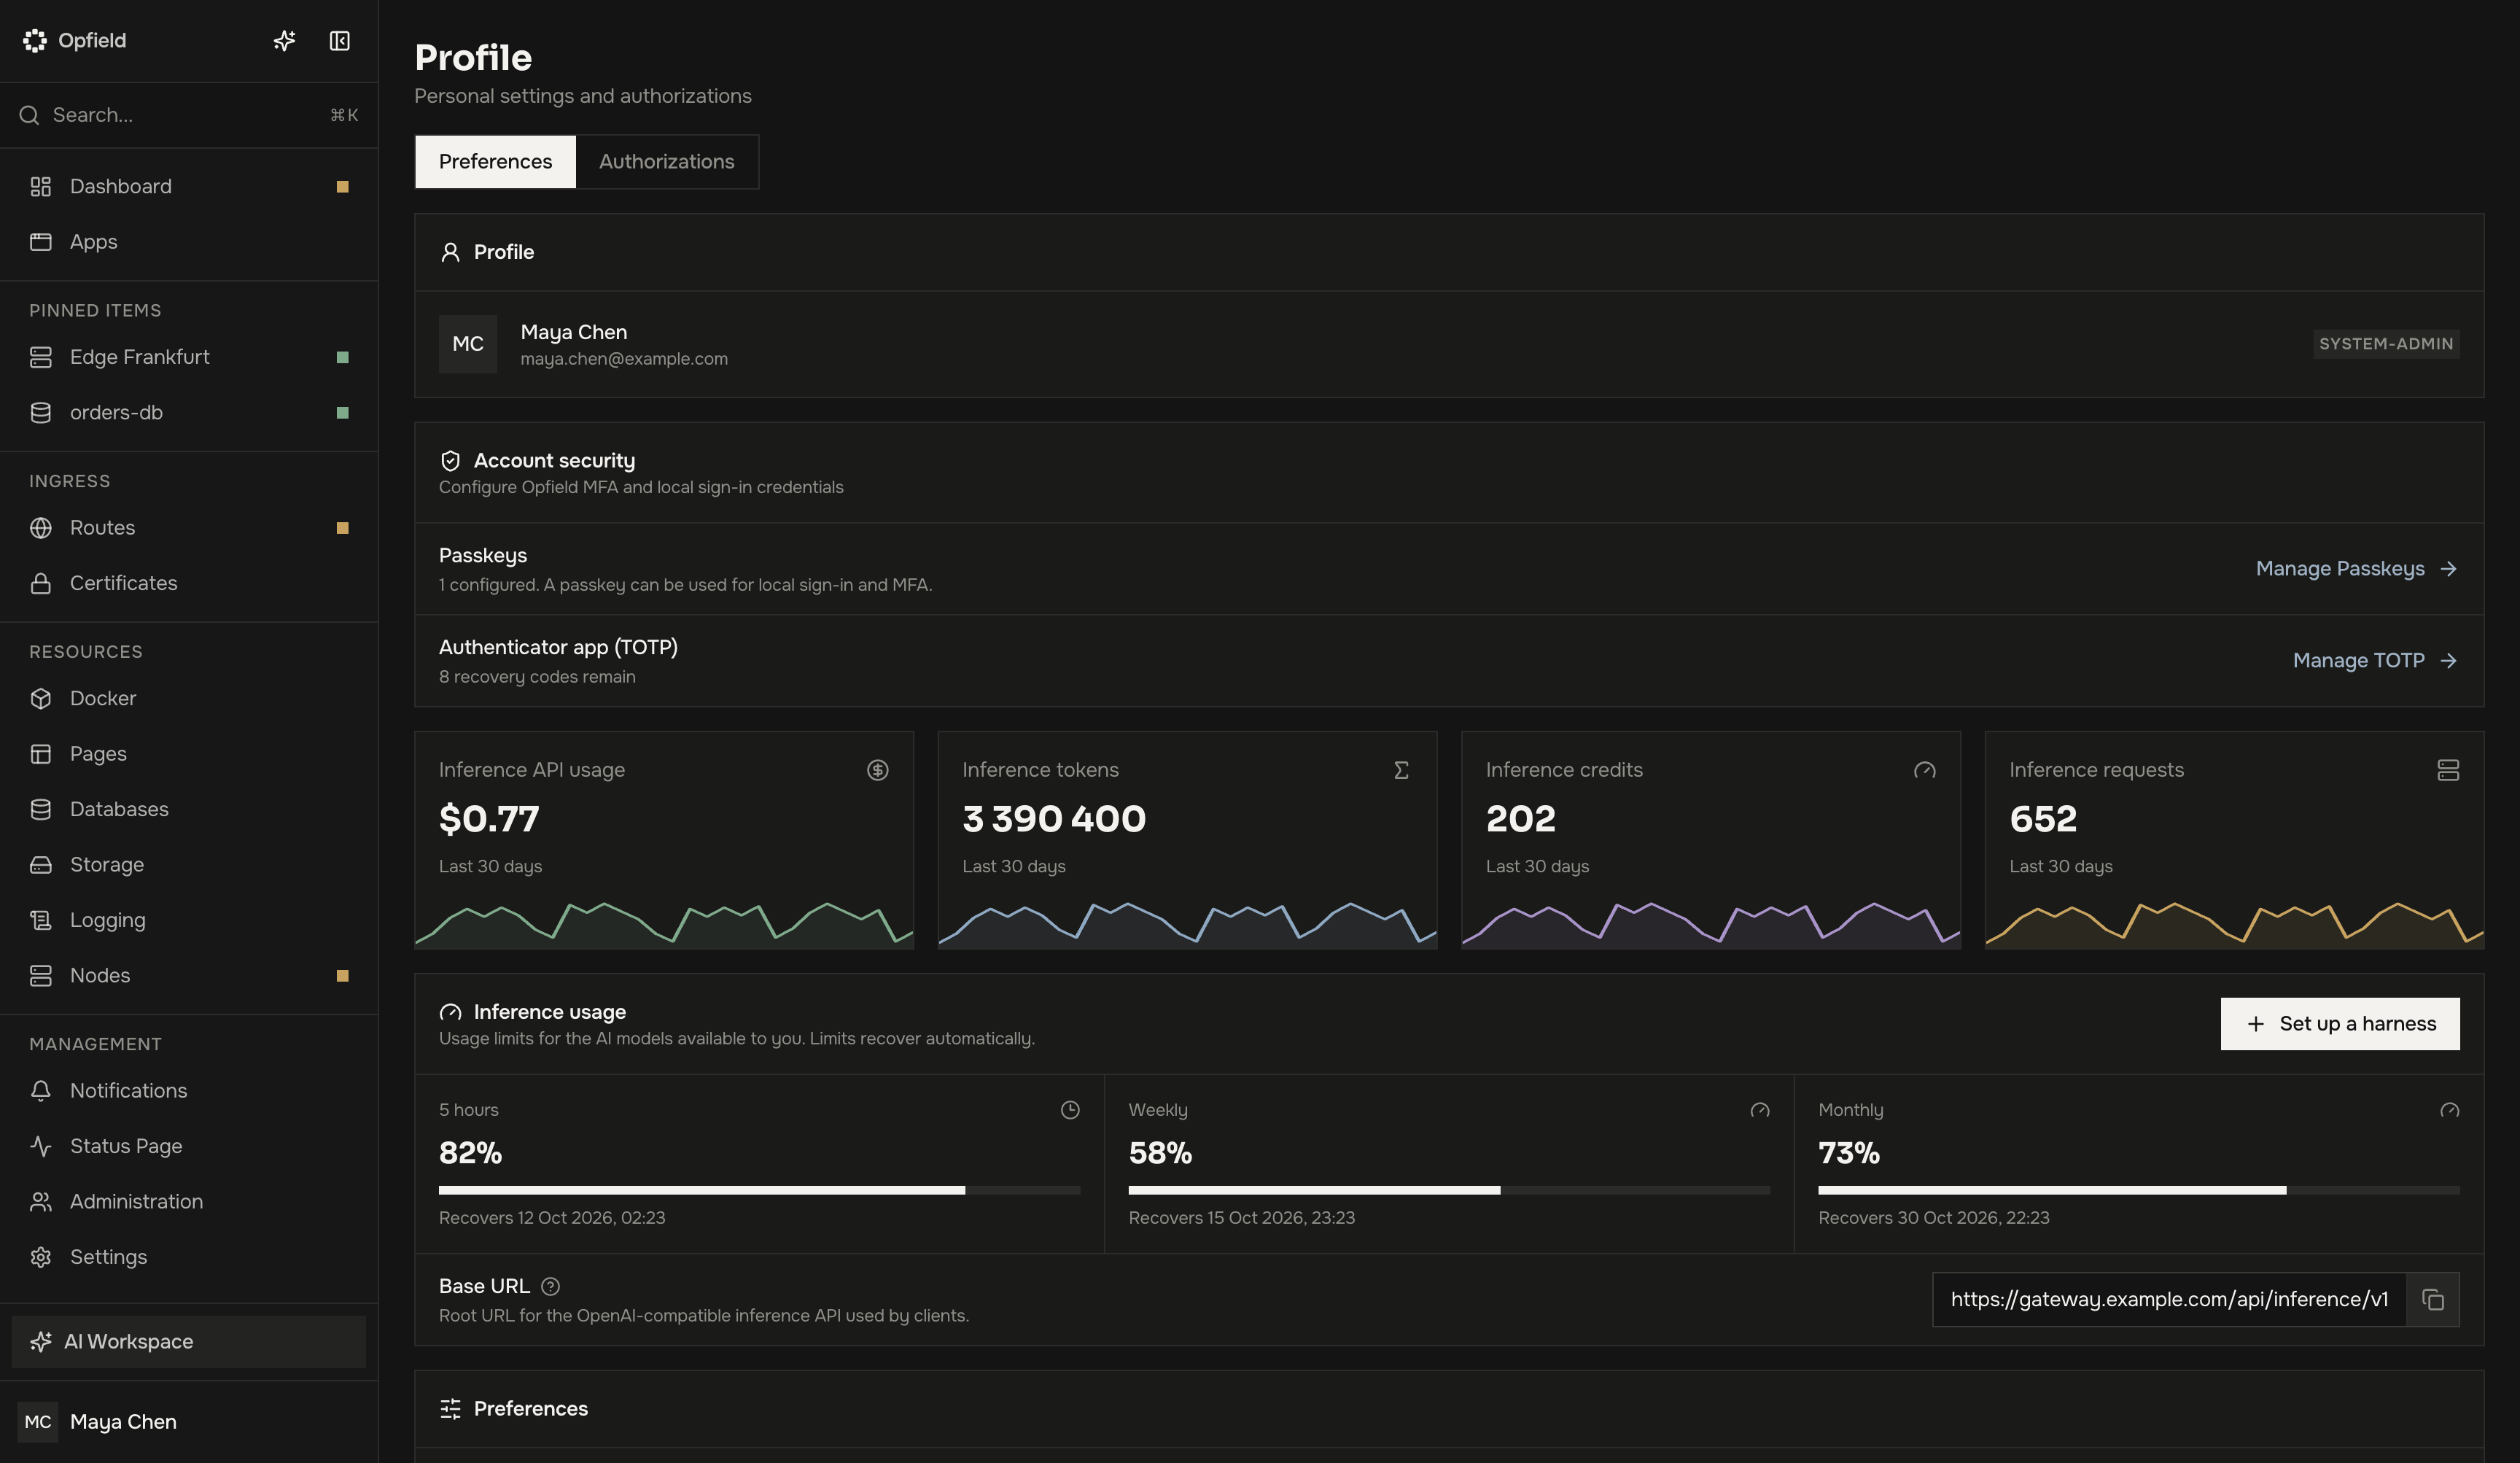
Sección titulada «Camino del usuario y endpoints de cliente»Los usuarios necesitan feat:ai:use. Para conectar un harness, haz clic en Set up a harness en el panel Inference usage de Profile (que se muestra cuando al usuario se le aplica al menos un límite) o en la fila Inference endpoints de Settings > Inference. El diálogo Set Up an Inference Harness muestra los valores que hay que pegar en los ajustes de proveedor del propio harness:
- URL base compatible con OpenAI:
https://opfield.example.com/api/inference/v1; - URL base compatible con Anthropic:
https://opfield.example.com/api/inference; los clientes de Anthropic añaden/v1/messagespor sí mismos; - Clave de API: un nuevo token
gwi_que el diálogo crea para el usuario y muestra una sola vez. Cada apertura revoca las claves de aperturas anteriores que ningún cliente ha usado; - Modelo: cualquier modelo disponible para el usuario.
El harness recomendado es DeepSeek harness: añade Opfield como proveedor en sus ajustes con estos valores. Cualquier otro harness o SDK que acepte un proveedor compatible con OpenAI o con Anthropic se configura de la misma forma.
Para crear un token sin el diálogo, usa Profile > Authorizations > Inference API Tokens. El token se muestra una vez y pertenece a ese usuario.
| Familia de clientes | URL base |
|---|---|
| Clientes compatibles con OpenAI | https://opfield.example.com/api/inference/v1 |
| SDK de Anthropic y clientes compatibles con Claude | https://opfield.example.com/api/inference |
Usa el ID de modelo público que publica el administrador, no el nombre del modelo en el proveedor upstream. GET /api/inference/v1/models enumera los modelos que puede llamar una clave gwi_; la consola lee la misma lista con la sesión del usuario desde GET /api/inference/catalog.
Proveedores, fuentes y modelos públicos
Sección titulada «Proveedores, fuentes y modelos públicos»Una conexión con un proveedor representa una cuenta o un endpoint upstream autenticado. El descubrimiento registra los modelos, las capacidades técnicas y la información de cuota que informa en ese momento esa conexión, y rellena los límites de los modelos, los niveles de razonamiento y las modalidades a partir de la lista en vivo del proveedor. Cuando el inference core no puede leer la cuenta o necesita que se vuelva a iniciar sesión, la sincronización informa de ese motivo en lugar de un éxito, y una lectura de cuota antigua no se guarda como actual. Cuando la conmutación por error se queda sin cuentas, los clientes reciben el error real del proveedor, como uno de autenticación, de cuota o de rechazo. Se reconocen Claude Fable 5.1, Mythos 5.1 y Opus 5.5; los modelos Fable 5.1 y Opus 5.5 publicados antes de la 2.11 tienen las herramientas desactivadas y deben volver a guardarse.
Una fuente conecta un modelo descubierto de un proveedor con un modelo publicado de Opfield. Una fuente puede sustituir el multiplicador de suscripción cuando su coste real de capacidad difiere del predeterminado del modelo. Desactivar una fuente la retira del enrutamiento nuevo sin obligar a los clientes a cambiar el ID de modelo público.
Un modelo publicado es el contrato estable que se expone a los usuarios. Define el ID público, los límites de contexto y de salida, las capacidades, las reglas de acceso y las fuentes compatibles. Que los nombres upstream se parezcan no basta: dos fuentes solo son alternativas seguras cuando su protocolo de petición y su comportamiento visible para el usuario son compatibles.
Las fuentes de los proveedores suelen usar uno de dos modos de contabilidad:
| Tipo de fuente | Lo que limita Opfield |
|---|---|
| Suscripción | Créditos en las ventanas activadas de 5 horas, 7 días y 30 días |
| Clave de API | Uso con precio frente a un presupuesto de gasto por mes natural |
Los endpoints locales o alojados de forma privada siguen necesitando una política explícita de precios y de fuentes si intervienen en la aplicación de los presupuestos. No publiques una fuente con capacidades o precios desconocidos solo porque supere una comprobación de estado.
Un modelo publicado también puede llevar un System prompt para el harness de Codex. Append to harness default conserva las instrucciones predeterminadas de Codex, incluidas sus reglas de herramientas y de formato de parches, y añade el prompt después de ellas; Replace harness default las sustituye por completo, así que un reemplazo debe repetir todas las reglas que el modelo siga necesitando. El prompt llega a un dispositivo en su siguiente actualización del catálogo de modelos y reinicio de Codex.
Ciclo de vida de las peticiones y conmutación por error
Sección titulada «Ciclo de vida de las peticiones y conmutación por error»Para cada petición, Opfield:
- valida el token
gwi_y resuelve su usuario; - resuelve el modelo público y verifica el acceso del usuario;
- construye un conjunto de fuentes aptas a partir de los modelos, las fuentes y las conexiones activados, la compatibilidad de protocolos, la cuota y el estado de los presupuestos;
- reserva una cantidad conservadora de capacidad antes de contactar con un proveedor;
- envía la petición a través del inference core y normaliza el streaming, el uso y los errores;
- reintenta en otra fuente compatible solo cuando el fallo está clasificado como reintentable y existe otra fuente apta;
- liquida la reserva con el uso real del proveedor, o con una estimación acotada cuando nunca llega el uso exacto;
- escribe un estado final de la petición y una entrada en el libro de uso.
Algunos protocolos requieren afinidad con la fuente para las continuaciones. Opfield conserva esa afinidad mientras siga siendo válida y la elimina cuando el ciclo de vida permite un reintento seguro. Los clientes no deben suponer que cualquier fallo puede pasar a otro proveedor: una entrada no válida, un acceso denegado, un ID de continuación no válido y un presupuesto de usuario agotado no son eventos de conmutación por capacidad.
Las peticiones con y sin streaming deben llegar a un estado final. Tras una interrupción de red, inspecciona la petición registrada antes de enviar un duplicado potencialmente costoso.
Durante las respuestas SSE largas y silenciosas, incluida la compactación, Opfield envía un comentario keepalive inicial y comprueba cada 15 segundos si hace falta otro. Los comentarios solo se emiten entre eventos completos y cuando el consumidor puede aceptar datos. No son salida del modelo ni eventos de finalización; el evento final real sigue controlando la contabilidad. Esto protege el stream HTTP de los tiempos de inactividad de los intermediarios.
Créditos y contabilidad del uso
Sección titulada «Créditos y contabilidad del uso»Los créditos son una medida normalizada del consumo de los proveedores por suscripción. No son dinero y, a propósito, no son idénticos a los totales brutos de tokens. Opfield pondera las clases de tokens y aplica después los multiplicadores efectivos de la fuente.
Fórmula de los créditos
Sección titulada «Fórmula de los créditos»weighted tokens = uncached input tokens + cached input tokens × 0.10 + cache-write tokens × 1.25 + output tokens + reasoning tokens
public credits = weighted tokens ÷ 1,000,000 × model multiplier × burn multiplier × service-tier multiplierCon un multiplicador total de 1×, un crédito público representa un millón de tokens ponderados.
| Componente | Peso | Por qué difiere |
|---|---|---|
| Entrada sin caché | 1.00 |
Procesamiento completo del prompt |
| Lectura de entrada en caché | 0.10 |
Reutilizar una caché existente del proveedor es más barato |
| Escritura en caché | 1.25 |
Crear el estado de la caché consume capacidad adicional |
| Salida | 1.00 |
Los tokens generados cuentan por completo |
| Razonamiento | 1.00 |
Los tokens de razonamiento informados cuentan por completo |
Los multiplicadores significan:
- Multiplicador del modelo: el coste de suscripción del modelo publicado, que una fuente concreta puede sustituir opcionalmente.
- Multiplicador de consumo (burn): protege la capacidad de suscripción compartida cuando la cuota del proveedor se consume más deprisa de lo que permite el tiempo restante. Normalmente es
1×, puede subir de forma dinámica y está limitado a8×. Las peticiones de compactación usan1×. - Multiplicador del nivel de servicio: las peticiones de suscripción de OpenAI que usan el nivel
Fast/priorityconsumen2×créditos. Las demás combinaciones actuales usan1×.
El multiplicador de consumo compara la cuota de suscripción restante con el tiempo restante en cada ventana descubierta del proveedor. En forma simplificada:
burn multiplier = min(8, max( 1, time remaining fraction ÷ quota remaining fraction, 0.30 ÷ quota remaining fraction))Opfield calcula el multiplicador por modelo entre las cuentas de suscripción de ese modelo. Una ventana de cuota que un proveedor limita a una familia de modelos solo cuenta para esa familia. Si faltan datos de cuota, el multiplicador se queda en 1×; una cuota descubierta desactualizada, vacía o agotada puede forzar el valor protector de 8×.
Ejemplo práctico
Sección titulada «Ejemplo práctico»Supón que una semana contiene:
- 600 millones de tokens de entrada sin caché;
- 1500 millones de tokens de entrada en caché;
- 100 millones de tokens de escritura en caché;
- 300 millones de tokens de salida;
- 50 millones de tokens de razonamiento.
El total ponderado es:
600M + 1,500M × 0.10 + 100M × 1.25 + 300M + 50M= 1,225M weighted tokensCon un multiplicador del modelo de 2×, un multiplicador de consumo de 1.25× y el nivel de servicio normal de 1×:
1,225M ÷ 1M × 2 × 1.25 × 1 = 3,062.5 creditsPor eso dos usuarios con totales brutos de tokens similares pueden consumir créditos distintos: el comportamiento de la caché, la elección del modelo, la presión sobre la cuota del proveedor y el nivel de servicio influyen.
Límites de créditos semanales sugeridos
Sección titulada «Límites de créditos semanales sugeridos»El límite de 7 días es una ventana de uso que empieza con la primera petición del usuario respaldada por una suscripción, no una asignación por semana natural. Estos valores son puntos de partida aproximados para un usuario que ejecuta agentes de programación u otras cargas de trabajo de contexto largo:
| Límite semanal | Perfil de uso | Interpretación práctica |
|---|---|---|
2,500 créditos |
Ligero | Sesiones de agentes ocasionales y trabajo diario breve |
5,000 créditos |
Habitual | Desarrollo diario con contexto y uso de herramientas moderados |
7,500 créditos |
Intensivo | Sesiones largas frecuentes, varios repositorios o trabajo repetido con contexto amplio |
10,000 créditos |
Elevado | Uso diario sostenido de agentes con una rotación de contexto alta |
15,000 créditos |
Muy elevado | Cargas de trabajo casi continuas de usuarios avanzados o de varios agentes |
Trata la tabla como una base para la política, no como la promesa de un número fijo de peticiones o de tokens. Empieza con el perfil más cercano, observa al menos una ventana completa de 7 días y ajusta después según los multiplicadores reales del modelo y de consumo. Usa políticas por usuario en lugar de multiplicar un límite compartido por el tamaño del equipo.
Ventanas de uso y margen de seguridad
Sección titulada «Ventanas de uso y margen de seguridad»El uso de las suscripciones se puede limitar de forma independiente en ventanas de 5 horas, 7 días y 30 días. Un cargo cuenta en todas las ventanas activadas. Cada ventana empieza con la primera petición del usuario respaldada por una suscripción después de que terminara la ventana anterior y se restablece por completo cuando caduca; la siguiente ventana empieza con la siguiente petición de ese tipo. La interfaz indica la hora de restablecimiento de cada ventana.
Opfield reserva capacidad antes de enviar una petición, y el límite de suscripción configurado se puede gastar por completo. Una petición admitida mientras el usuario todavía tiene saldo positivo siempre se ejecuta hasta el final, de modo que el último turno puede liquidarse ligeramente por encima del límite; Opfield nunca acorta una petición admitida. La siguiente petición después de agotarse el saldo se deniega con la hora de recuperación de la ventana.
Las fuentes con clave de API no consumen créditos de suscripción. Opfield pone precio a la entrada sin caché, la entrada en caché, las escrituras en caché, la salida, el razonamiento y los cargos por unidad compatibles usando la instantánea de precios actual de la fuente, y aplica después el límite de gasto mensual configurado. Concilia esa estimación operativa con el extracto del proveedor antes de tomar decisiones financieras.
Visibilidad del uso y administración
Sección titulada «Visibilidad del uso y administración»Los usuarios pueden ver su uso actual de Inference y sus ventanas de recuperación en Profile. El Dashboard puede mostrar las ventanas bajas o agotadas. Los administradores con acceso al uso pueden inspeccionar los totales del sistema, las políticas por usuario, la actividad de peticiones, las clases de tokens, los créditos, el gasto de API, los modelos seleccionados y el estado final.
Configura primero los valores predeterminados del sistema. Una política por usuario puede restringir el valor predeterminado, pero no debe reabrir silenciosamente una dimensión desactivada globalmente. Restablece el uso solo por un motivo operativo explícito; aumentar un límite suele ser más claro que borrar el historial que sirve para explicar un incidente.
Límites de privacidad y de credenciales
Sección titulada «Límites de privacidad y de credenciales»Opfield no pone el cuerpo de los prompts ni de las salidas de los modelos en los registros de actividad normales. Guarda metadatos normalizados, clases de tokens, coste, la fuente seleccionada, los intentos, los errores y el estado final. El proveedor seleccionado sigue recibiendo el contenido de la petición, así que revisa sus condiciones de retención, entrenamiento, residencia y tratamiento de datos antes de publicarlo.
Los tokens gwi_ solo son válidos para Opfield Inference. Las sesiones del navegador, los tokens de la REST API gw_, los tokens OAuth gwo_, los tokens de logging gwl_ y la autorización de MCP no se pueden usar en su lugar. Usa tokens separados para clientes separados y revoca un token cuando cambie su cliente o su propietario.
Las direcciones upstream privadas se deniegan por defecto. Permítelas solo cuando el administrador acepte intencionadamente el límite de confianza de la red y haya protegido el camino frente a la falsificación de peticiones del lado del servidor y a los accesos internos no previstos.
Diagnóstico de fallos
Sección titulada «Diagnóstico de fallos»| Síntoma | Comprueba primero |
|---|---|
401 |
Que el token gwi_ exista, no esté revocado y se envíe a la URL base de Inference |
| Modelo no encontrado o denegado | ID de modelo público, acceso del grupo, activación de la fuente y capacidades publicadas |
| Capacidad no disponible | Descubrimiento actual, cuota del proveedor, estado de la conexión, fuentes alternativas aptas |
| Presupuesto agotado | Créditos 5h/7d/30d del usuario o límite de gasto mensual de la API y hora de recuperación |
| Continuación rechazada | Afinidad con la fuente original, identificador de continuación y compatibilidad del proveedor |
| El stream se detiene sin finalizar | Desconexión del cliente, evento final del proveedor, estado del intento de la petición y conciliación |
| El uso parece inesperadamente alto | Clasificación de la caché, multiplicador del modelo, multiplicador de consumo dinámico y nivel Fast/priority |
| El gasto de API difiere de la factura | Instantánea de precios, nivel de contexto largo, cargos por unidad que no son tokens y extracto del proveedor |
Inspecciona en este orden el estado del inference core, el estado de la conexión con el proveedor, los modelos y las cuotas descubiertos, las reglas de publicación, el acceso del token, los límites del usuario, los candidatos aptos y la compatibilidad de protocolos. Reiniciar el core no sustituye a corregir un contrato de proveedor o de modelo no válido.
Despliegue y reversión
Sección titulada «Despliegue y reversión»Para cada modelo nuevo, prueba ambos protocolos anunciados, la finalización del streaming, el agotamiento del presupuesto, un modelo denegado, tokens revocados y una conmutación segura entre fuentes. Fija los límites semanales a partir de los valores sugeridos y compara el uso en Opfield con la capacidad o la facturación del proveedor.
Para retirar un modelo, deja de conceder acceso nuevo, identifica los clientes que usan su ID público y proporciona un sustituto probado. Si una fuente deja de ser segura o de estar disponible, desactiva esa fuente y verifica el enrutamiento de los candidatos antes de volver a activar el modelo público. No apuntes un ID público existente a un modelo materialmente distinto solo para que las peticiones sigan devolviendo 200.