

Nodos y daemons
Para crear VM directamente desde Opfield, consulta Proveedores de hosting. Las cuentas conectadas aparecen en Nodes > Providers. La guía cubre el encendido de las VM, el cortafuegos, las instantáneas y los permisos de facturación.
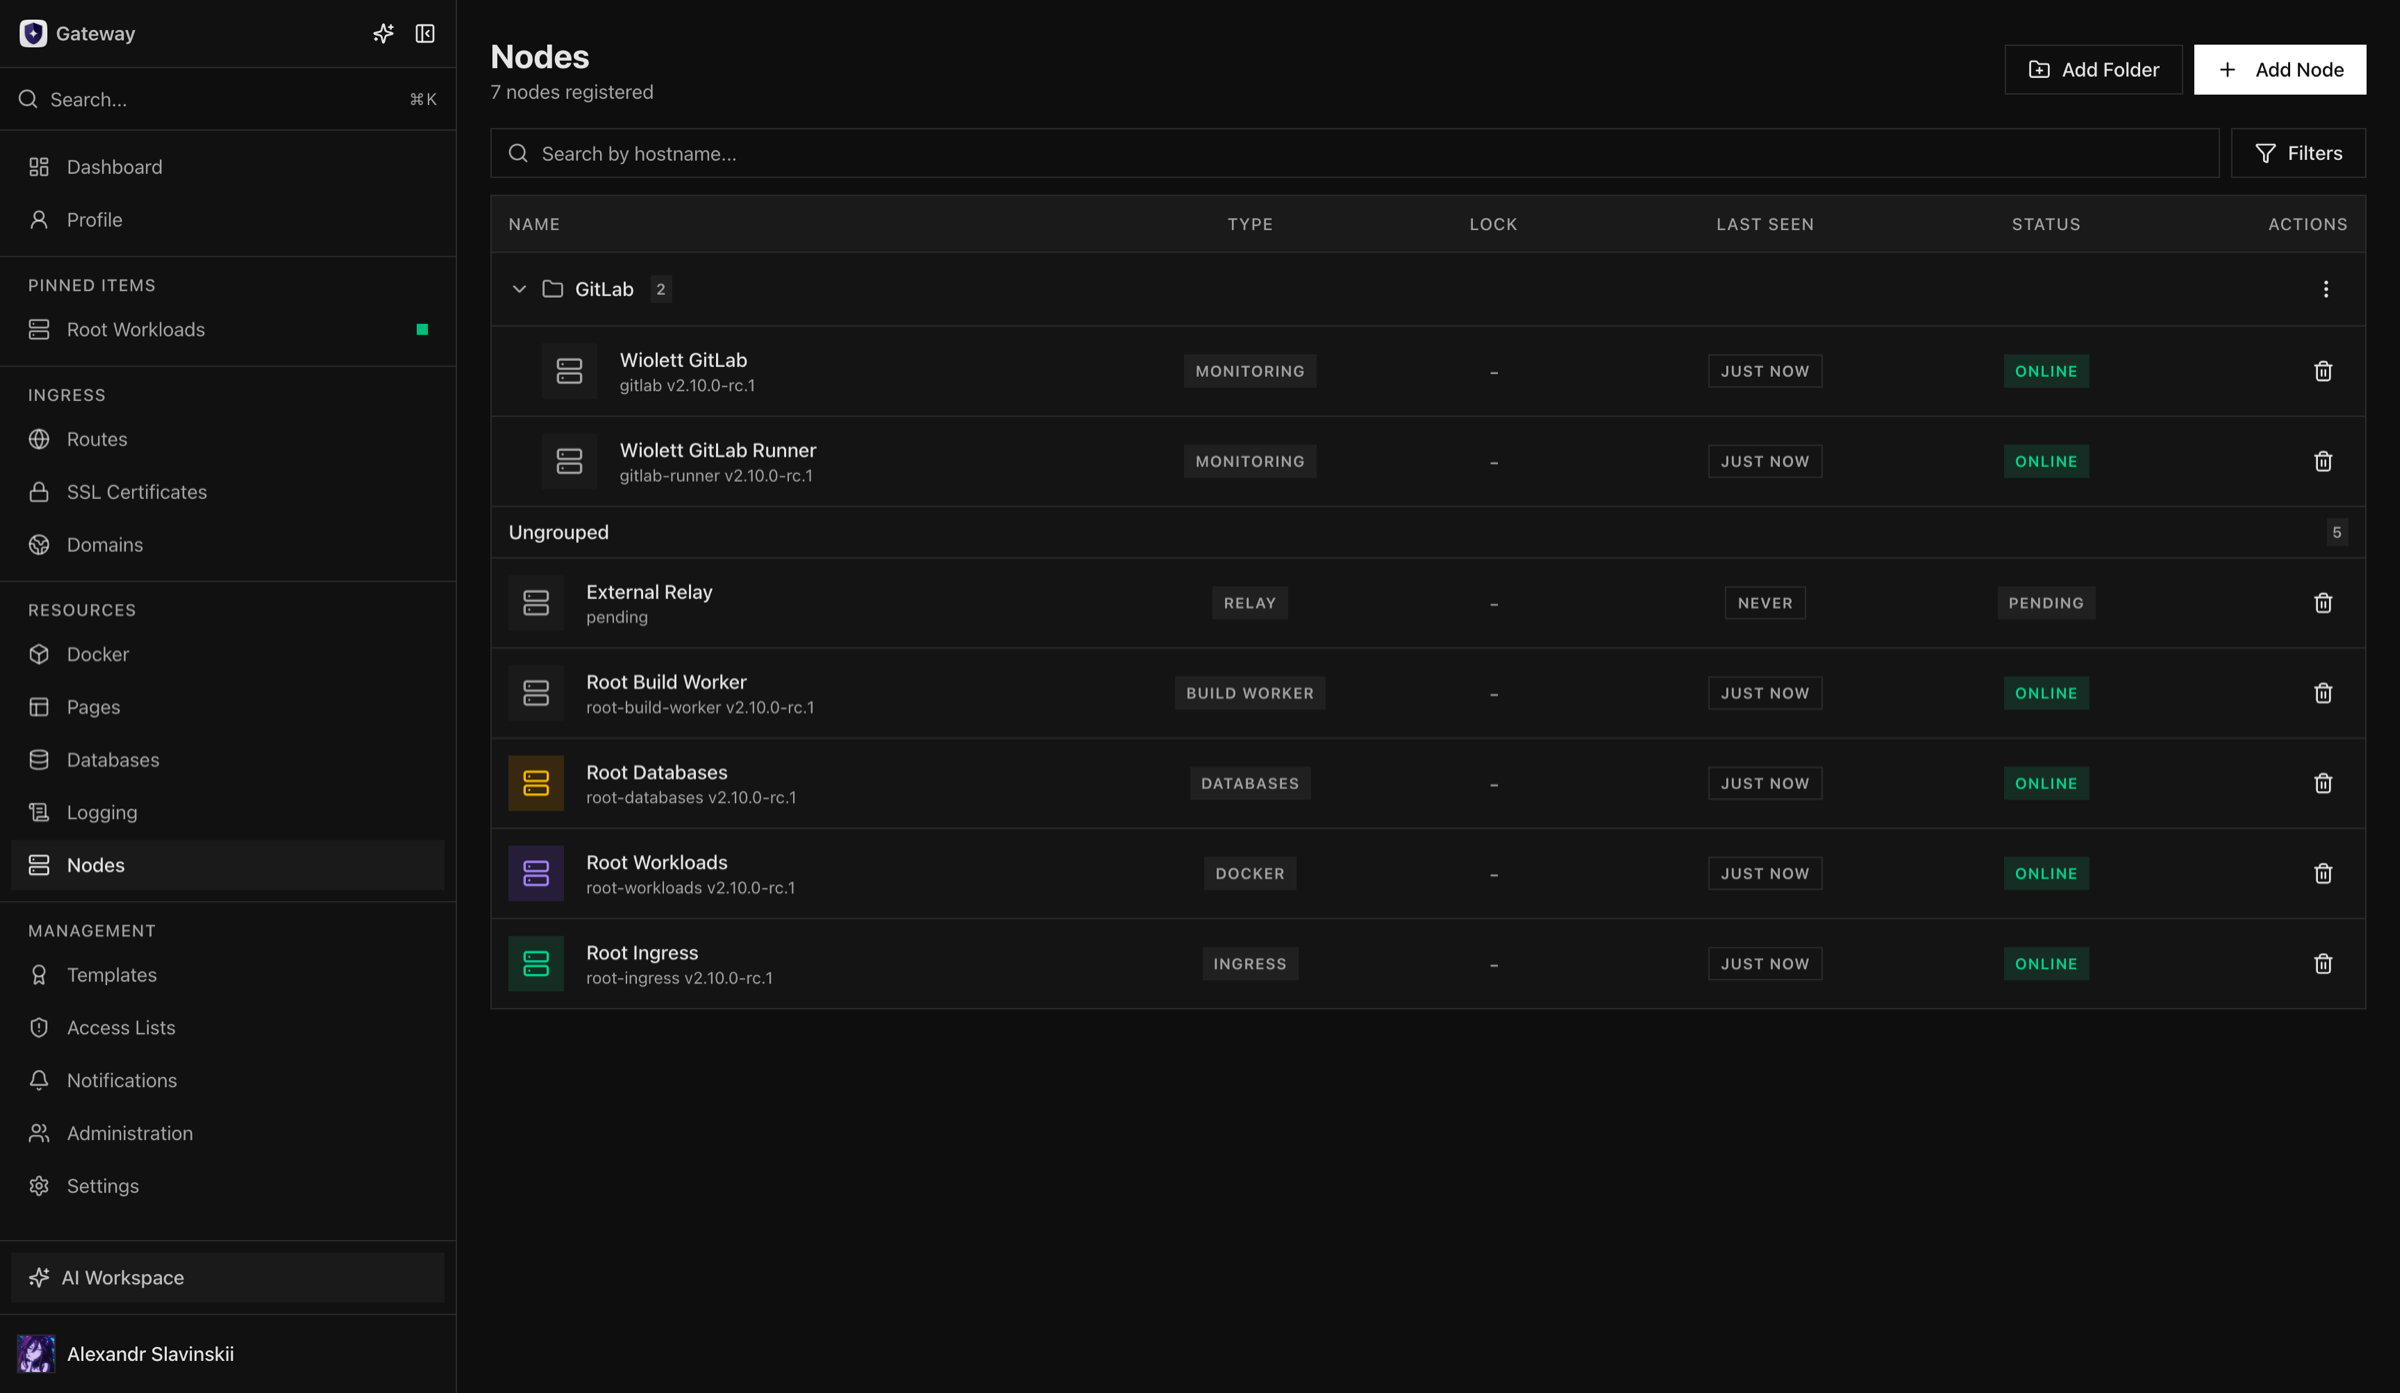
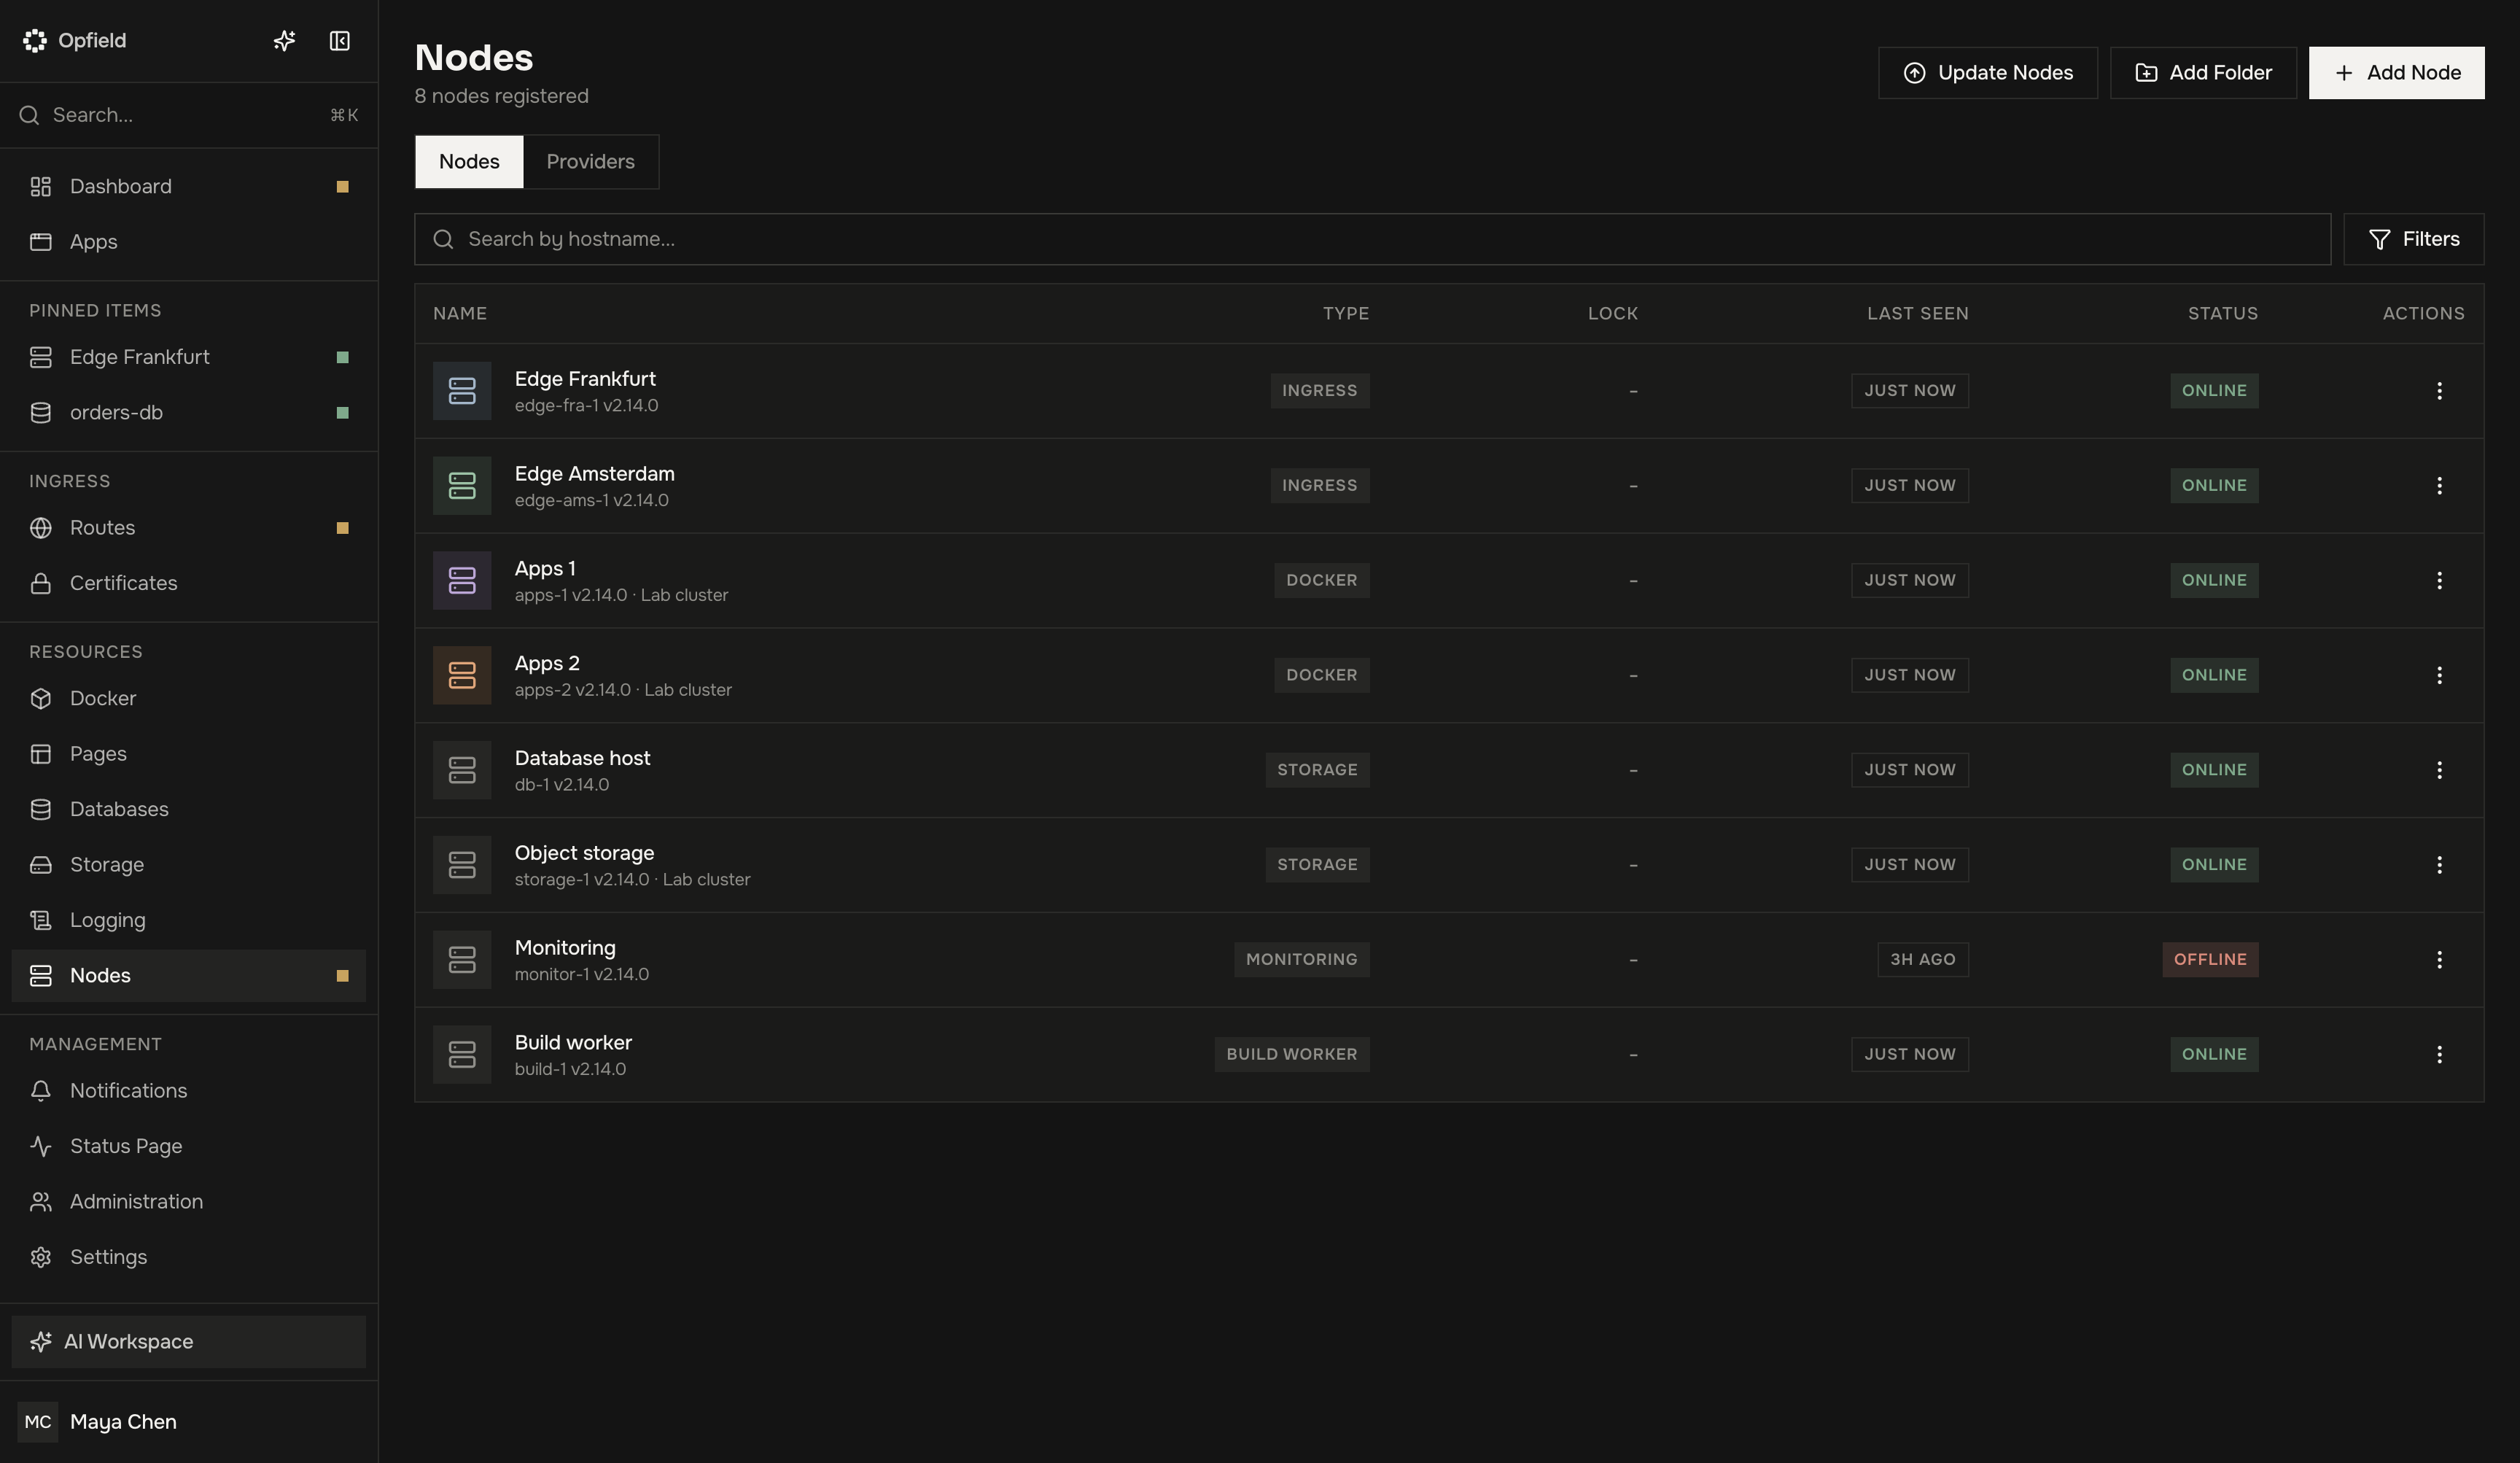
Un nodo es la identidad duradera de Opfield para un rol de un host gestionado. El daemon informa del nombre de host, la versión, el estado, el inventario, las métricas, las direcciones de servicio y las capacidades propias de su rol a través de una sesión saliente autenticada.
Opfield separa las responsabilidades de Ingress, Docker, Storage, Build Worker, Monitoring y Relay. Selecciona el rol exacto durante el registro y no reutilices la identidad de un daemon para un límite de confianza diferente.
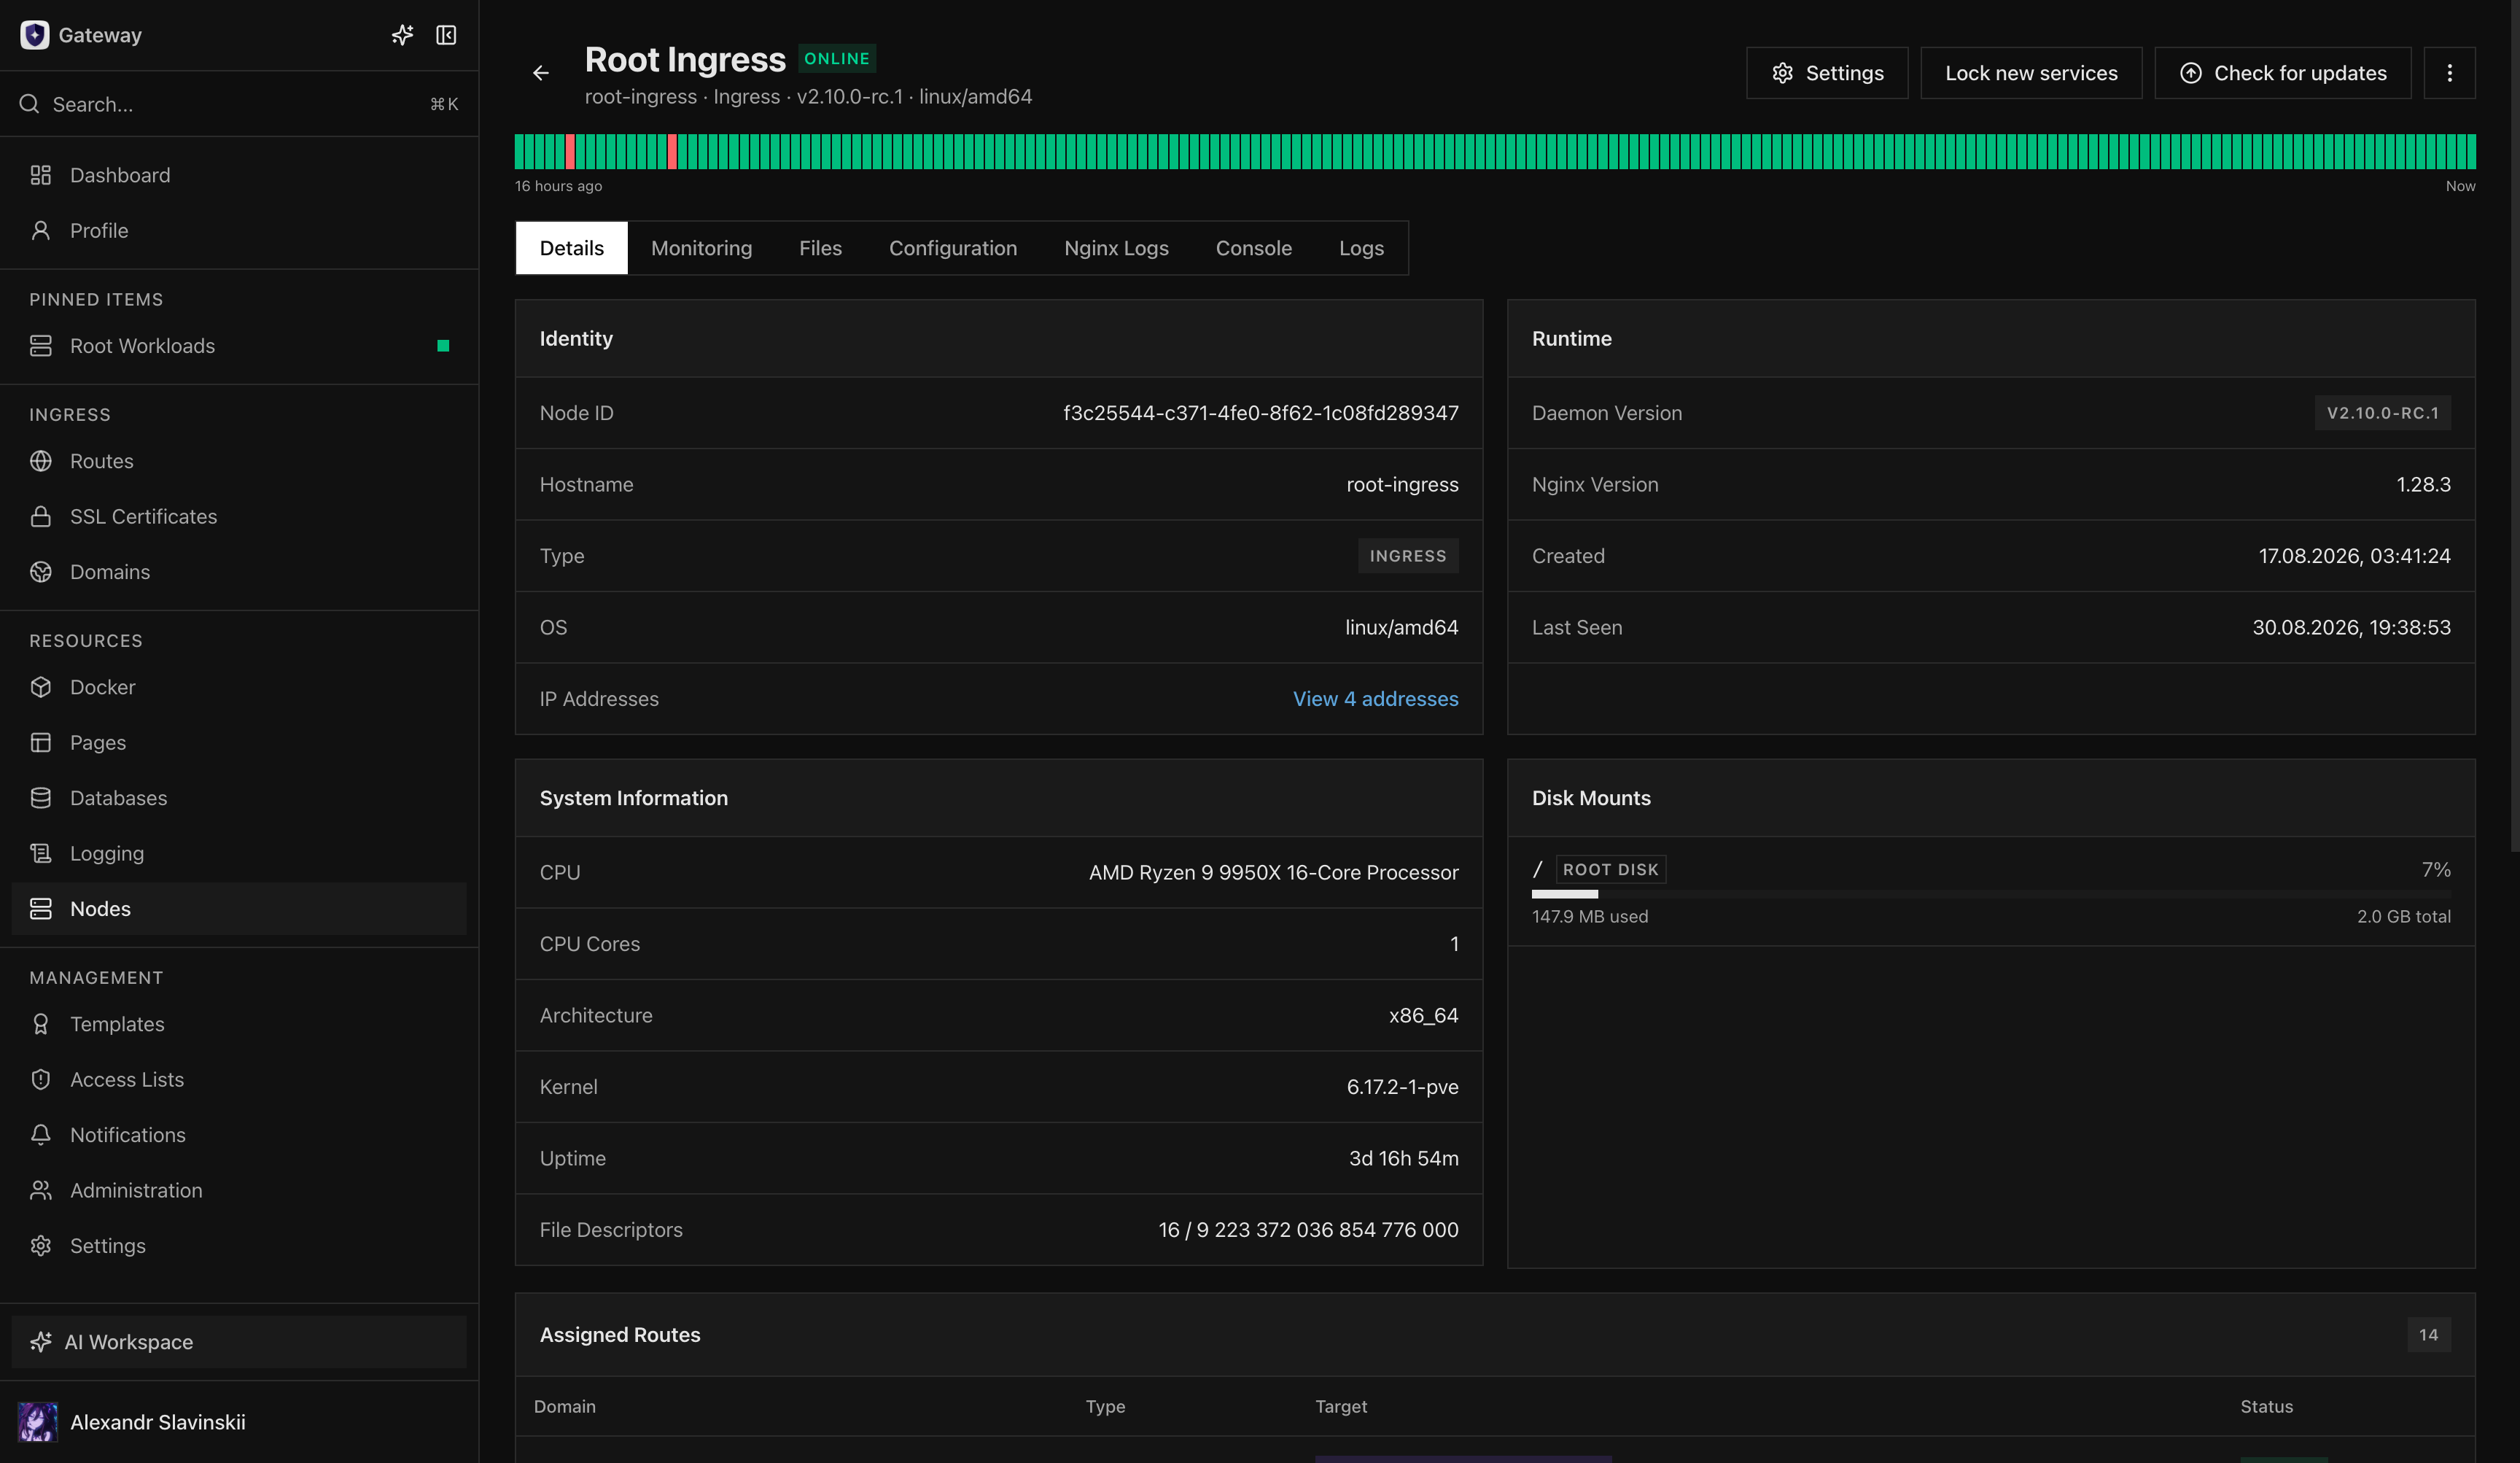
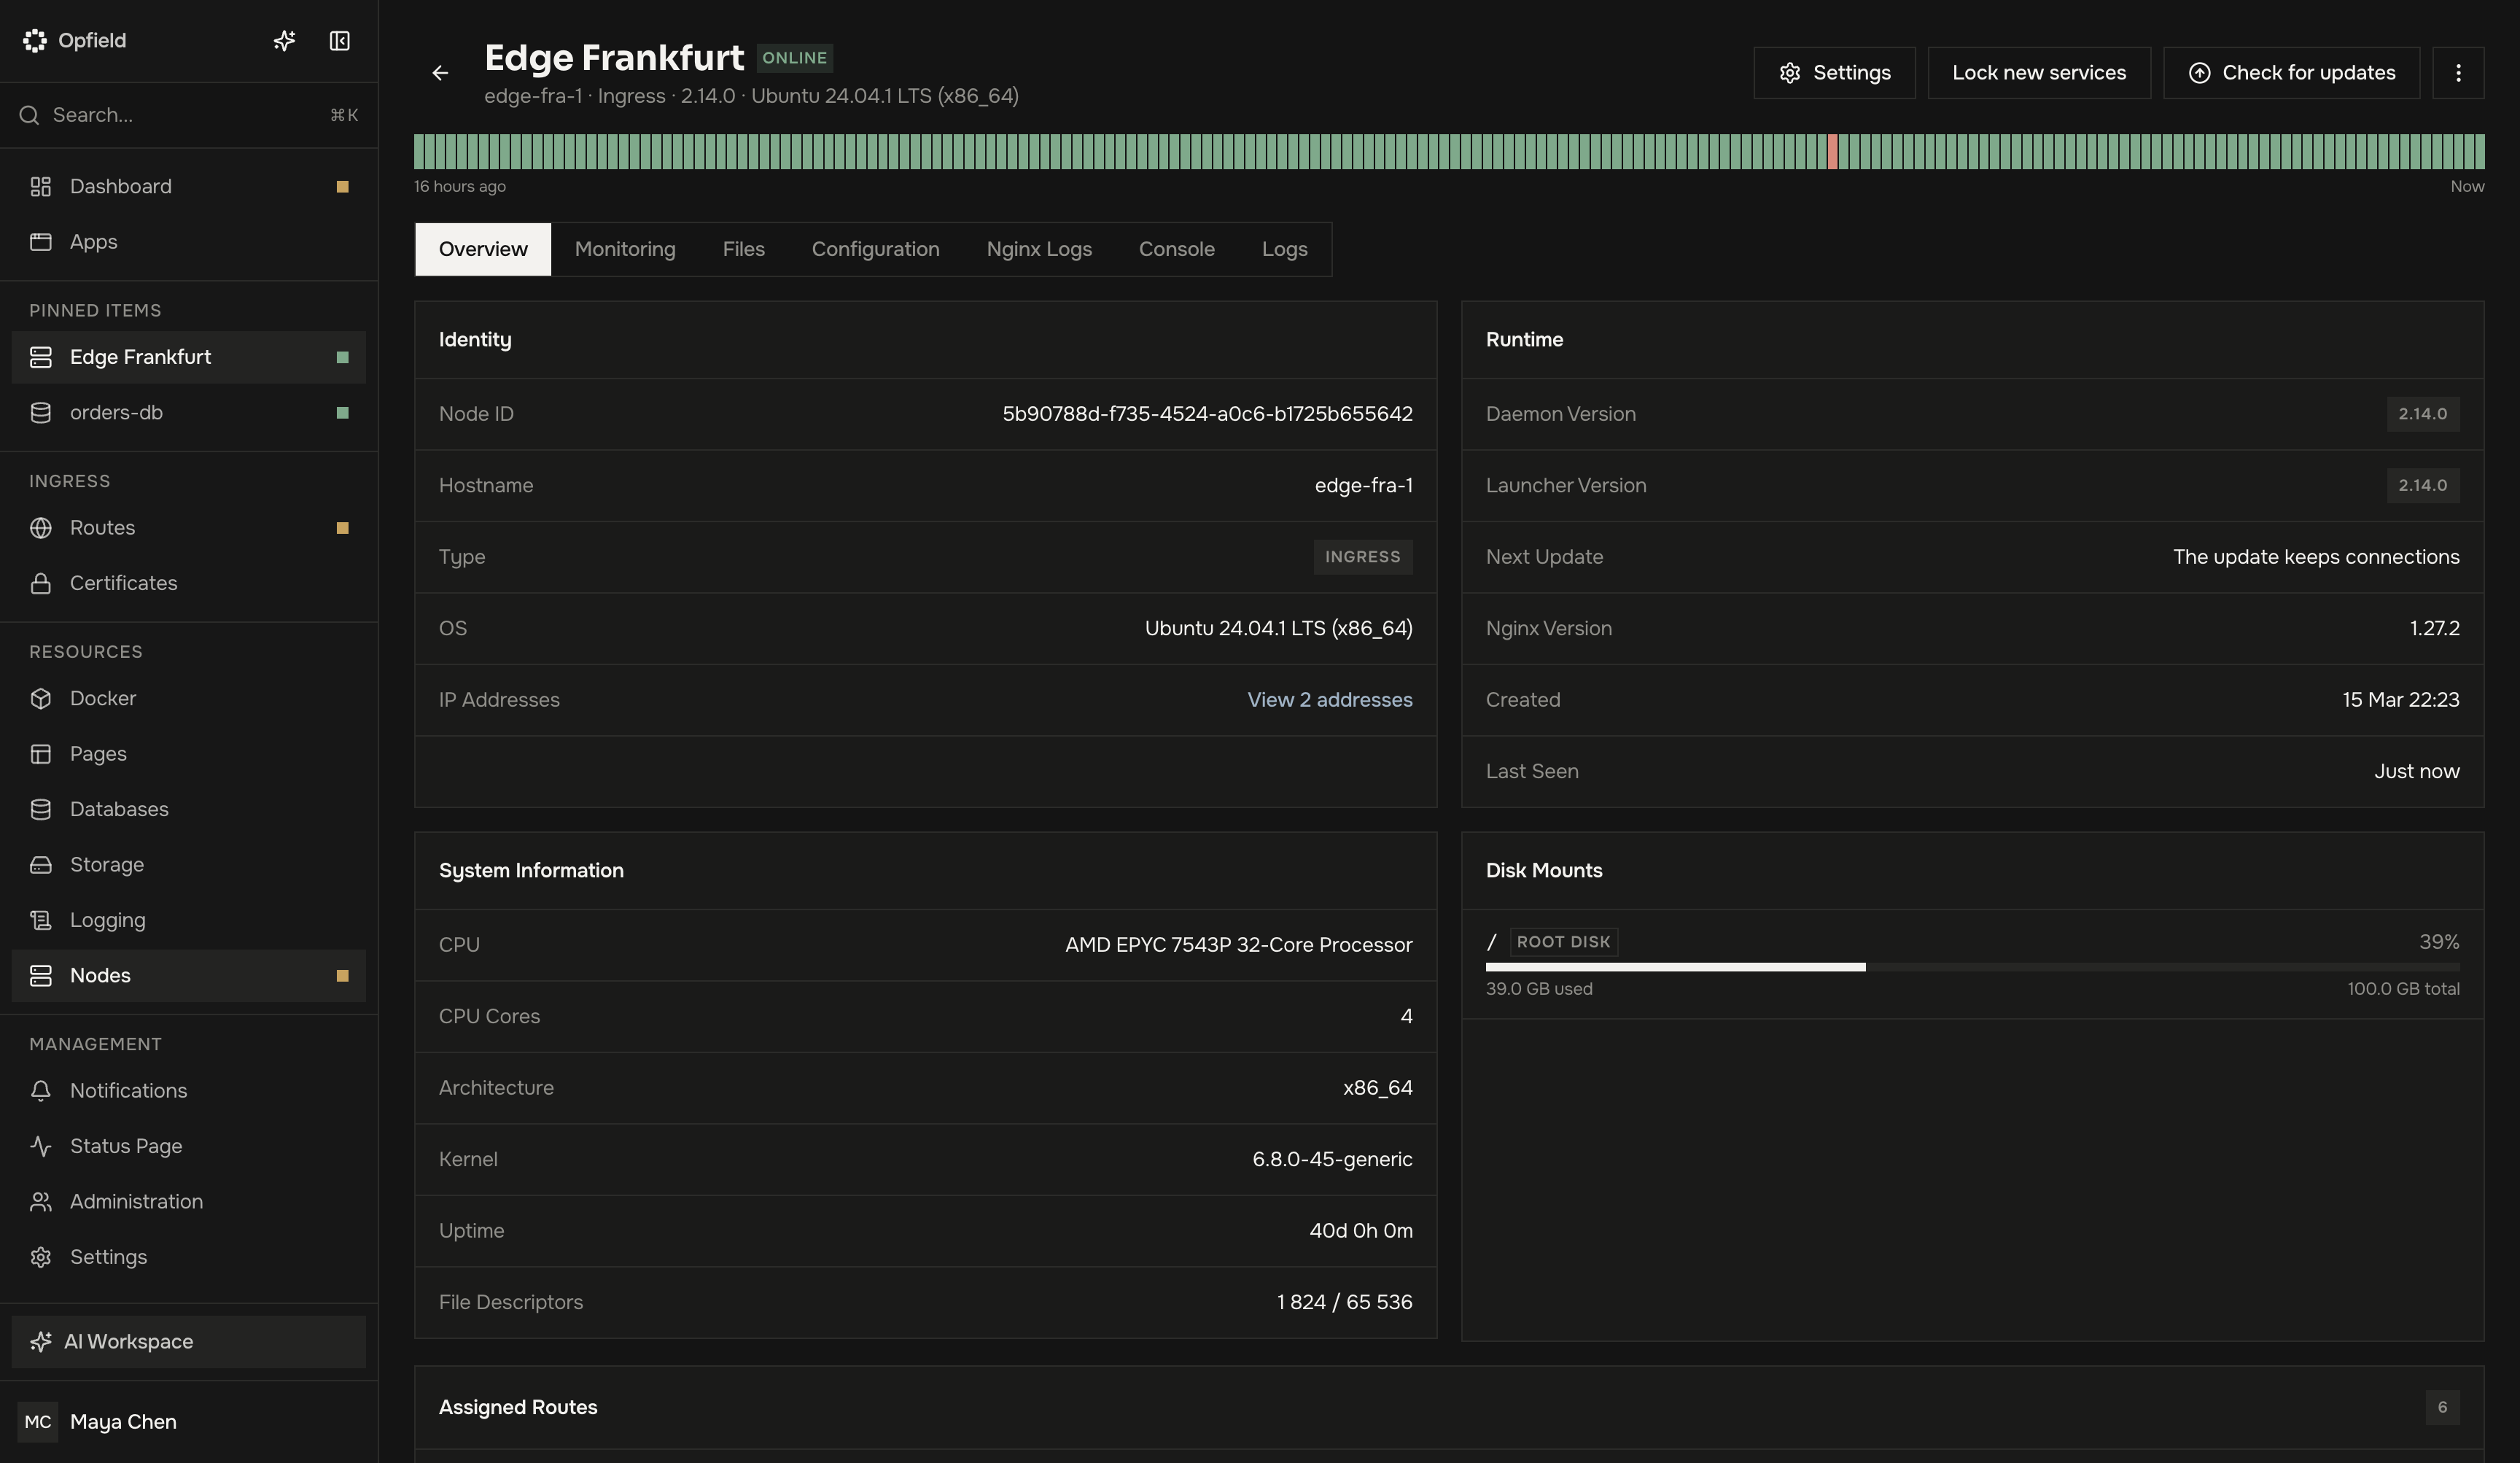
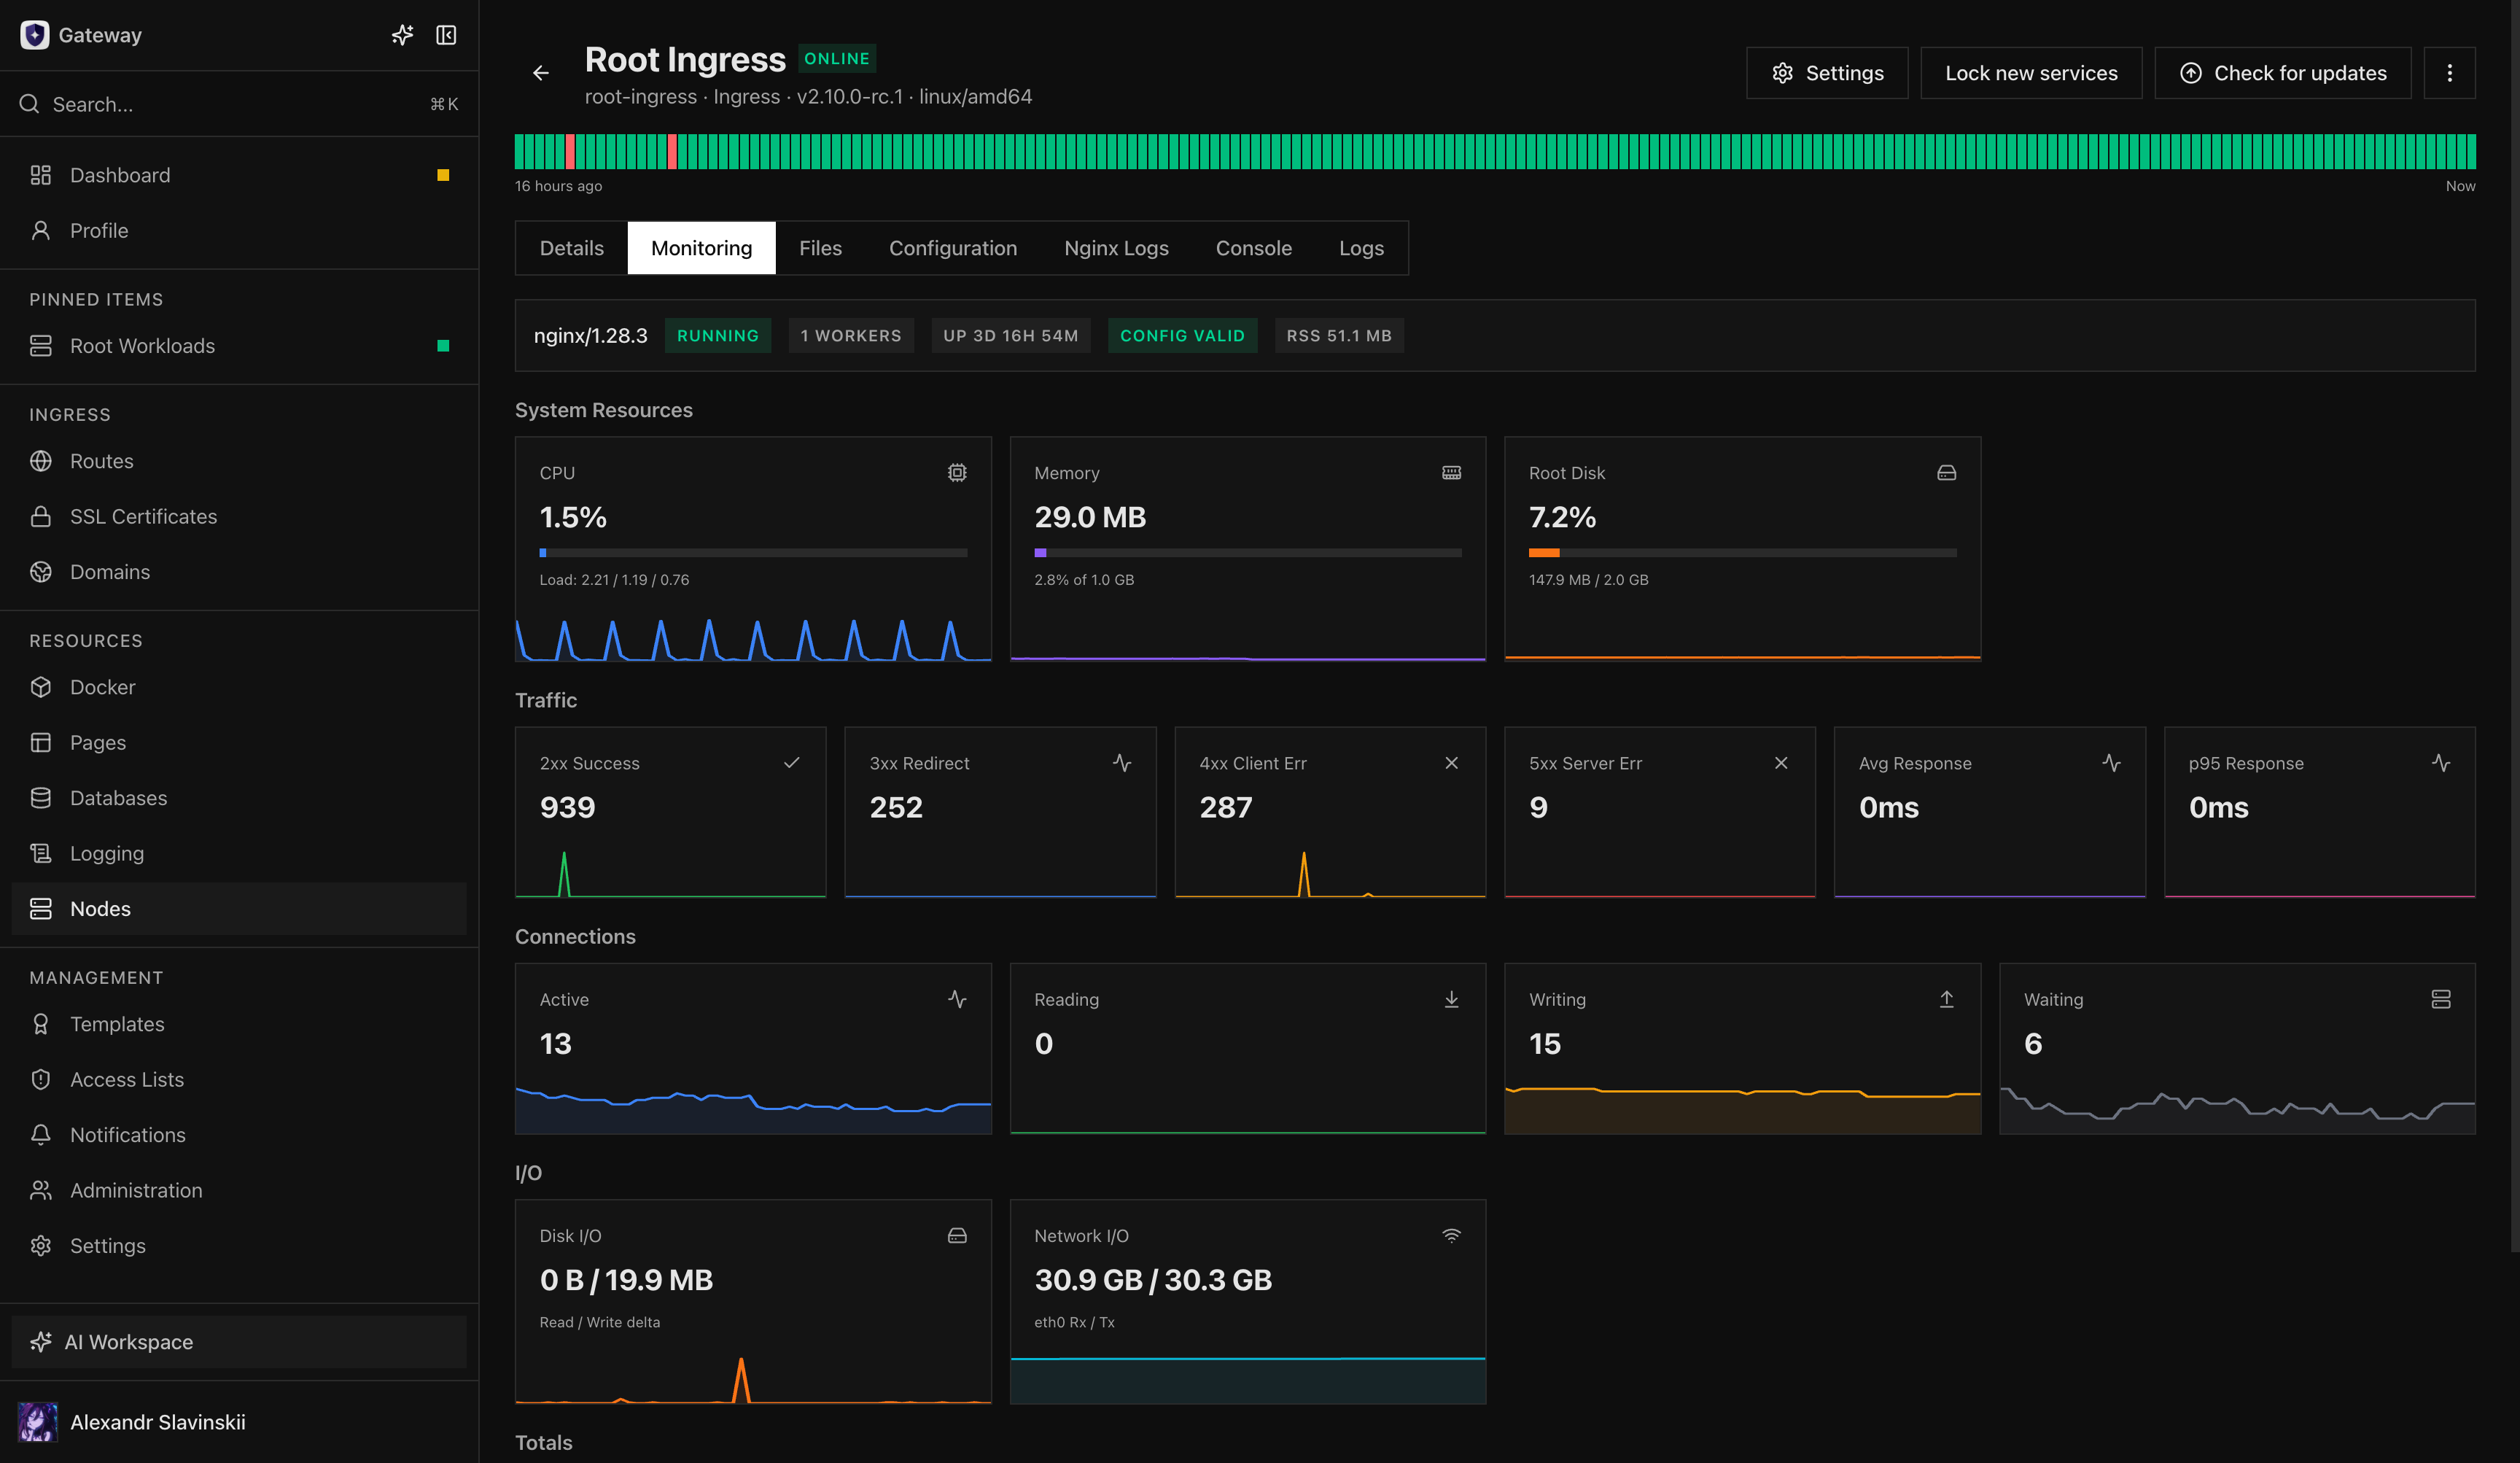
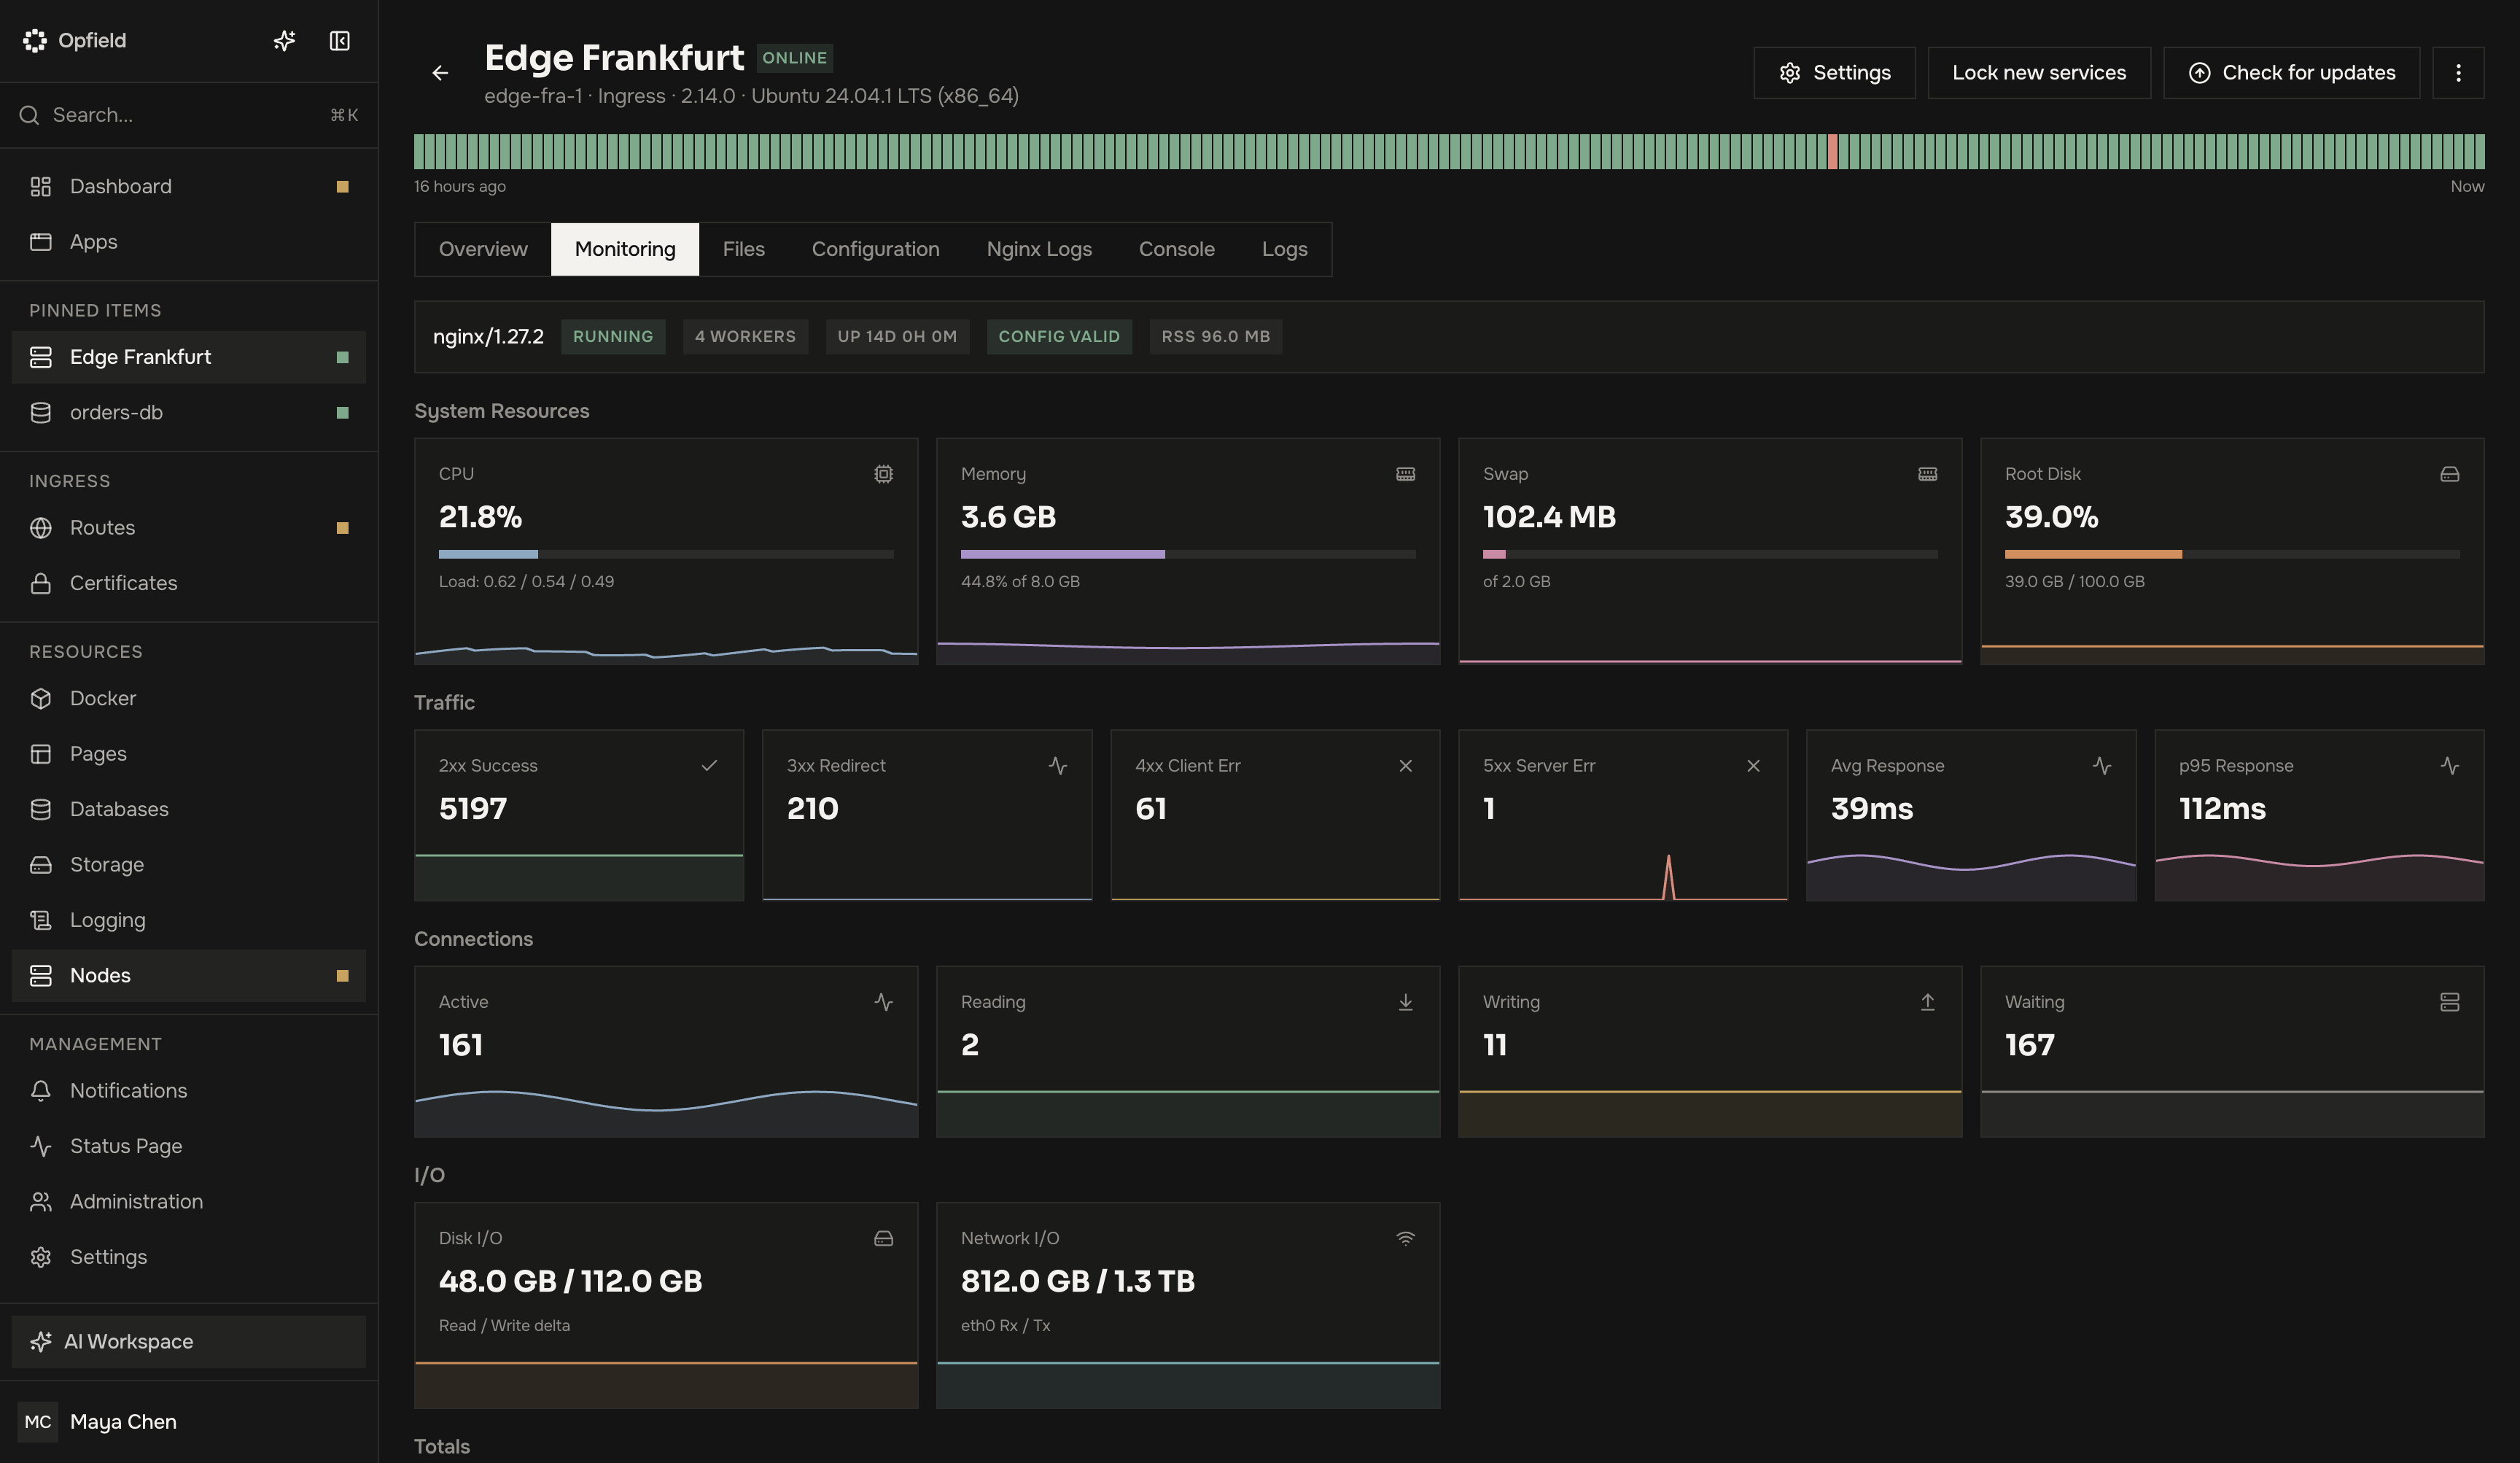
La página de detalle del nodo es el lugar principal para inspeccionar la conectividad, las capacidades que no coinciden, la preparación para actualizaciones, la presión sobre los recursos, las operaciones recientes y el último estado sincronizado. Una instantánea desactualizada puede servir para un diagnóstico de solo lectura, pero nunca autoriza un cambio.
Identidad y estado
Sección titulada «Identidad y estado»Al crear un nodo, primero se crea una identidad duradera pendiente. El token de registro generado es de un solo uso y está ligado a esa identidad. Un registro correcto instala un certificado de daemon y convierte el nodo en un host gestionado en línea; eliminar el registro y volver a crearlo crea intencionadamente una identidad diferente.
Opfield distingue varios tipos de estado:
- estado deseado: lo que los operadores configuraron en Opfield;
- estado informado: el último informe de inventario y capacidades reconocido por el daemon;
- estado en ejecución: el estado en vivo de los servicios y las operaciones activas;
- instantánea en caché: el último modelo de lectura conocido, que se usa cuando un nodo no está disponible durante un breve periodo.
Los datos en caché sirven para el diagnóstico, pero nunca autorizan un cambio. Las acciones que necesitan el estado actual del host fallan de forma segura cuando el daemon está desconectado o sus capacidades están desactualizadas.
Límites de los roles
Sección titulada «Límites de los roles»| Rol | Es responsable de |
|---|---|
| Ingress | configuración de nginx, certificados, Routes, telemetría de acceso y de tráfico |
| Docker | contenedores, Deployments, Compose, imágenes, volúmenes, redes, builds y endpoints de migración |
| Build Worker | ejecución aislada de builds desde Git y admisión de artefactos |
| Storage | motores gestionados de PostgreSQL, clave-valor y ClickHouse, almacenamiento de objetos SeaweedFS gestionado (los clústeres MinIO heredados siguen funcionando), imágenes de almacenamiento, endpoints directos, telemetría de bases de datos y trabajos de copia de seguridad y restauración; se rechazan las cargas de trabajo genéricas |
| Monitoring | métricas del host sin acceso al ciclo de vida de las cargas de trabajo |
| Relay | transporte autenticado de los nodos y túneles privados compatibles |
No trates las etiquetas de rol como algo cosmético. Cada instalador, perfil de daemon, conjunto de capacidades, artefacto de actualización y límite de permisos es distinto.
Comprobaciones operativas
Sección titulada «Comprobaciones operativas»Para cada nodo de producción, confirma que:
- el nombre de host y el nombre visible identifican el host físico correcto;
- las direcciones de servicio son accesibles desde los pares previstos;
- la versión y el estado de compatibilidad están al día;
- las capacidades esperadas están en buen estado, y no solo presentes;
- hay alertas de presión de almacenamiento, memoria, CPU y disco;
- los procedimientos de actualización y recuperación están documentados;
- el nodo pertenece a la carpeta y a los ámbitos de permisos correctos.
Propiedad y límite de confianza
Sección titulada «Propiedad y límite de confianza»El registro del nodo y el certificado del daemon son identidades del plano de control, no alias de una dirección IP. Reinstalar un host bajo un nodo recién creado produce un nuevo propietario aunque el nombre de host y la dirección no cambien. Los recursos, las concesiones, las operaciones y el inventario en caché asociados a la identidad anterior no se transfieren solo porque el sustituto tenga el mismo nombre visible.
Protege el host según su rol. Un nodo Docker o Storage puede acceder a datos de aplicaciones, un nodo Ingress guarda material privado de certificados, un Build Worker procesa entradas de repositorios potencialmente hostiles y un Relay transporta el control autenticado y flujos privados. Evita combinar roles en un mismo host cuando eso eliminaría un límite de seguridad o de fallo. Opfield presenta roles separados porque sus privilegios y su radio de impacto operativo son distintos.
El daemon inicia la sesión gestionada hacia fuera, de modo que la operación rutinaria no requiere exponer un puerto general de administración del daemon. Los parches del host, la política del cortafuegos, la sincronización horaria, el estado del almacenamiento y la ruta de red hacia Relay siguen siendo responsabilidad tuya. Opfield informa de estas dependencias y rechaza los cambios de forma segura cuando fallan; no repara el host ni la red.
Aceptación tras el registro
Sección titulada «Aceptación tras el registro»No coloques recursos de producción en un nodo justo cuando su estado pase a en línea. Espera a una instantánea nueva de inventario y métricas y verifica después las capacidades de rol y las direcciones de servicio esperadas. Ejecuta una operación de bajo riesgo propia del rol: valida la configuración de nginx en Ingress, inspecciona una carga de trabajo de prueba en Docker, ejecuta un build de prueba admitido en Build Worker o confirma la comprobación previa del almacenamiento en Storage.
Registra la ruta de recuperación antes de la asignación: cómo llegar al host, dónde están los logs del daemon y del servicio del rol, qué identidad o datos persistentes deben sobrevivir y qué recursos dependientes hay que verificar tras un reinicio.
Continúa con Roles de los nodos e instalación antes del registro y con Actualizaciones de nodos y comportamiento sin conexión antes del despliegue en producción.