

Bases de datos gestionadas
Las bases de datos gestionadas proporcionan instancias de PostgreSQL, clave-valor y ClickHouse controladas por Opfield en nodos Storage. Los nuevos almacenes clave-valor gestionados ejecutan Valkey y funcionan con clientes de Redis; consulta Almacenes clave-valor. Opfield es responsable del ciclo de vida del recurso y de la configuración deseada; el nodo Storage es responsable del motor en ejecución y de su entorno de ejecución local. Por tanto, un nodo desconectado no borra la configuración registrada de la instancia, y la recuperación empieza por el estado del nodo, no por cambios manuales en el motor.
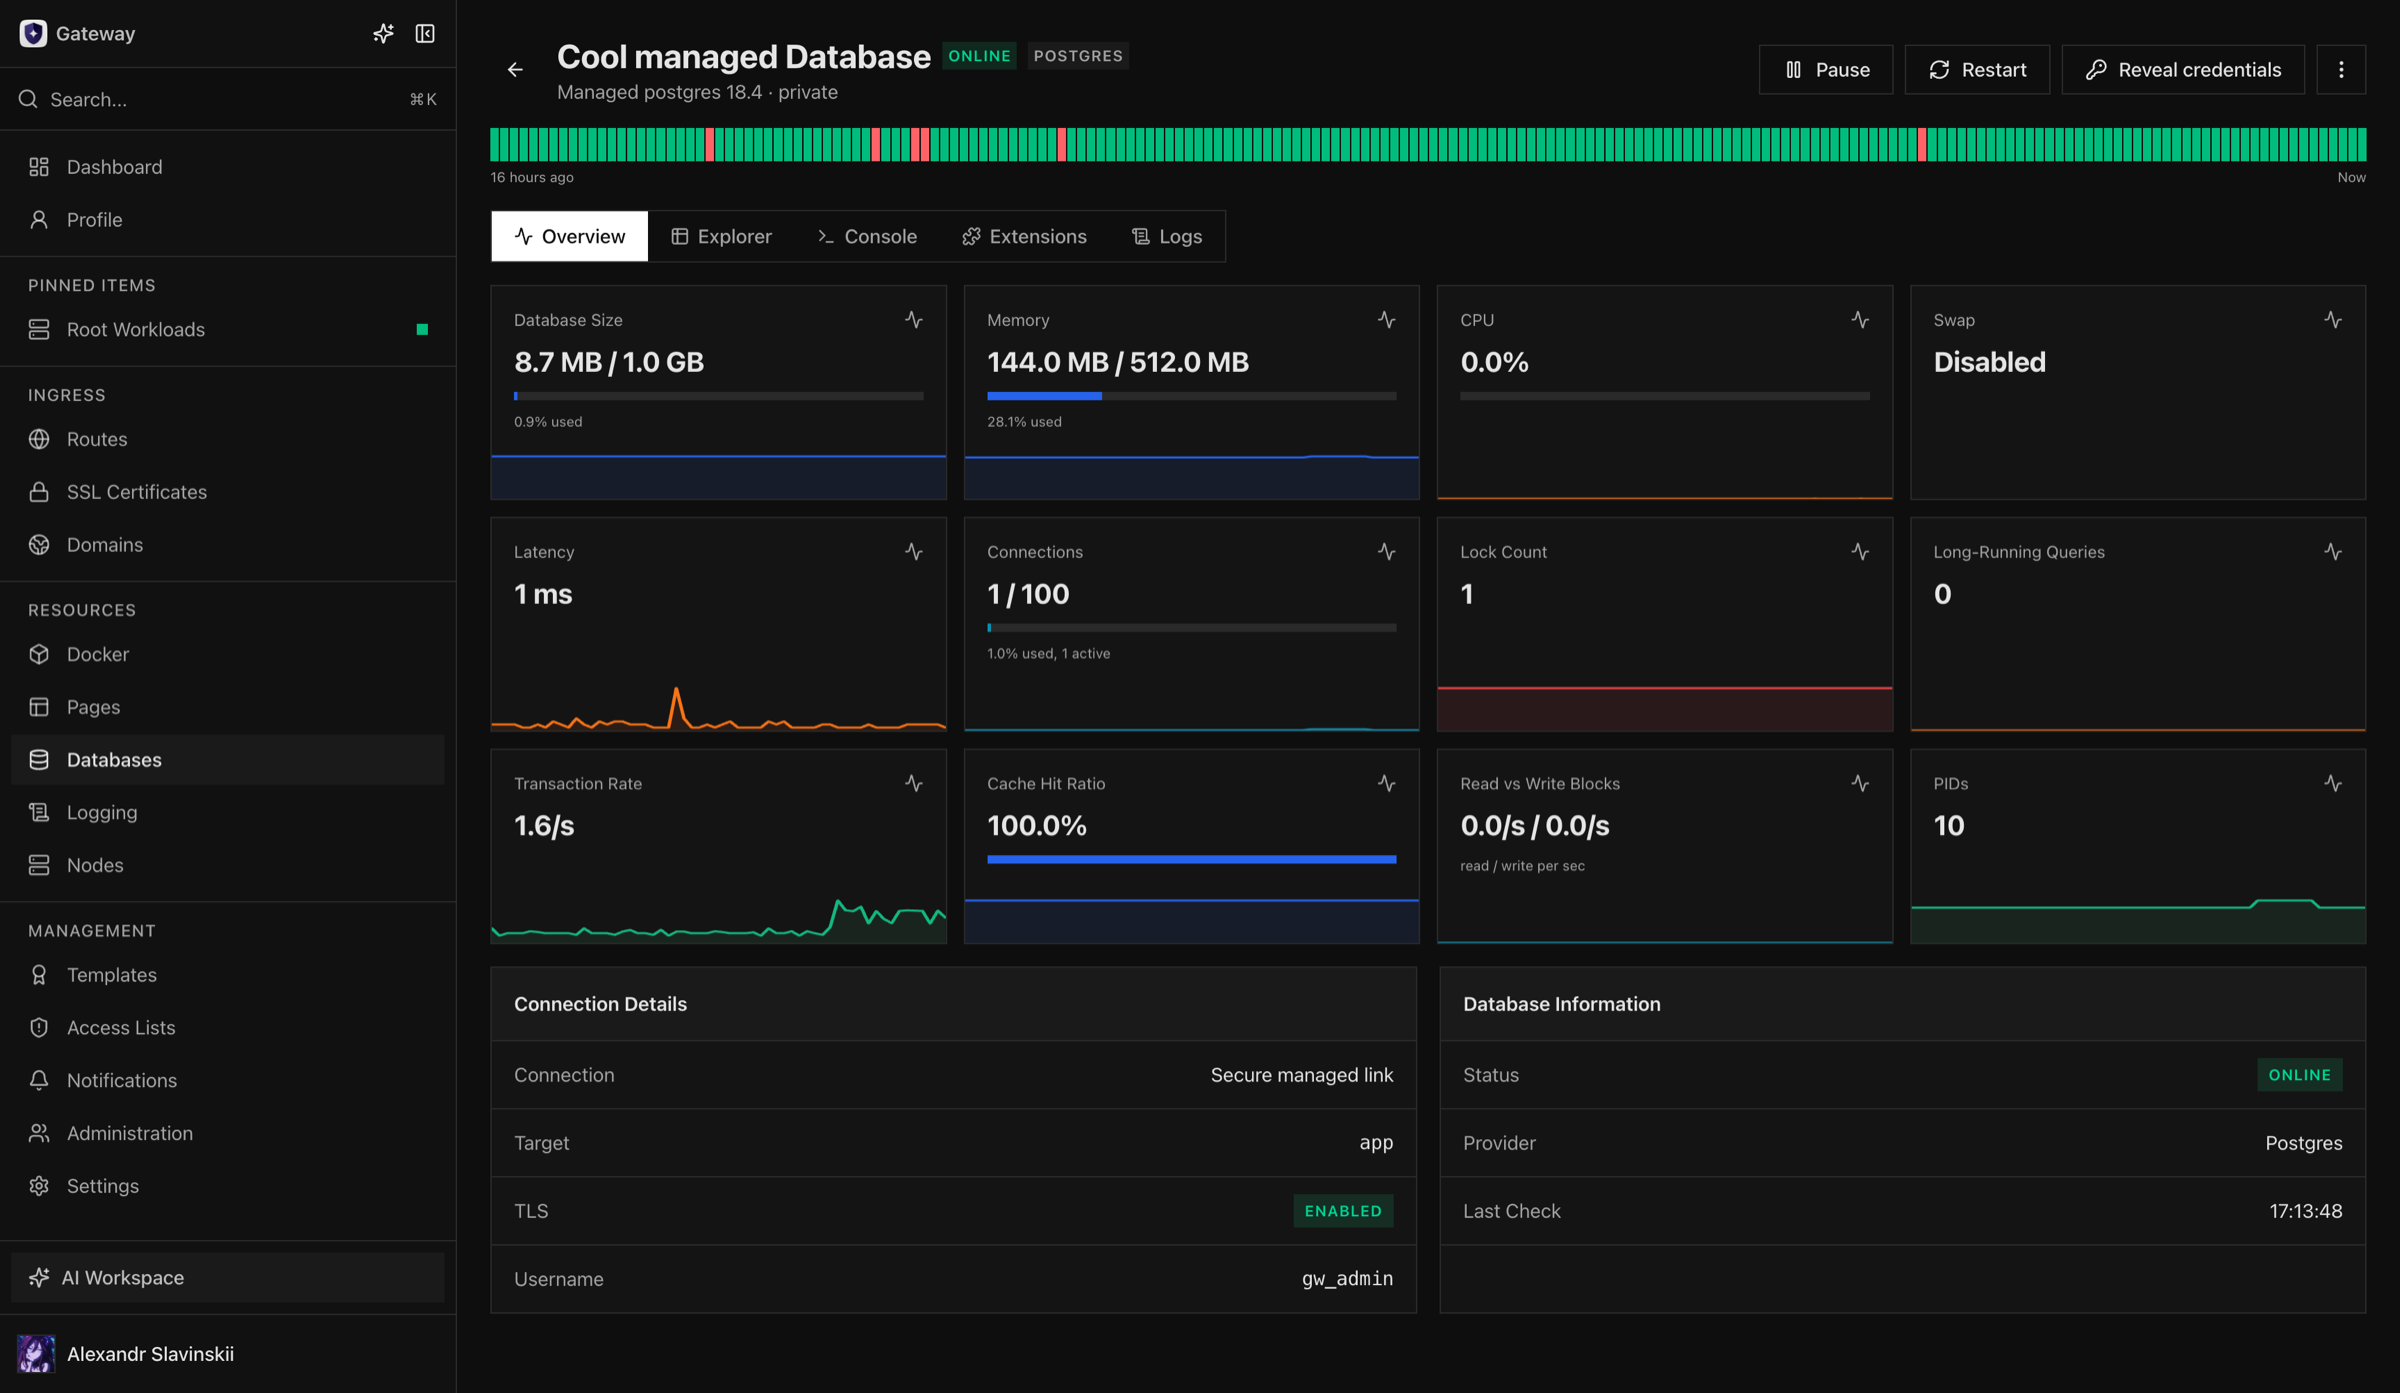
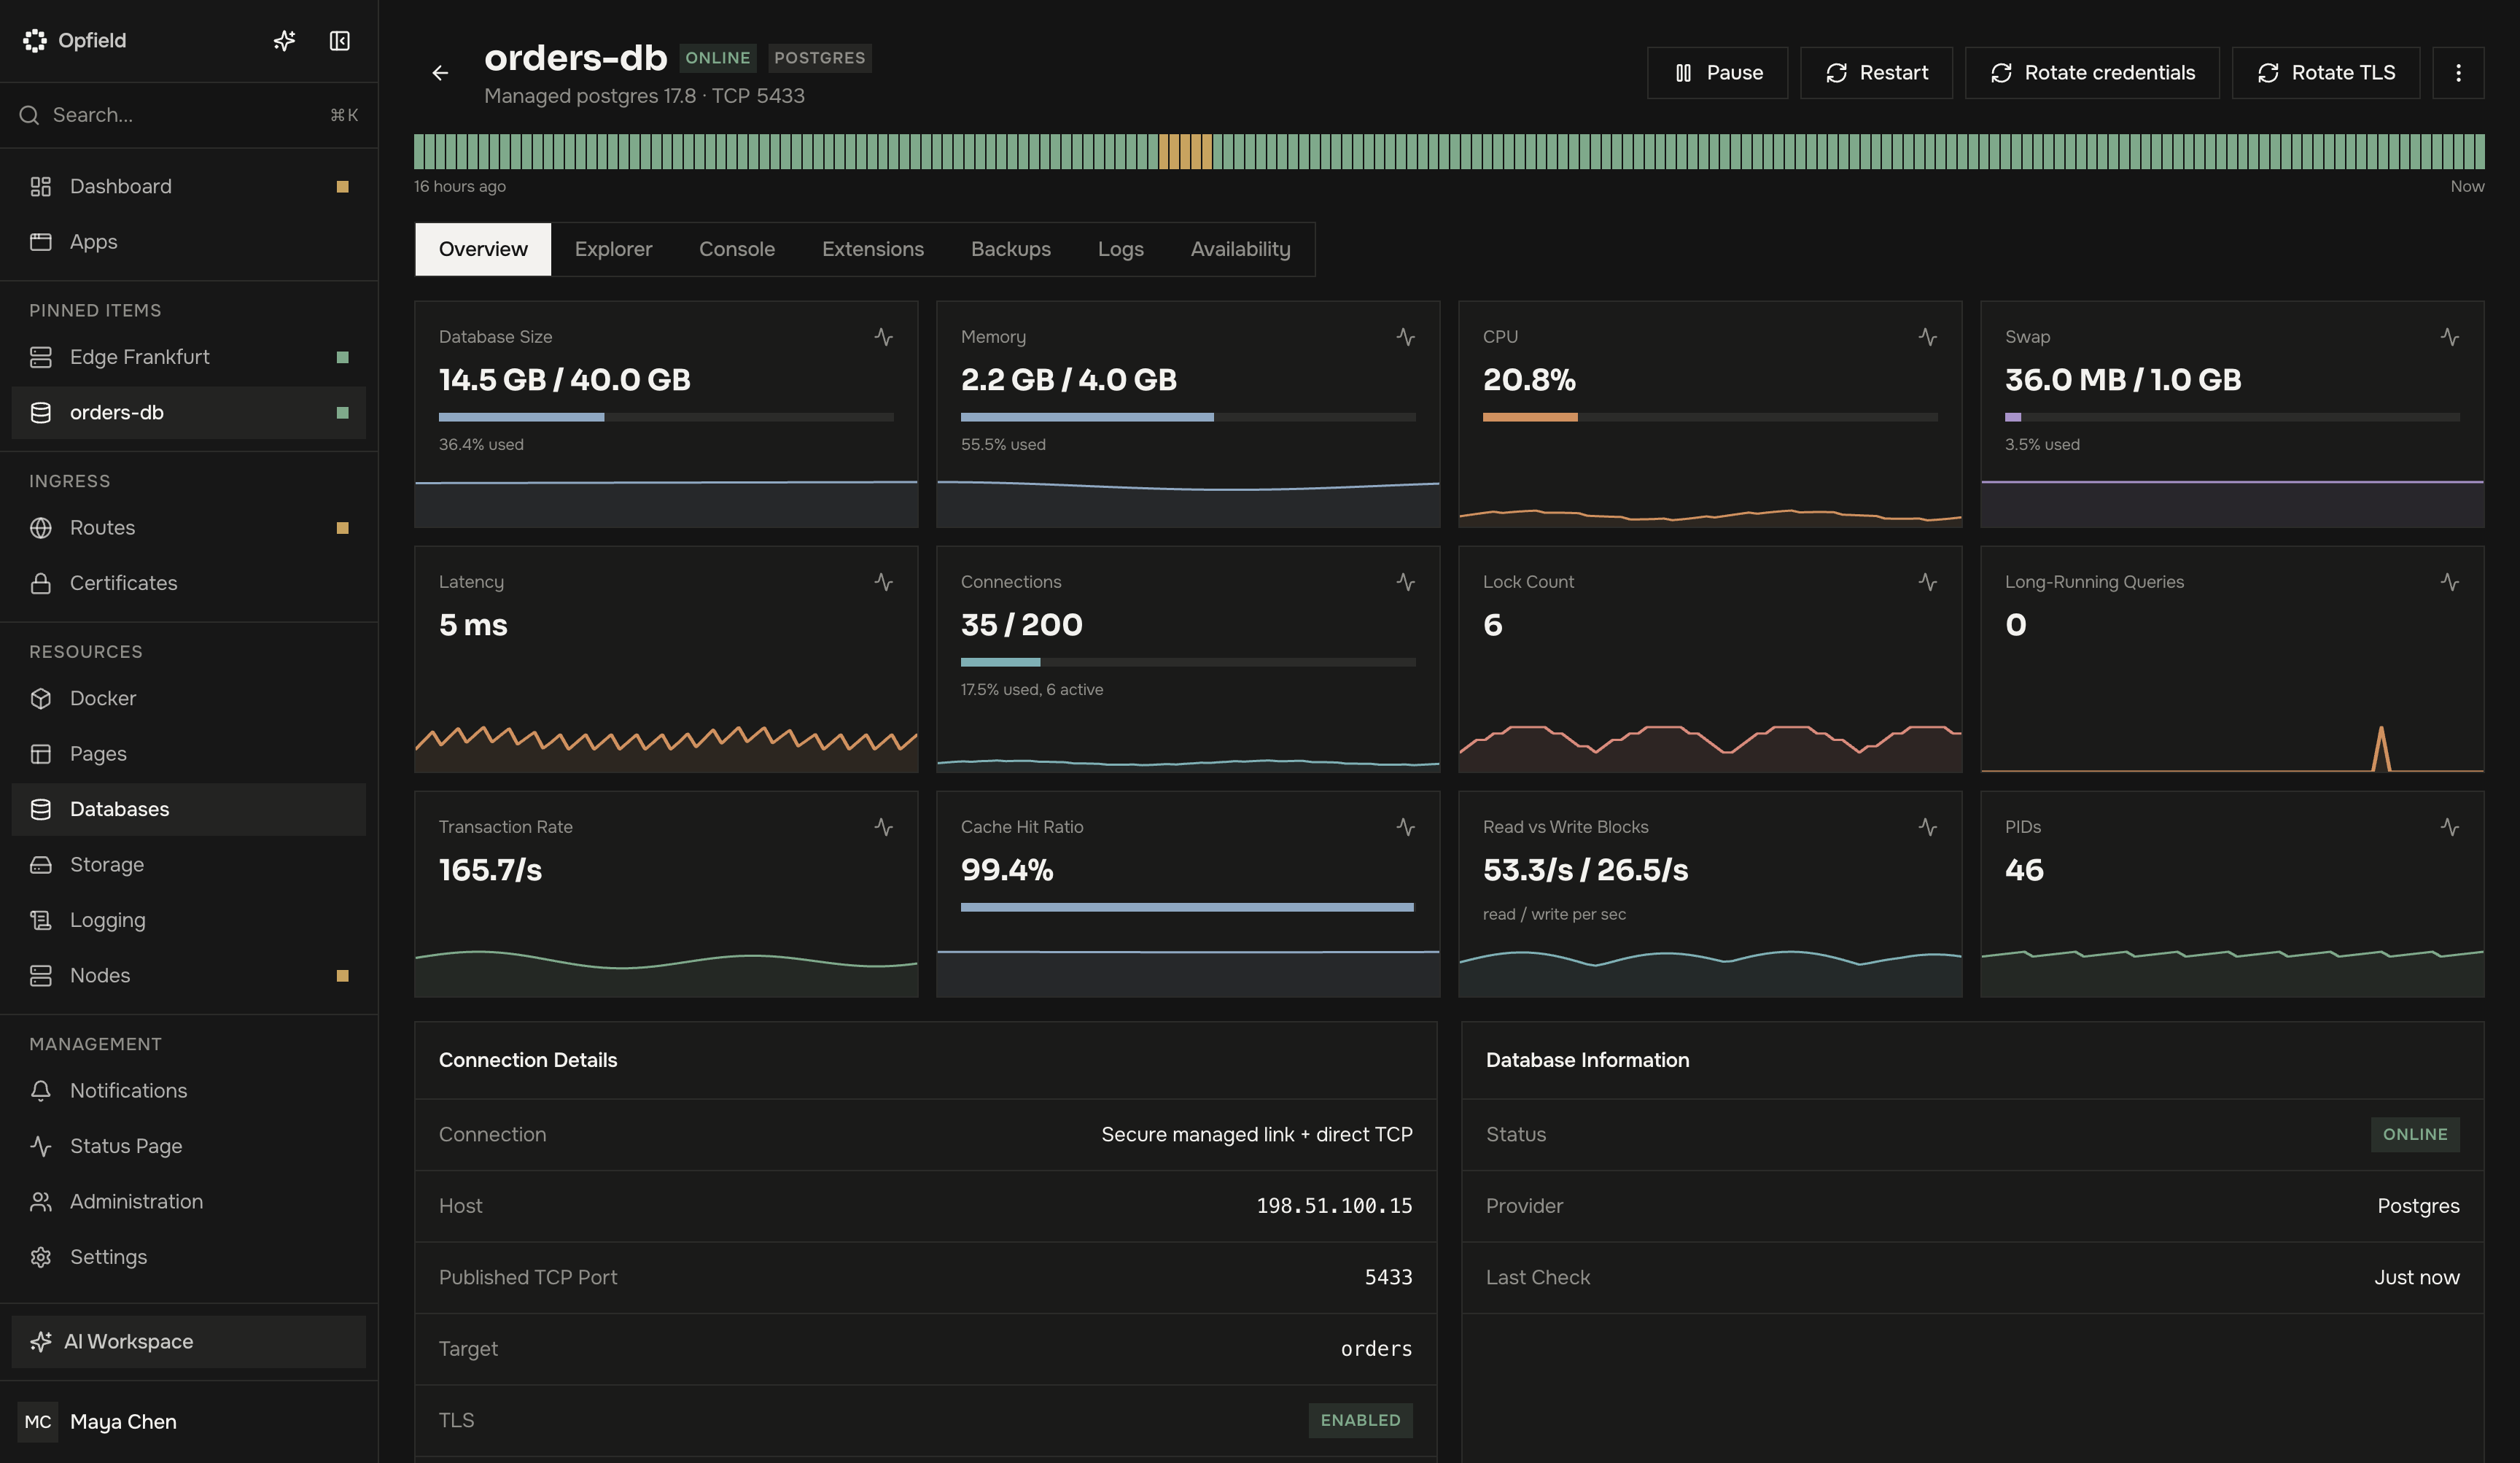
Una instancia gestionada se crea en un formulario, se ejecuta en el nodo Storage que elijas y llega a las cargas de trabajo mediante vinculaciones privadas. Una base de datos gestionada se ejecuta en un solo servidor salvo que la hagas disponible en varios. Opfield la aprovisiona, la configura, la supervisa y hace sus copias de seguridad de forma programada; la política de copias de seguridad y las pruebas de restauración, la elección de la versión del motor y la planificación de la capacidad siguen siendo responsabilidad tuya. Para una comparación con las conexiones externas, consulta Bases de datos gestionadas y externas de un vistazo. Crear una base de datos gestionada requiere Personal o superior.
Límite de capacidades
Sección titulada «Límite de capacidades»| Capacidad | Lo que proporciona Opfield | Lo que sigue siendo responsabilidad tuya |
|---|---|---|
| Aprovisionamiento | Una instancia acotada de PostgreSQL, clave-valor o ClickHouse en un nodo Storage, o en 2 a 5 con disponibilidad | Capacidad de los nodos, ubicación, durabilidad del almacenamiento y versión aprobada del motor |
| Configuración y ciclo de vida | Configuración deseada, pausa y reanudación, reinicio, reintento de un aprovisionamiento fallido, redimensionamiento de CPU, memoria, swap y almacenamiento (el almacenamiento solo puede crecer), máximo de conexiones de PostgreSQL, ajustes de los motores clave-valor y ClickHouse, extensiones de PostgreSQL, publicación, logs, monitorización y flujos de retirada | Ventanas de cambio, compatibilidad de las aplicaciones, verificación independiente y decisión de reversión |
| Acceso de las aplicaciones | Vinculaciones privadas gestionadas y publicación TLS directa opcional | Comportamiento de los clientes, uso con el mínimo privilegio, confianza en los certificados y política de rotación de credenciales |
| Copias de seguridad | Copias de seguridad de bases de datos nativas programadas en una conexión de almacenamiento, y restauración en una base de datos gestionada nueva, en Personal y superiores | Política de copias de seguridad, destino fuera del host, retención, cifrado del destino y pruebas de restauración periódicas |
| Recuperación a un punto en el tiempo | No se proporciona automáticamente | Arquitectura de copia continua con WAL, AOF o específica del motor y procedimiento de recuperación probado |
| Replicación y conmutación por error automática | En Business y Enterprise: un primario y de 1 a 4 copias en otros nodos Storage, conmutación por error automática con testigos o un par manual; consulta Bases de datos y almacenamiento en varios servidores | Elegir la durabilidad frente a la ventana de pérdida de datos indicada, los hosts de los testigos y el comportamiento de reconexión de las aplicaciones |
| Cambios de versión del motor | A través de la API y de MCP, un paso a una versión más reciente del catálogo del mismo motor: PostgreSQL dentro de su versión mayor, Valkey y ClickHouse a la siguiente versión del catálogo; el contenedor se recrea con la nueva imagen y conserva sus datos. Un almacén clave-valor creado antes de la 2.12 puede pasar una vez de Redis a Valkey | Elegir la versión y, para otra versión mayor de PostgreSQL, restaurar una copia de seguridad en una instancia nueva |
| Recuperación ante desastres | Opfield conserva la definición del recurso; los datos de aplicación perdidos solo vuelven desde una copia de seguridad | Ubicación de recuperación independiente, copias de los datos, claves, recuperación de DNS y red, y RPO/RTO declarados |
Las bases de datos gestionadas no tienen recuperación a un punto en el tiempo, y la conmutación por error automática requiere Business o Enterprise. Una base de datos que necesite recuperación a un punto en el tiempo puede ejecutarse en una plataforma que la proporcione y registrarse en Opfield como conexión externa, con las mismas comprobaciones de estado, Explorer, Console y copias de seguridad. Un recurso de Opfield en buen estado no demuestra por sí solo que los datos estén disponibles.
Antes del aprovisionamiento
Sección titulada «Antes del aprovisionamiento»Necesitas permiso para crear la base de datos y usar el nodo Storage seleccionado. Confirma el motor y la versión compatible, la disponibilidad del nodo, los requisitos de almacenamiento y de memoria, el plan de copias de seguridad y si el acceso de clientes externos es realmente necesario. Elige la capacidad de forma conservadora y deja margen para la sobrecarga del motor, el trabajo temporal y las operaciones de recuperación.
Mantén desactivada la publicación directa salvo que un cliente externo tenga una necesidad documentada. La conectividad privada de las aplicaciones debe usar vinculaciones. Activar la publicación directa es un cambio intencionado en la exposición de la instancia y no abre automáticamente el cortafuegos del host.
Lee el catálogo de versiones seleccionado en la interfaz antes de aprovisionar. Las versiones compatibles son un contrato operativo: no fijes una versión de parche arbitraria del proyecto original ni mantengas un motor obsoleto solo porque su contenedor todavía arranca. Para los datos de producción, documenta el camino de actualización y la compatibilidad de restauración antes de elegir una versión. Cada versión del catálogo está fijada a un digest de imagen. El nodo Storage la descarga primero del mirror de Opfield en GitHub Container Registry (ghcr.io) y, como alternativa, de Docker Hub, verificando el mismo digest en ambos casos.
Aprovisiona y verifica
Sección titulada «Aprovisiona y verifica»- Elige el motor, la versión compatible, el nodo Storage, el tamaño del almacenamiento y el perfil de memoria.
- Revisa la postura de red privada por defecto y cualquier ajuste de publicación directa.
- Crea la instancia y sigue la operación de aprovisionamiento hasta el final.
- Espera a que la instancia muestre Ready antes de crear una vinculación de aplicación o de depender de Explorer, Console o las métricas.
- Verifica el estado del motor, los logs recientes, la información del almacenamiento y un camino de conexión permitido.
La primera verificación debe incluir una escritura adecuada al motor y una lectura posterior a través de la misma identidad que usará el cliente real. Para PostgreSQL, verifica la base de datos y el esquema previstos; para un almacén clave-valor, verifica el acceso a las claves esperado y la política de persistencia; para ClickHouse, verifica la ruta de base de datos y tabla de destino y el comportamiento tanto de las consultas como del almacenamiento. Elimina los datos sintéticos después de la prueba.
Los fallos de aprovisionamiento suelen deberse a nodos no disponibles, límites de capacidad, la preparación del almacenamiento, ajustes del motor no compatibles o el arranque del motor. Lee el resultado de la operación antes de reintentar. Los reinicios o los intentos de recreación repetidos pueden ocultar el fallo original y no sustituyen a corregir los requisitos previos de almacenamiento o de configuración.
Cambia una instancia existente
Sección titulada «Cambia una instancia existente»Pausar y reanudar controlan el cómputo conservando los datos de la base de datos. Cuenta con que las acciones normales de estado, métricas, Explorer y Console no estarán disponibles mientras la instancia esté pausada. Reiniciar provoca una breve interrupción del servicio y debe anunciarse a las aplicaciones dependientes cuando no puedan volver a conectarse automáticamente.
Redimensiona solo dentro de las restricciones del motor y del almacenamiento. El almacenamiento puede crecer, pero no reducirse, y el redimensionamiento y los cambios de ajustes no están disponibles mientras la instancia está pausada. No se puede guardar un cambio mientras todavía se está aplicando uno anterior. El historial de monitorización sobrevive a un periodo en el que la base de datos o su nodo estuvieron desconectados. Haz una copia de seguridad antes de un cambio de capacidad importante, sigue la operación de redimensionamiento y verifica después la información del almacenamiento y el comportamiento de la aplicación.
Para PostgreSQL, Maximum connections en Database Settings fija max_connections: 100 por defecto, entre 20 y 10 000 (postgresConfig.maxConnections en la API y en manage_managed_database update). Guardar un valor nuevo recrea el contenedor. El mismo valor es la capacidad de los enlaces de la base de datos; consulta Capacidad de los enlaces y pools de conexiones.
Opfield mantiene interna la credencial de propietario del motor y nunca la devuelve a los usuarios. Reveal credentials y la rotación de credenciales se aplican a un usuario de acceso directo aparte que existe mientras la publicación TCP está activada; la rotación afecta a los clientes directos que lo usan. Las vinculaciones de las aplicaciones conservan sus propias identidades del motor y no se ven afectadas.
Para un cambio planificado, registra un estado previo: versión del motor, uso del almacenamiento, número de conexiones, vinculaciones actuales, estado de publicación, última copia de seguridad correcta y responsable de la operación. Tras el cambio, compara las mismas señales y ejecuta una consulta real de un cliente. Si la operación falla, conserva su Task y los logs del motor antes de reintentar; los reintentos a ciegas repetidos pueden sustituir las pruebas útiles por fallos secundarios.
Publicación y retirada
Sección titulada «Publicación y retirada»La publicación TCP directa es opcional y debe tratarse como un contrato aparte con clientes externos. Puedes activarla, desactivarla o cambiarla después del aprovisionamiento; Opfield vuelve a crear el contenedor de la base de datos y conserva sus datos, así que planifica una breve interrupción. Verifica el cliente previsto, la confianza en el certificado, las credenciales y el camino de red después de activarla. Desactivar la publicación elimina ese camino directo, pero no elimina la instancia ni las vinculaciones privadas de las cargas de trabajo.
La eliminación es destructiva. Elimina o migra primero las vinculaciones dependientes (Opfield rechaza la eliminación mientras existan vinculaciones o mientras se esté ejecutando una copia de seguridad o una restauración de la base de datos), decide cuánto tiempo deben conservarse las copias de seguridad y confirma que ningún cliente externo necesita todavía la publicación directa. Eliminar la base de datos desactiva y elimina sus políticas de copias de seguridad; su historial de copias y los artefactos del almacenamiento se conservan, y Backups of deleted databases, en la página Databases, los restaura en una base de datos nueva. Después, Opfield elimina la instancia gestionada y su estado de identidad y de almacenamiento relacionado a través de su ciclo de vida. No elimines a mano usuarios del motor, objetos de red internos ni almacenamiento para intentar acelerar la eliminación; deja que termine la operación registrada para que la limpieza siga siendo coherente.
Detalles para operadores: almacenamiento y TLS directo
Sección titulada «Detalles para operadores: almacenamiento y TLS directo»El nodo Storage debe superar la misma comprobación previa de almacenamiento que usa el entorno de ejecución. Las bases de datos gestionadas por Opfield usan imágenes ext4 de tamaño fijo preasignadas en lugar de un volumen de Docker sin límites. Los hosts VM y físicos normalmente proporcionan las capacidades de loop y de montaje necesarias. Los hosts en contenedores requieren compatibilidad explícita con dispositivos loop y montajes; un host no compatible se rechaza en lugar de recurrir silenciosamente a un aislamiento de almacenamiento más débil. Cada base de datos gestionada ocupa un dispositivo loop mientras existe, así que dimensiona el pool de dispositivos loop de un nodo Storage en LXC para cada instancia, cada miembro de almacenamiento de objetos y cada copia de seguridad simultánea; consulta Requisitos previos de los nodos Storage y Docker. Eliminar una instancia libera su montaje y su dispositivo loop antes de que Opfield informe de la eliminación, y el daemon repara por sí solo los dispositivos que dejaron versiones anteriores.
Es el daemon de Docker, no la política de reinicio de Docker, quien arranca los motores gestionados en un nodo Storage. Tras un reinicio, monta primero la imagen de disco de cada instancia y solo entonces arranca el motor, de modo que un motor nunca escribe en el directorio de montaje vacío del sistema de archivos raíz. Un motor que se detiene inesperadamente se vuelve a arrancar con un retraso creciente de hasta un minuto; una instancia que detuviste sigue detenida. Un nodo Storage arranca aunque falte uno de sus contenedores gestionados; esa base de datos aparece como no en ejecución.
La publicación directa usa TLS nativo. Opfield emite el certificado del servidor desde su CA de bases de datos aparte y guarda la clave privada en almacenamiento propiedad del daemon, fuera de la imagen de la base de datos. PostgreSQL y los almacenes clave-valor exponen un endpoint TLS; ClickHouse expone HTTPS y su endpoint TLS nativo. Los clientes deben confiar en la CA de bases de datos que se muestra y seguir la política documentada de nombre de host o de huella del certificado en lugar de desactivar la verificación.
Opfield renueva automáticamente el certificado del servidor, con una comprobación cada hora: cuando han transcurrido dos tercios de su tiempo de vida, quedan 30 días o menos, falta una dirección de servicio configurada o el certificado procede de otra CA. El motor recarga el nuevo certificado en su sitio (PostgreSQL, los almacenes clave-valor y ClickHouse siguen sirviendo), y Opfield pasa a él solo cuando la instancia lo sirve. La CA de bases de datos no cambia, así que los clientes que confían en ella siguen funcionando. Connection Details, en la base de datos, muestra una fila discreta TLS Certificate con la fecha de caducidad y “renewed automatically” o “needs attention”. Solo aparece un aviso en la página cuando se necesita atención (la renovación falló, quedan 7 días o menos, el certificado renovado todavía no está cargado, la renovación espera al daemon del nodo o la CA limita el tiempo de vida), con el motivo, la fecha de caducidad y Rotate now cuando puedes rotarlo. El Dashboard también muestra una advertencia que enumera cada base de datos gestionada y cada almacenamiento gestionado cuyo certificado necesita atención y que puedes ver.
Rotate TLS certificate lo renueva de inmediato con la misma recarga en su sitio. Solo se usa un reinicio cuando lo permites, cuando quedan 7 días o menos o cuando el daemon del nodo todavía no puede recargar certificados. Mientras la renovación sigue fallando, Opfield genera el evento de notificación Managed Service Certificate Renewal Failed. API: GET /api/databases/managed/{id}/certificate y POST /api/databases/managed/{id}/rotate-certificate con allowRestart opcional; MCP y asistente: acciones certificate_status y rotate_certificate de manage_managed_database.
Las conexiones propias de Opfield para Explorer, Console, la monitorización y las copias de seguridad llegan a una instancia gestionada a través del túnel de Relay con autenticación mutua. Para PostgreSQL con TLS, Opfield verifica además el certificado del servidor con la CA de bases de datos de Opfield y la identidad emitida para esa instancia. Los almacenes clave-valor y ClickHouse usan texto sin cifrar dentro del túnel.
Las vinculaciones de las aplicaciones llegan a la instancia a través del mismo túnel. Para PostgreSQL con TLS, un cliente de una vinculación que se conecta con la URI sencilla de la vinculación sigue funcionando: el daemon del nodo Storage abre la conexión TLS con PostgreSQL y verifica el certificado de la instancia, mientras que un cliente que pide TLS por sí mismo mantiene TLS de extremo a extremo. Consulta Vinculaciones de bases de datos para aplicaciones.
Decisiones de recuperación
Sección titulada «Decisiones de recuperación»- Si el nodo está desconectado, restablece el nodo y la conexión del daemon antes de cambiar la definición de la base de datos.
- Si el aprovisionamiento falló antes de que el motor estuviera listo, corrige el problema de almacenamiento, capacidad o versión notificado y usa la acción de reintento concreta.
- Si el motor está listo pero los clientes fallan, separa el TLS de la publicación directa, el estado de la vinculación, las credenciales y la configuración de la aplicación antes de reiniciar nada.
- Si el almacenamiento está dañado o los datos son incoherentes, detén la experimentación con el ciclo de vida y restaura en un destino separado y verificado desde una copia de seguridad a nivel de motor.
Pausar no es una copia de seguridad y reiniciar no es una reversión. Opfield puede conciliar el estado de la infraestructura, pero no puede revertir una migración de esquema de la aplicación ni reconstruir datos de los que nunca se hizo una copia de seguridad.