

Обзор наблюдаемости
Opfield наблюдает за состоянием контура управления, нод и рабочих нагрузок, поведением Ingress, базами данных, сборками, использованием Inference и событиями безопасности.
В продукте нет единого универсального экрана наблюдаемости. Операционная модель распределена между Dashboard и страницами Nodes, Routes, рабочих нагрузок, баз данных, сборок, Tasks, уведомлений, аудита и страниц состояния. По этим сигналам технический руководитель должен ответить на три вопроса: затронуты ли клиенты, кто должен действовать и как будет подтверждено восстановление?
Цель — не максимальный объём телеметрии, а небольшой набор надёжных сигналов с назначенными владельцами, полезным сроком хранения и проверенным путём от обнаружения до восстановления клиентского сервиса. Opfield предоставляет сигналы продукта и инфраструктуры; владельцы сервисов по-прежнему определяют бизнес-критерии успеха, целевые показатели уровня обслуживания (SLO), эскалацию и мониторинг внешних зависимостей.
Используйте состояние ресурсов для текущей картины, метрики — для тенденций, журналы — для диагностики, долговременные Tasks — для хода операций, уведомления — для действий, страницы состояния — для коммуникации с клиентами, аудит — для атрибуции, SIEM — для внешнего анализа безопасности.
Проектируйте оповещения вокруг устойчивого влияния на клиентов и значимых переходов состояния. Не отправляйте каждое низкоуровневое событие в канал уведомлений.
Определите владение и успех
Заголовок раздела «Определите владение и успех»Для каждого важного сервиса назначьте владельца бизнеса, технического владельца, канал дежурной команды и владельца коммуникации с клиентами. Определите доступность с точки зрения пользователя, а не одного внутреннего индикатора процесса. Route может выглядеть работоспособным, пока приложение или база возвращает непригодные ответы; нода может быть online, пока один клиентский путь не работает.
Используйте SLO — измеримую цель надёжности во времени, — чтобы решать, какие условия требуют оповещений, а какие должны оставаться только на Dashboard или в отчётах. В самом оповещении укажите ожидаемую проверку восстановления. Успех достигнут, когда клиентский путь снова работает, сигнал восстановился, а временная мера устранена.
Типы сигналов
Заголовок раздела «Типы сигналов»| Сигнал | Лучшее применение | Распространённая ошибка |
|---|---|---|
| Состояние | Текущая готовность сервиса | Считать один зелёный индикатор доказательством сквозной доступности |
| Метрики | Ёмкость и тенденции | Оповещать о каждом кратковременном всплеске |
| Журналы | Подробная диагностика | Отправлять секреты или неограниченную полезную нагрузку |
| Tasks | Долговременный ход операции | Считать принятую Task уже завершённой |
| События | Переходы состояния ресурсов | Использовать объём событий как метрику состояния |
| Аудит | Кто и что изменил | Заменять операционные журналы записями аудита |
| Уведомления | Действие оператора | Пересылать каждое информационное событие |
| Страницы состояния | Коммуникация с клиентами | Публиковать приватную топологию или необработанные ошибки |
Создайте операционное представление
Заголовок раздела «Создайте операционное представление»- Начните с видимых клиентам Routes и бизнес-сервисов.
- Сопоставьте каждому сервису его Ingress, рабочую нагрузку, базу данных, хранилище и внешние зависимости.
- Определите сигнал состояния и SLO, отражающие влияние на клиентов.
- Добавьте оповещения о ёмкости ресурсов с устойчивыми окнами.
- Направьте срочные события в назначение с ответственным владельцем.
- Создавайте публичный компонент состояния только для информации, которую должны видеть клиенты.
- Проверяйте сбой и восстановление, а не только доставку уведомления.
Процесс диагностики
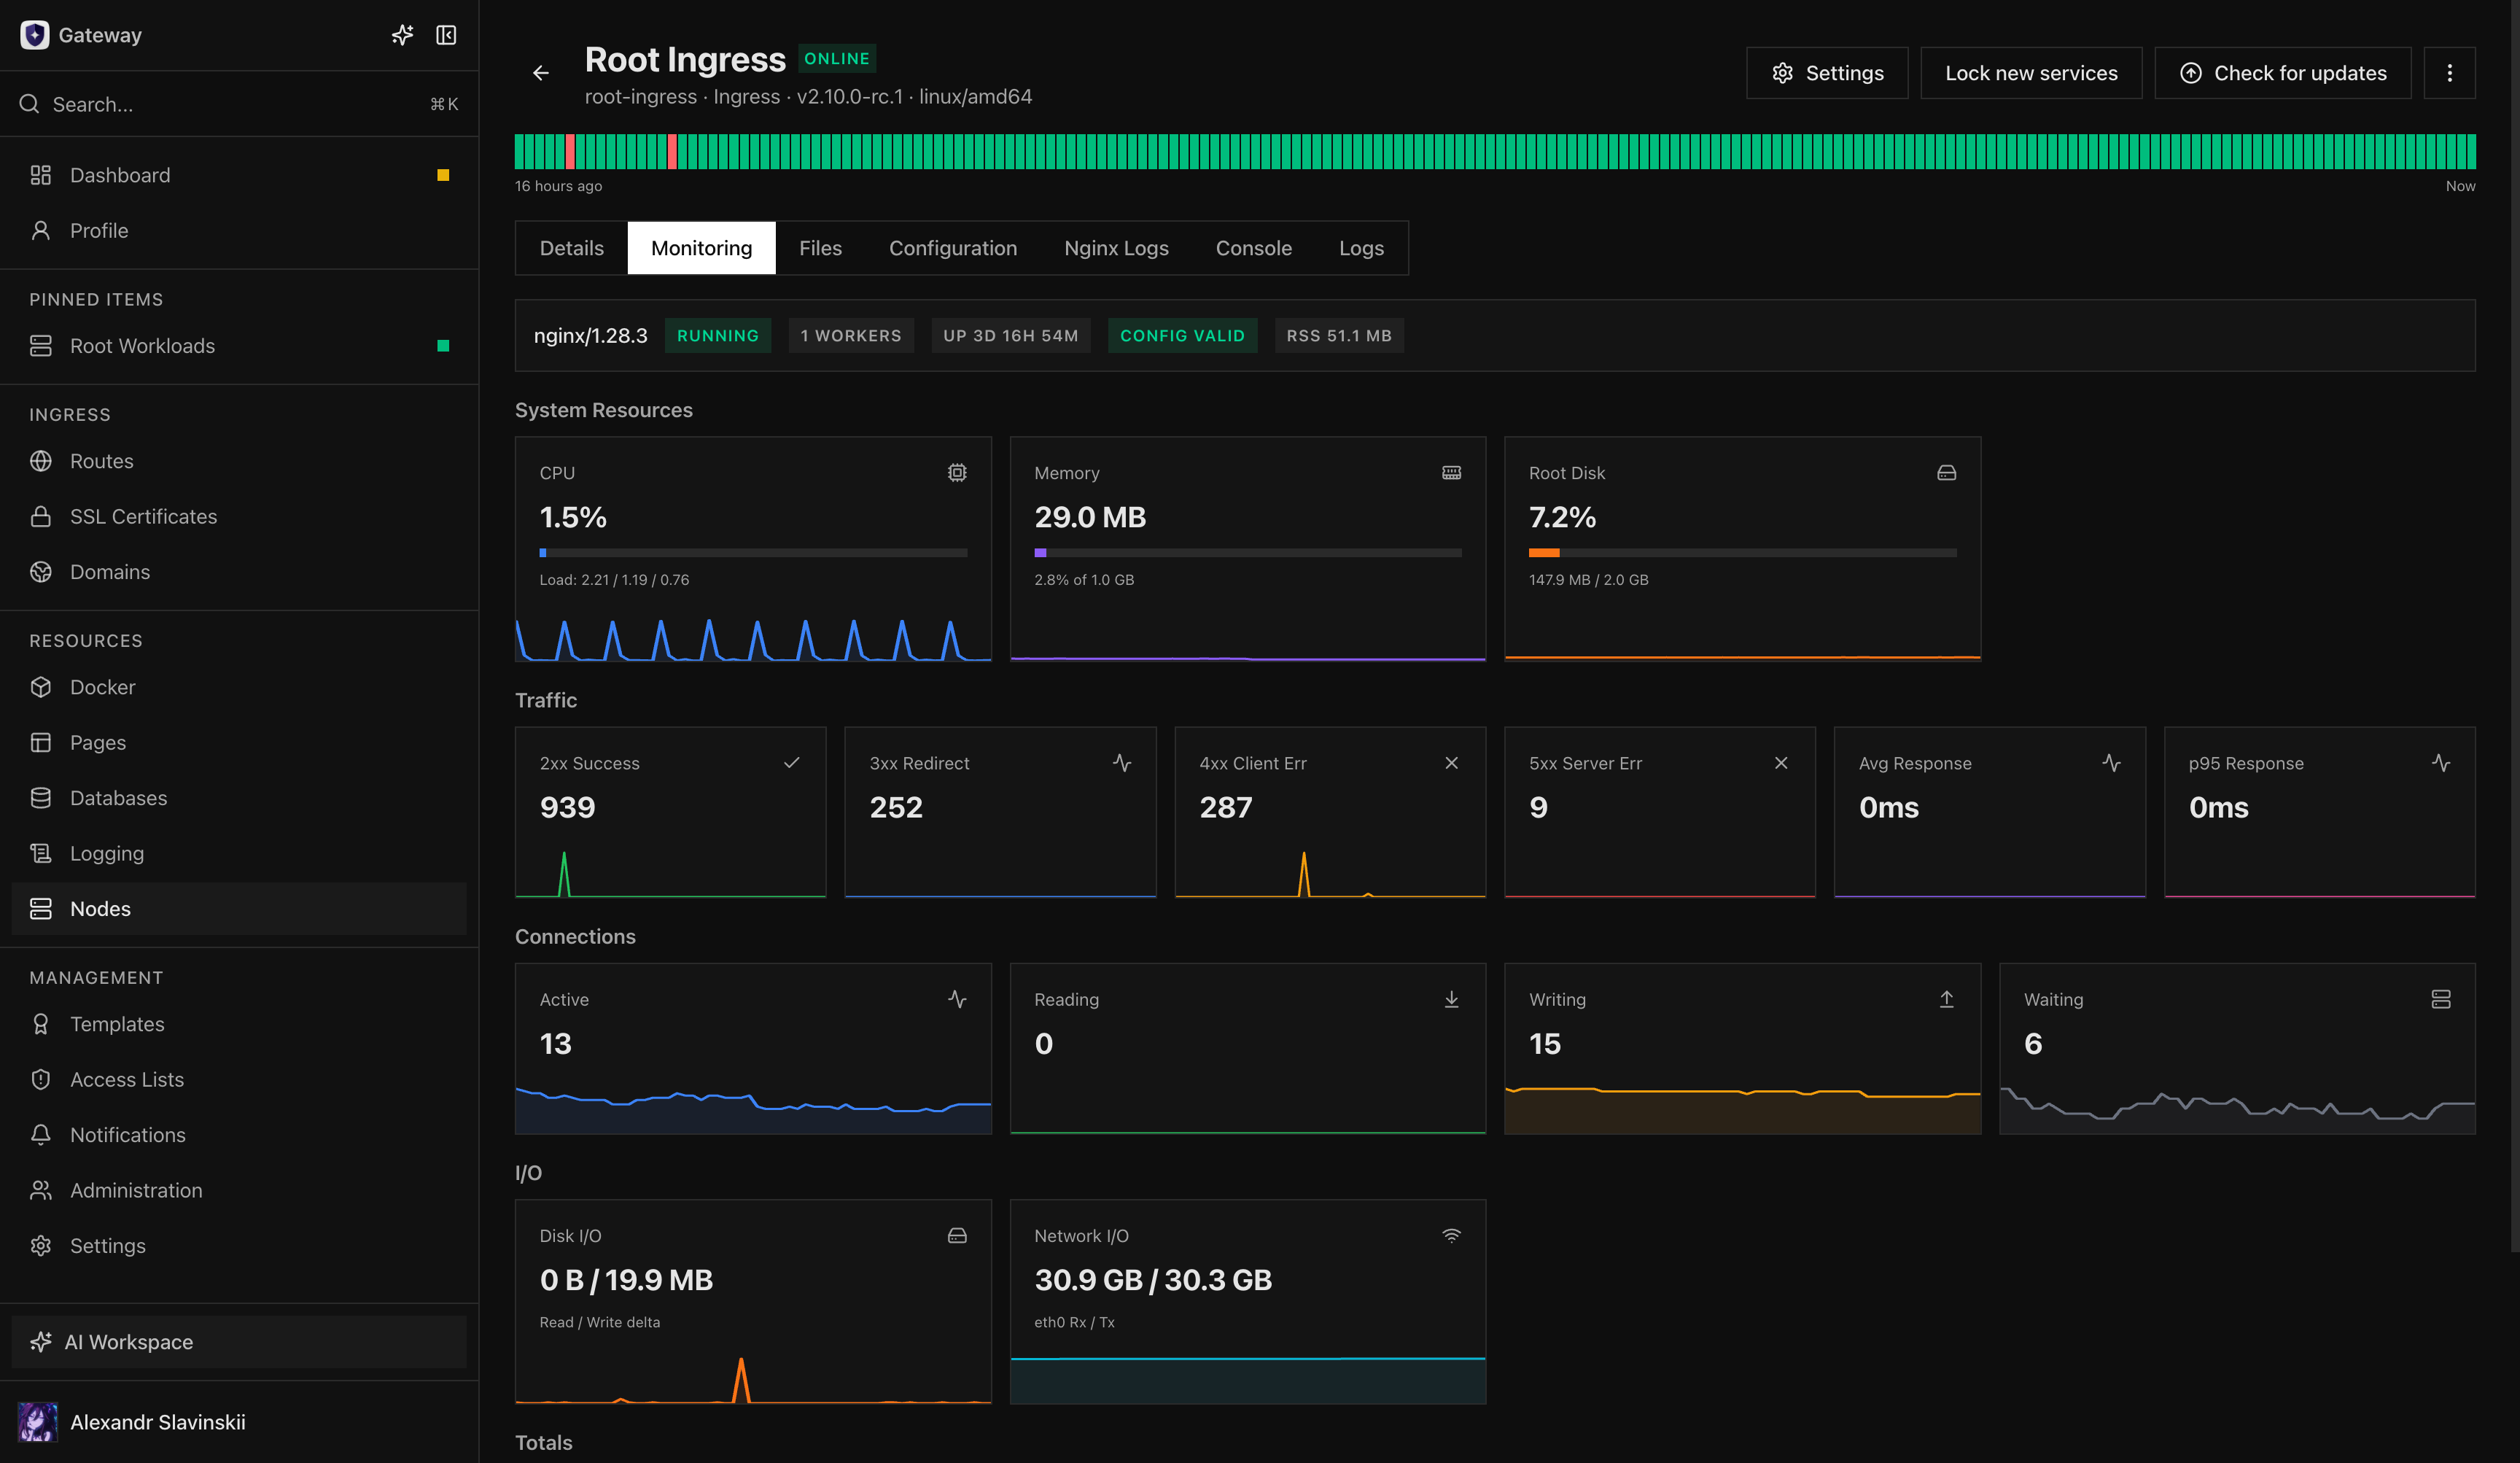
Заголовок раздела «Процесс диагностики»Начните оценку с Dashboard, затем откройте затронутый ресурс. Сравните текущее состояние с последними метриками, Tasks, событиями и журналами. Сопоставляйте данные по стабильному идентификатору ресурса, операции, запроса и времени. Если состояние основано на кэшированном снимке, восстановите соединение ответственной ноды до изменения ресурса.
Мониторинг баз данных запускается в фоне после первоначальной настройки Opfield и при готовности управляемой базы; открывать страницу базы не требуется. При первом посещении страница может недолго ждать историю или первый реальный снимок, но не должна показывать работоспособное состояние при отсутствии данных.
Во время инцидента двигайтесь от затронутого клиентского пути внутрь: публичные DNS и TLS, Route и Ingress, рабочая нагрузка, приватные зависимости, хранилище и внешние сервисы. По Tasks отличайте принятую операцию от завершённой. Используйте аудит для понимания изменений конфигурации, но не вместо журналов среды выполнения.
Диагностика Opfield
Заголовок раздела «Диагностика Opfield»Opfield сообщает и о собственном состоянии. AI-ассистент и клиенты MCP читают его через manage_gateway_diagnostics:
snapshot: процессор, память, нагрузка и диск тома данных хоста; память, процессор и задержка цикла событий процесса бэкенда; доступность, задержка, пул соединений, размер и долгие запросы PostgreSQL и Redis; контейнеры стека (app,postgres,redis,relay,registry) с состоянием, проверкой работоспособности, перезапусками, процессором и памятью; сбойные фоновые задачи; задержка API и ошибки 5xx;history: поминутные значения за 48 часов;requestsиjobs: число запросов, p95 и ошибки 5xx по маршрутам API, а также последний запуск и ошибки каждой фоновой задачи;logs: журналы контейнеров приложения, PostgreSQL, Redis, Relay и реестра, а также последнего запуска обновления Opfield.
Для чтения состояния нужно diagnostics:view, для чтения журналов — diagnostics:logs, которое его включает. Оба права есть у встроенных административных групп; пользовательским группам их нужно выдать. Показатели процессора относятся к тем процессорам, которые Opfield действительно может использовать, а kernelCpuCount показывает их число по данным ядра. Память берётся из ограничения cgroup контейнера, если оно задано (memoryScope: "cgroup"), а иначе — по данным ядра ("kernel"), как в госте LXC, собственное ограничение которого из контейнера приложения не видно.
Правила оповещений в категории Opfield следят за теми же сигналами: процессором, памятью и диском хоста, памятью бэкенда, задержкой цикла событий, долей ошибок 5xx и задержкой p95 API, задержкой и ожиданием пула PostgreSQL, задержкой Redis. Они также срабатывают, когда PostgreSQL или Redis недоступны, когда контейнер стека остановлен или неработоспособен и когда фоновая задача раз за разом завершается ошибкой. Оповещение о недоступности PostgreSQL отправляется напрямую в вебхуки своих правил, пока PostgreSQL недоступен, и записывается, когда он вернётся. /health проверяет PostgreSQL через отдельное соединение, поэтому загруженный пул соединений не выглядит как сбой.
Проверяйте саму наблюдаемость
Заголовок раздела «Проверяйте саму наблюдаемость»Наблюдайте за всем путём мониторинга: свежестью нод, состоянием ClickHouse, доставкой очереди уведомлений, публикацией страниц состояния, возрастом исходящей очереди SIEM и хранением данных. Система наблюдаемости, которая незаметно перестала собирать данные, должна создавать отдельное предупреждение платформы.
Храните телеметрию достаточно долго для восстановления хода инцидента, но применяйте явные ограничения срока и объёма. Не используйте журналы как неконтролируемый архив данных.
Для операторов: устаревшие и противоречивые сигналы
Заголовок раздела «Для операторов: устаревшие и противоречивые сигналы»У каждого решения о состоянии есть временная метка и владелец. При отключении ноды её последний снимок может устареть; восстановите ответственную ноду до изменения ресурсов по старой информации. Если предупреждение на боковой панели и страница ресурса расходятся, сравните их источник, временную метку и правило агрегации вместо безусловного доверия одному цвету.
Считайте отсутствующие данные неизвестным, а не работоспособным состоянием. Проверьте, что сбор продолжается, временная метка нового образца меняется, ClickHouse доступен там, где ожидаются структурированные журналы, очереди уведомлений опустошаются, а публичные обновления состояния публикуются. После исправления повторите исходную сквозную проверку и задокументируйте слепую зону, которая задержала обнаружение.